


TOT思维树
854 字
4 分钟
TOT思维树
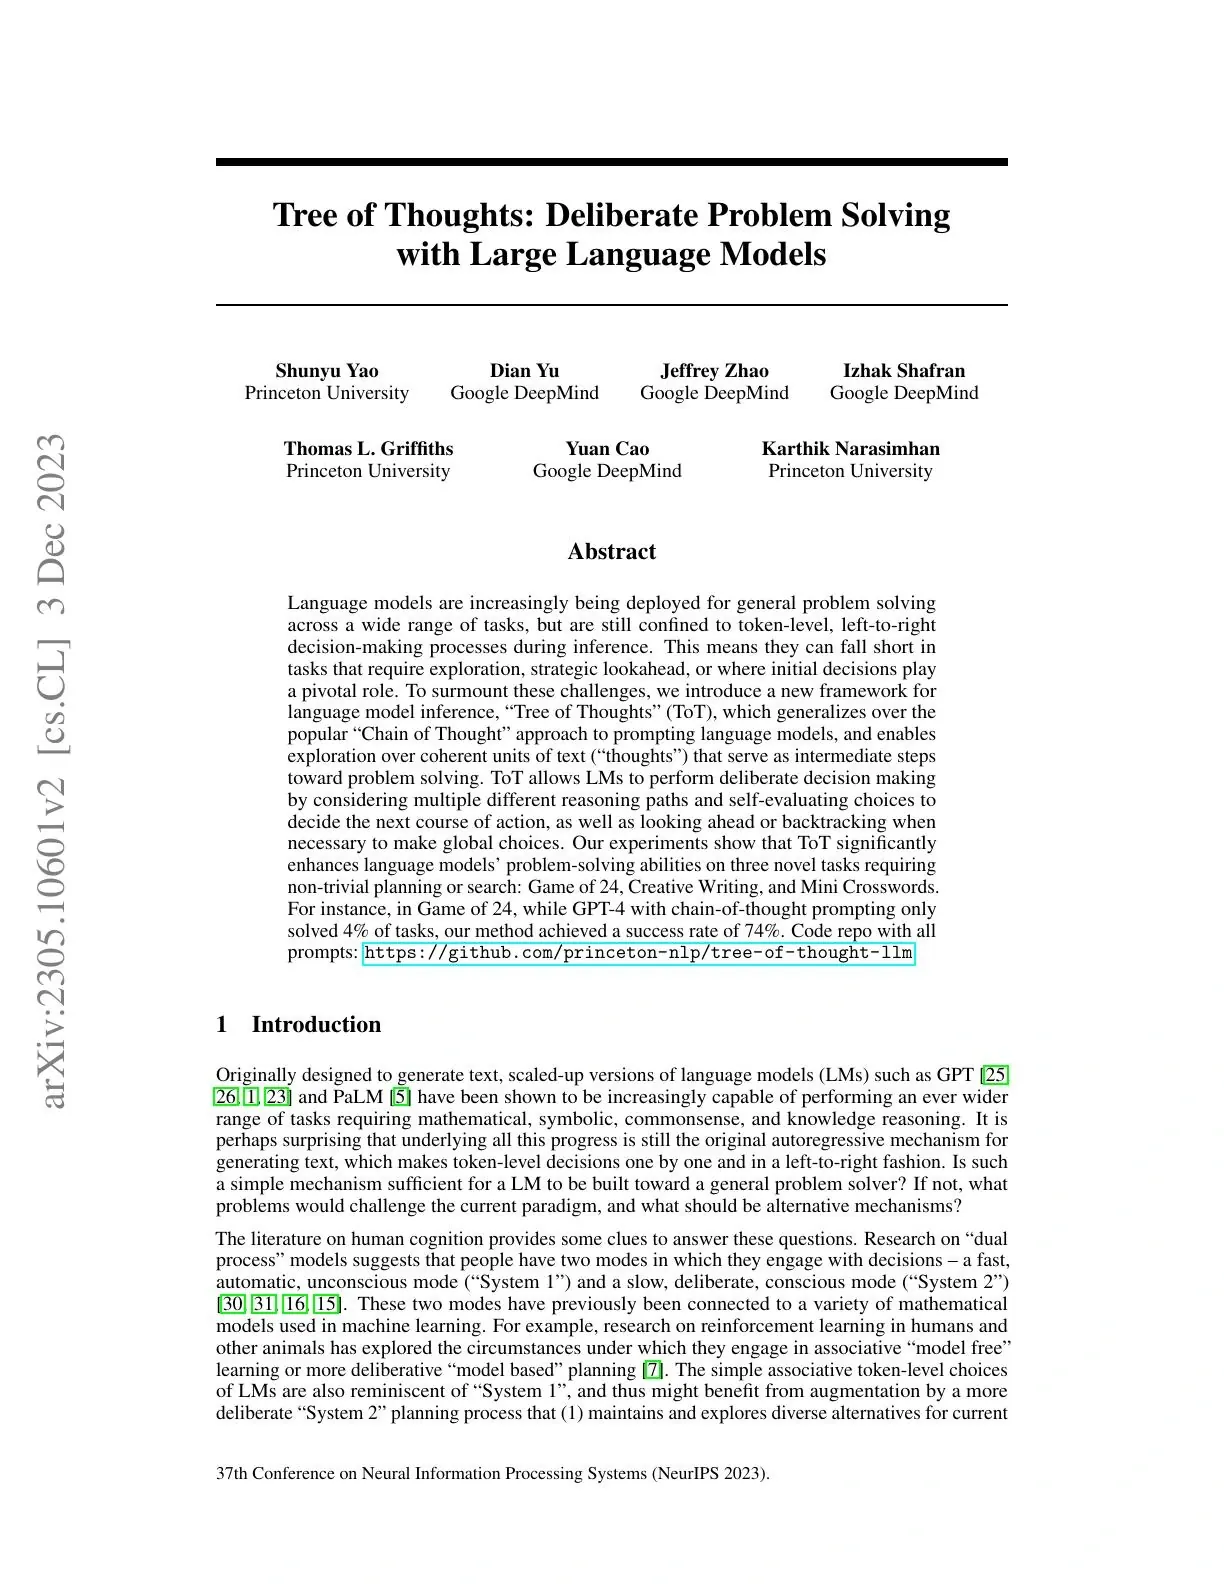
论文核心内容提炼:Tree of Thoughts: Deliberate Problem Solving with Large Language Models
作者:Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L. Griffiths, Yuan Cao, Karthik Narasimhan (Princeton University & Google DeepMind)
发表:NeurIPS 2023 (Oral)
1. 研究问题
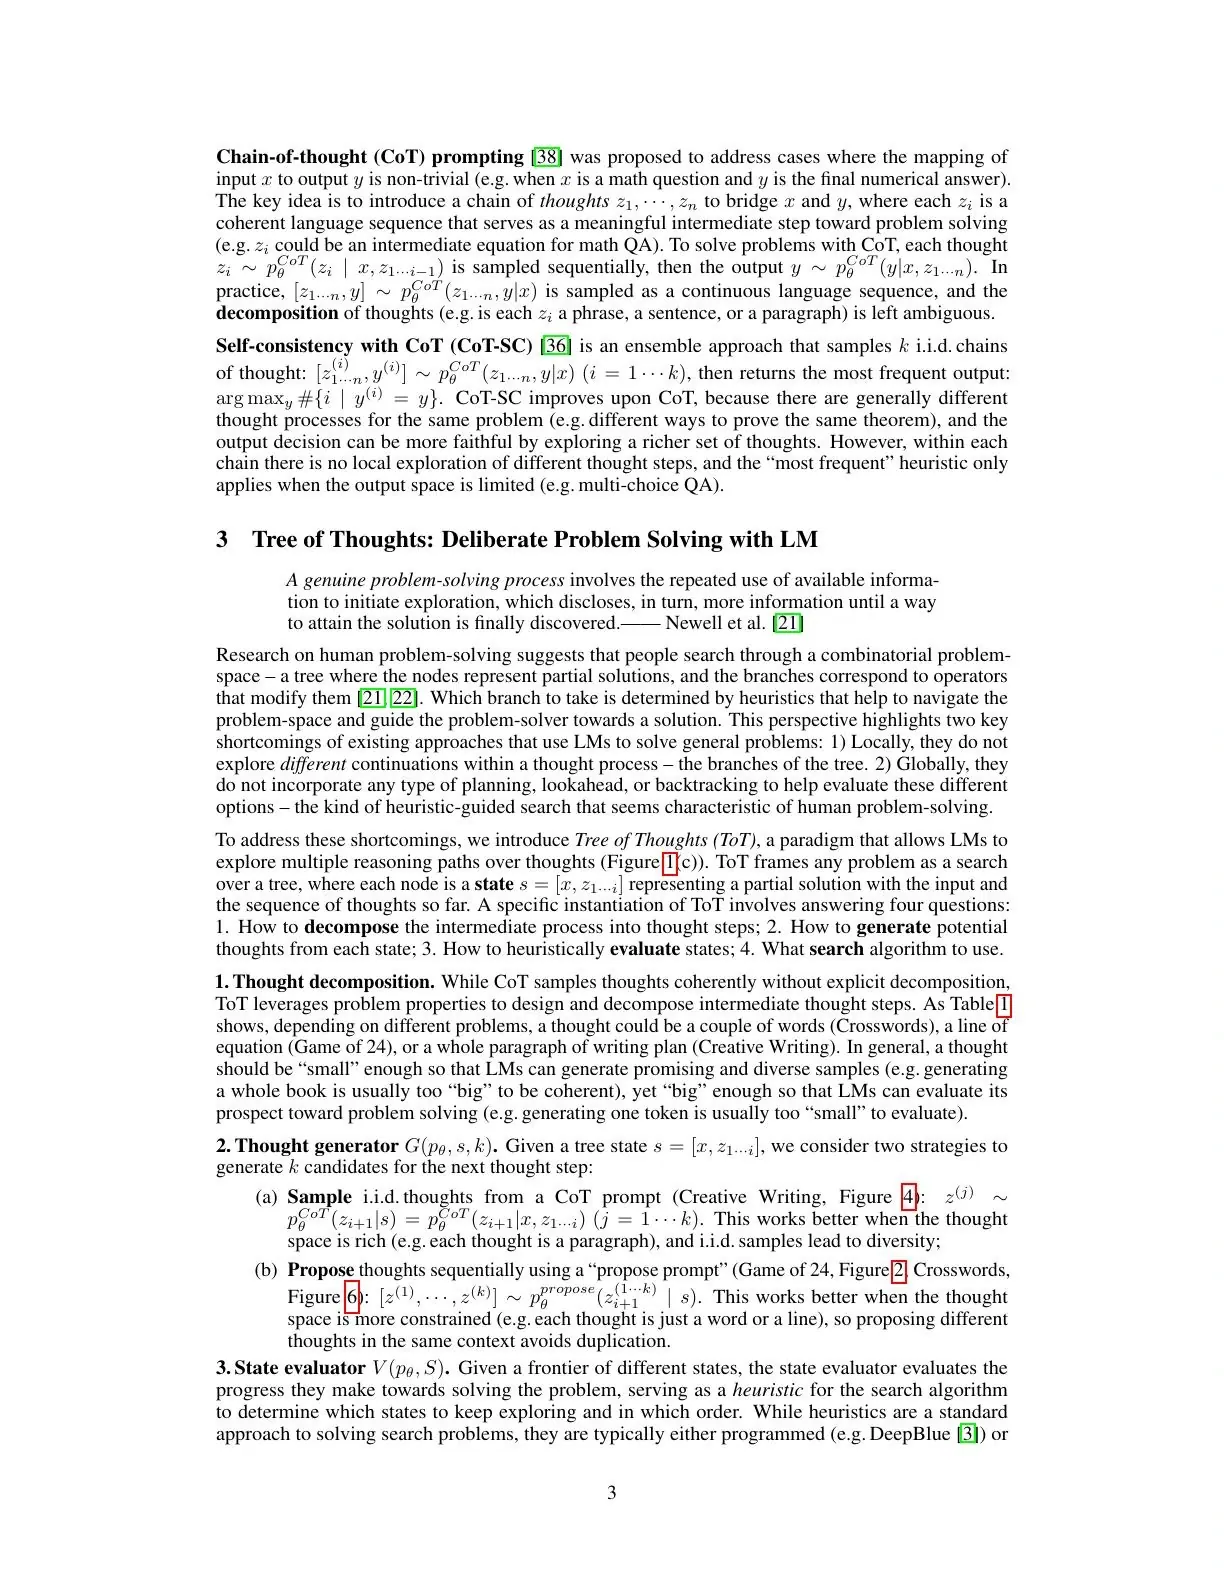
- 标准语言模型推理(包括 CoT 和 Self-Consistency)本质是线性、从左到右的 token 生成,难以探索、前瞻与回溯。
- 本文引入“系统2”式规划,让模型在树状问题空间中搜索,而不是只走一条直线。
2. 核心方法:思维树(Tree of Thoughts, ToT)
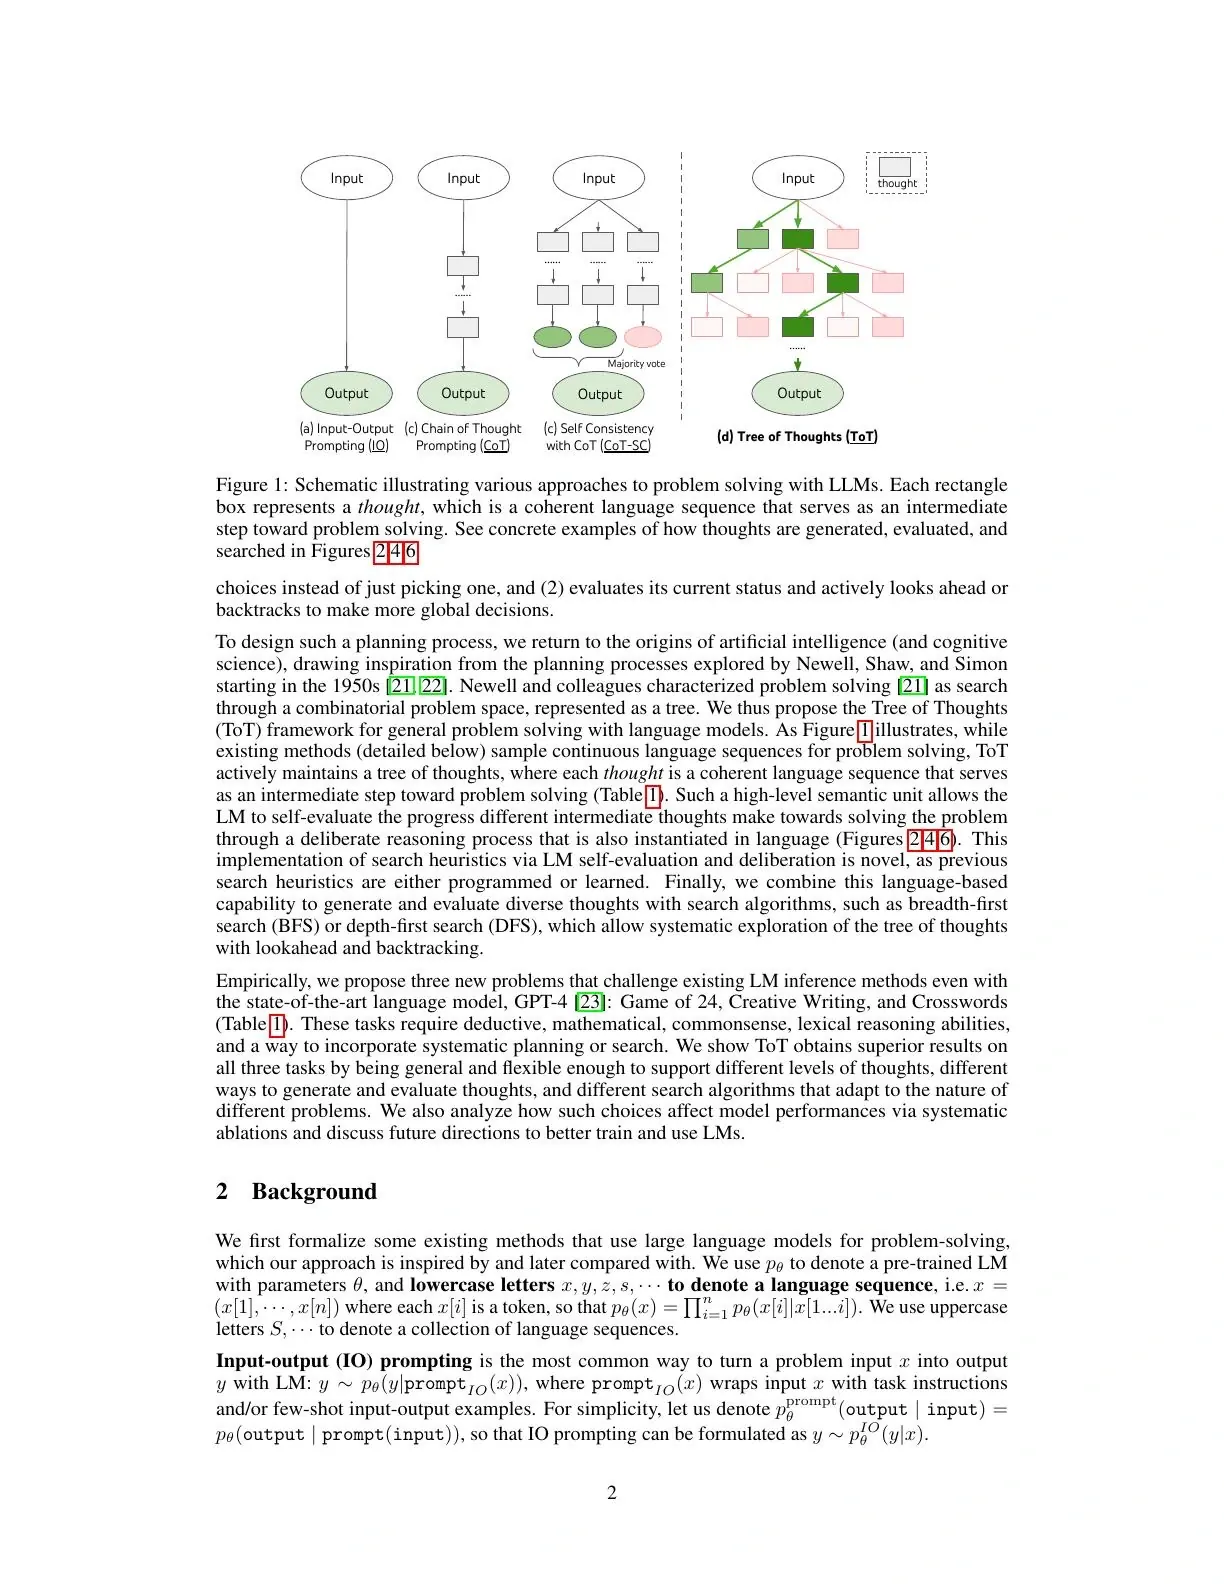
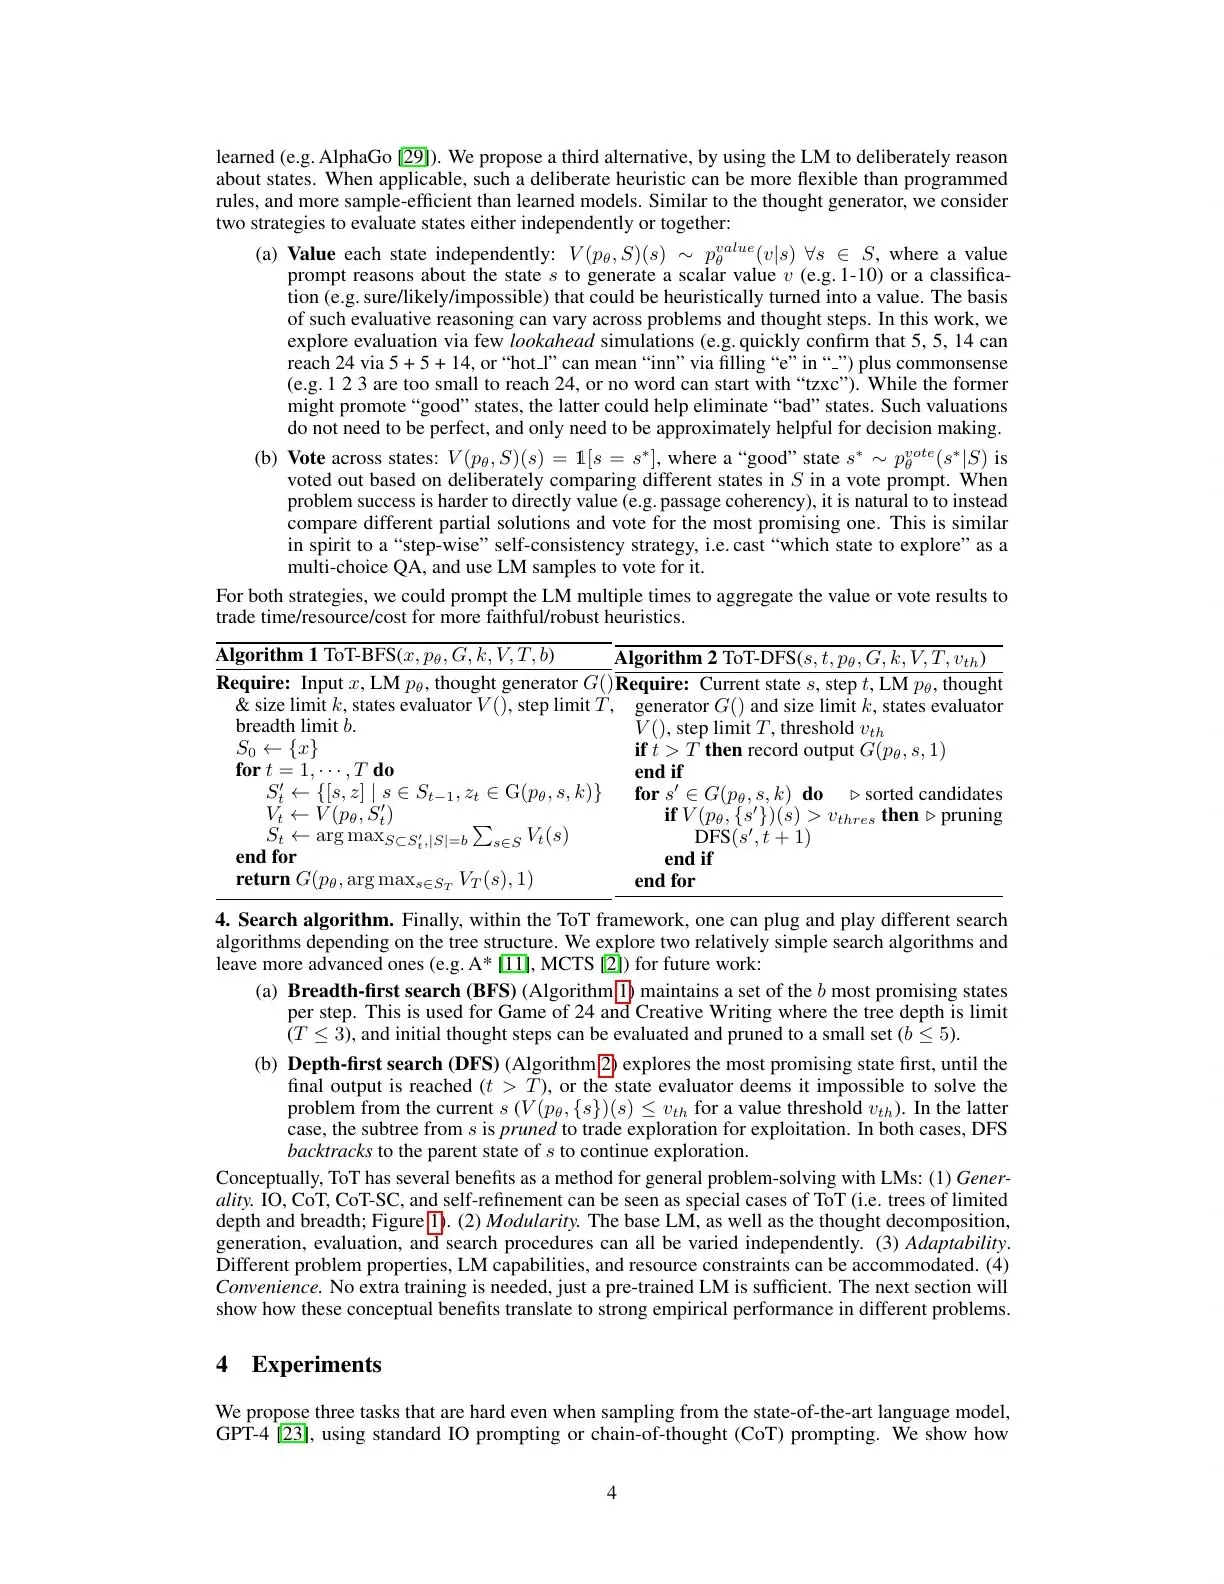
将问题建模为搜索树,每个节点是输入与中间思维序列组成的状态;每个思维是比 token 更大的连贯语言片段。通过 BFS 或 DFS 探索多条路径,并在每一步进行 LM 自我评估。
四个关键设计维度
| 维度 | 说明 | 示例 |
|---|---|---|
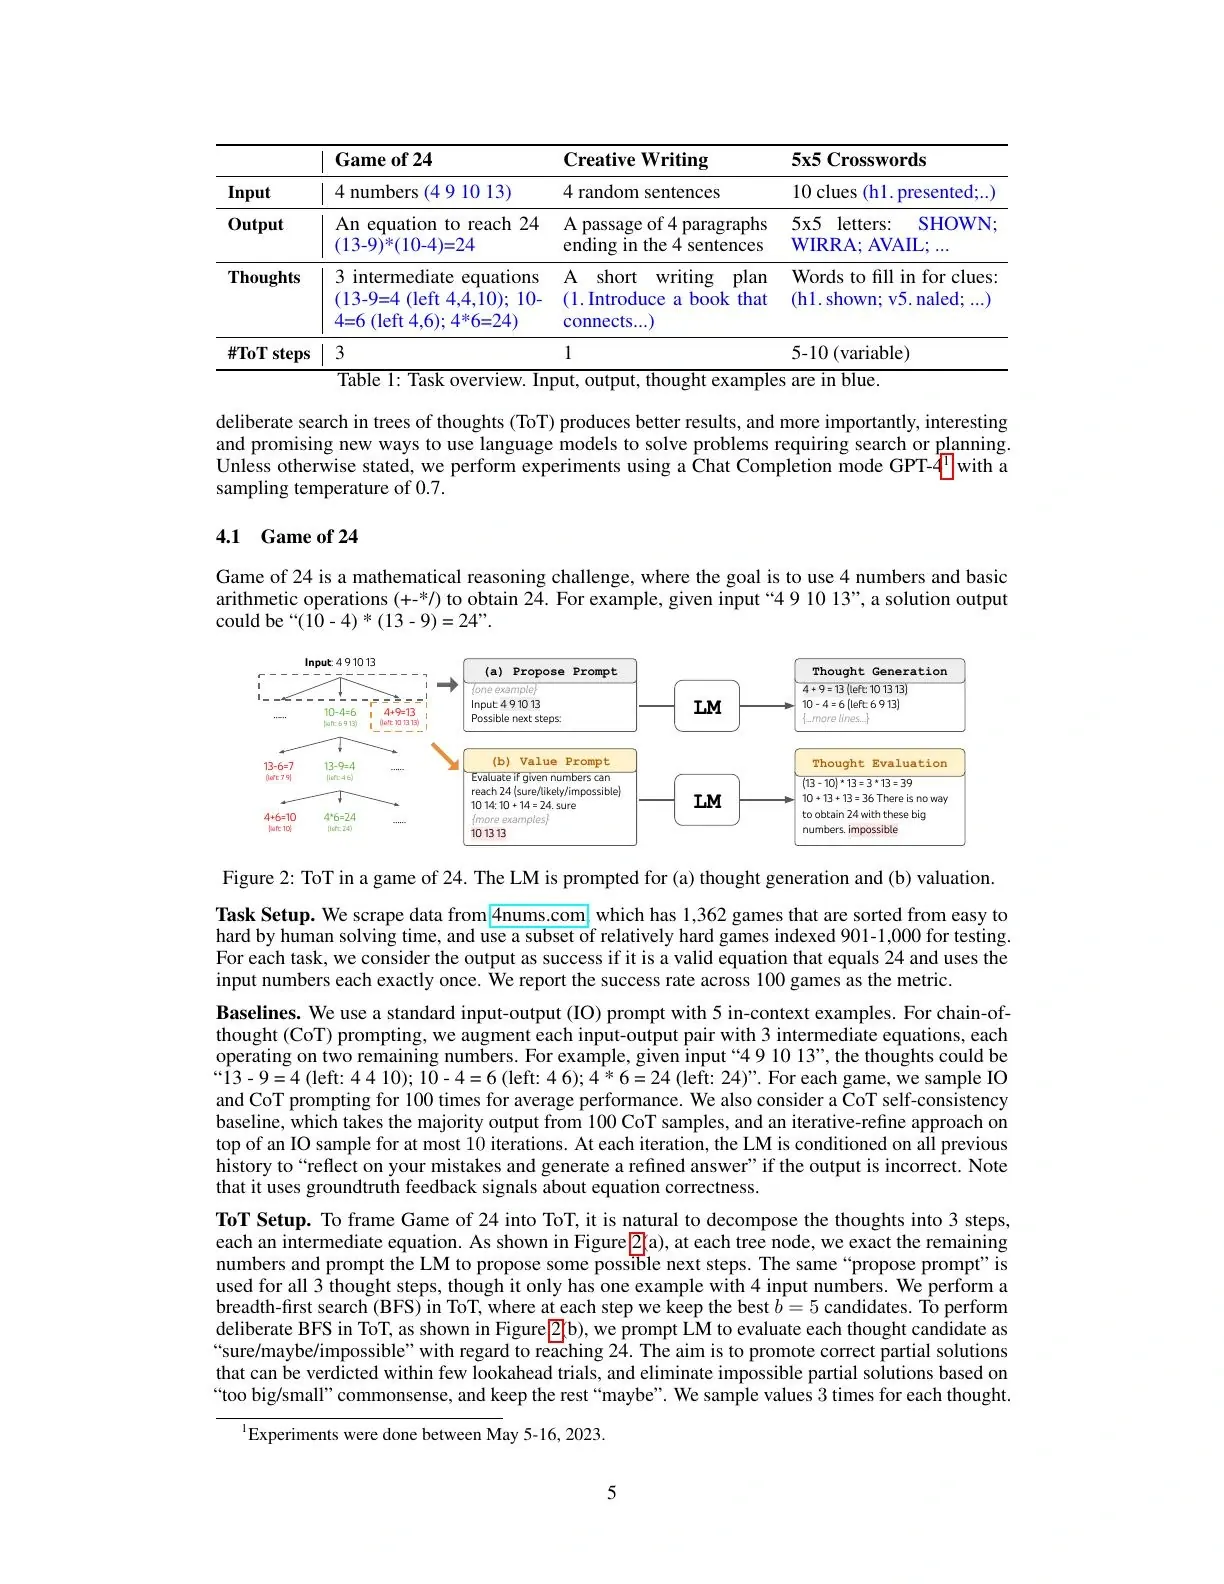
| 思维分解 | 定义适中的思维粒度 | 一行方程、计划段落、一个单词 |
| 思维生成 | 生成下一步候选 | 独立采样或 propose prompt |
| 状态评估 | 评价当前状态 | 独立打分或投票 |
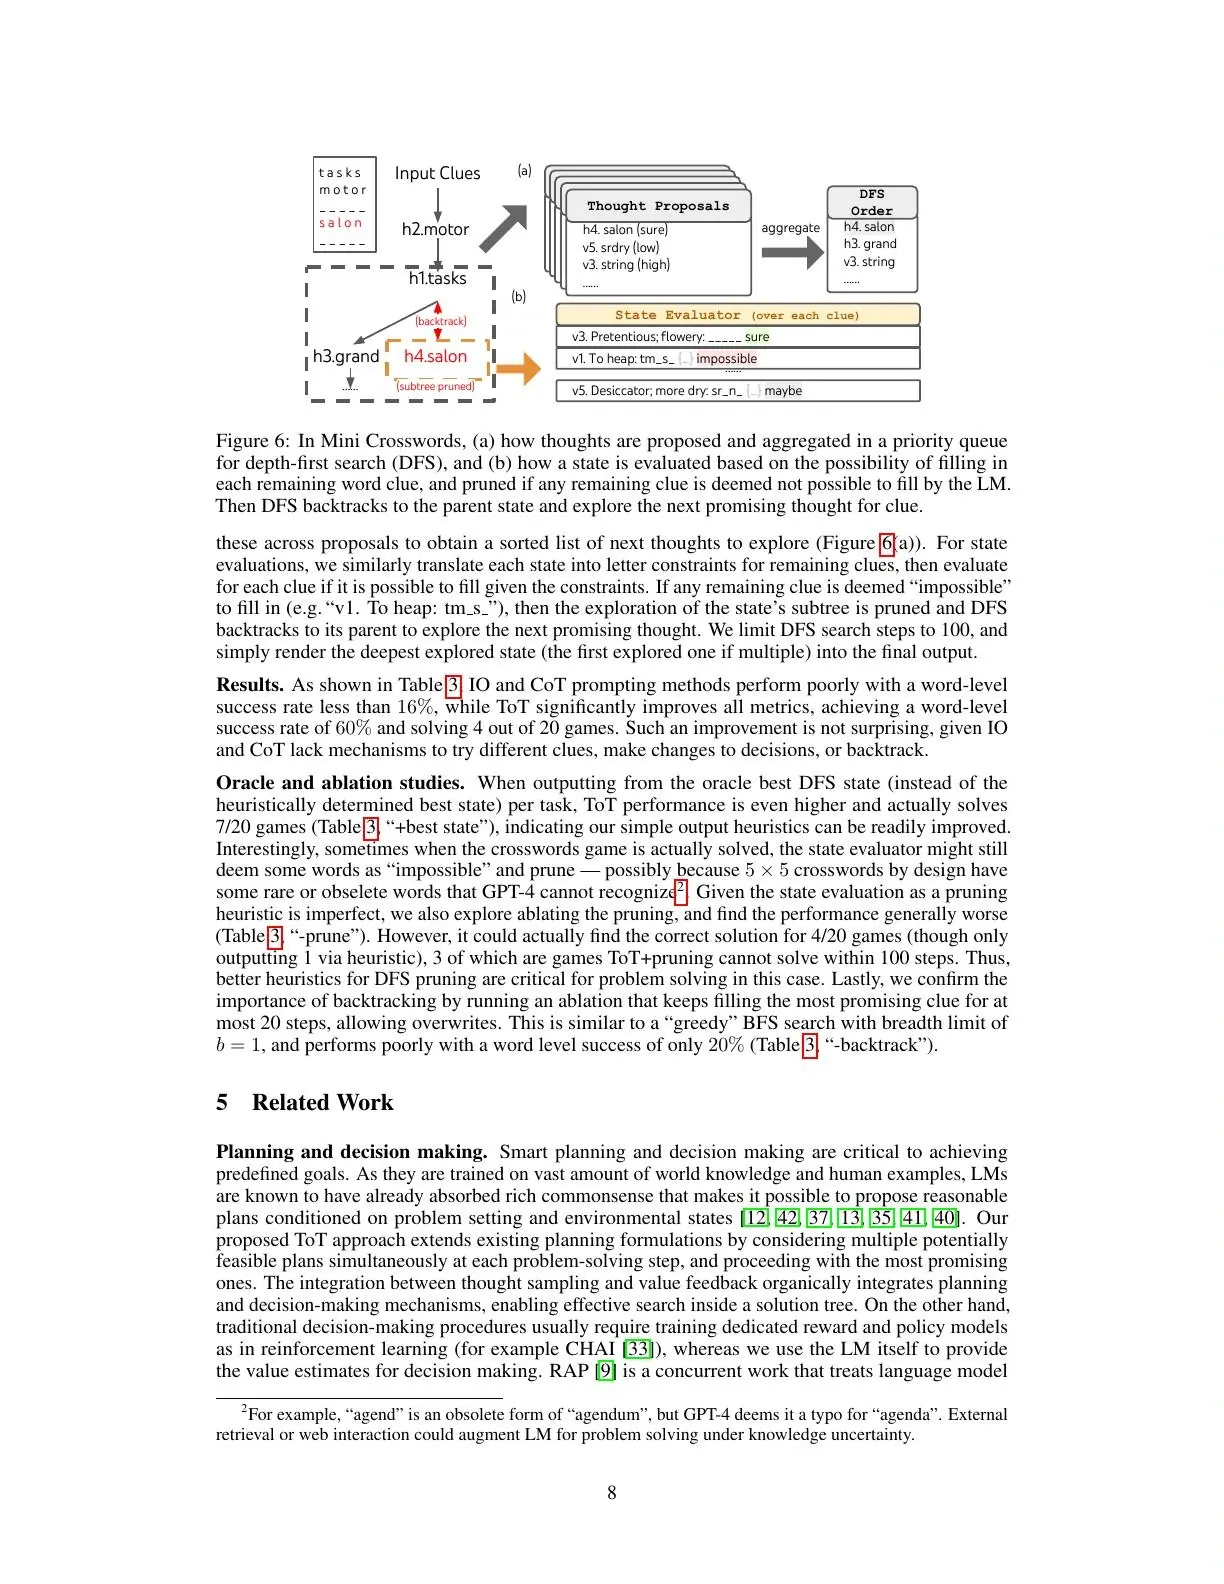
| 搜索算法 | 探索树的策略 | BFS 保留 top-b,DFS 可回溯 |
3. 三组实验与结果
3.1 24点游戏
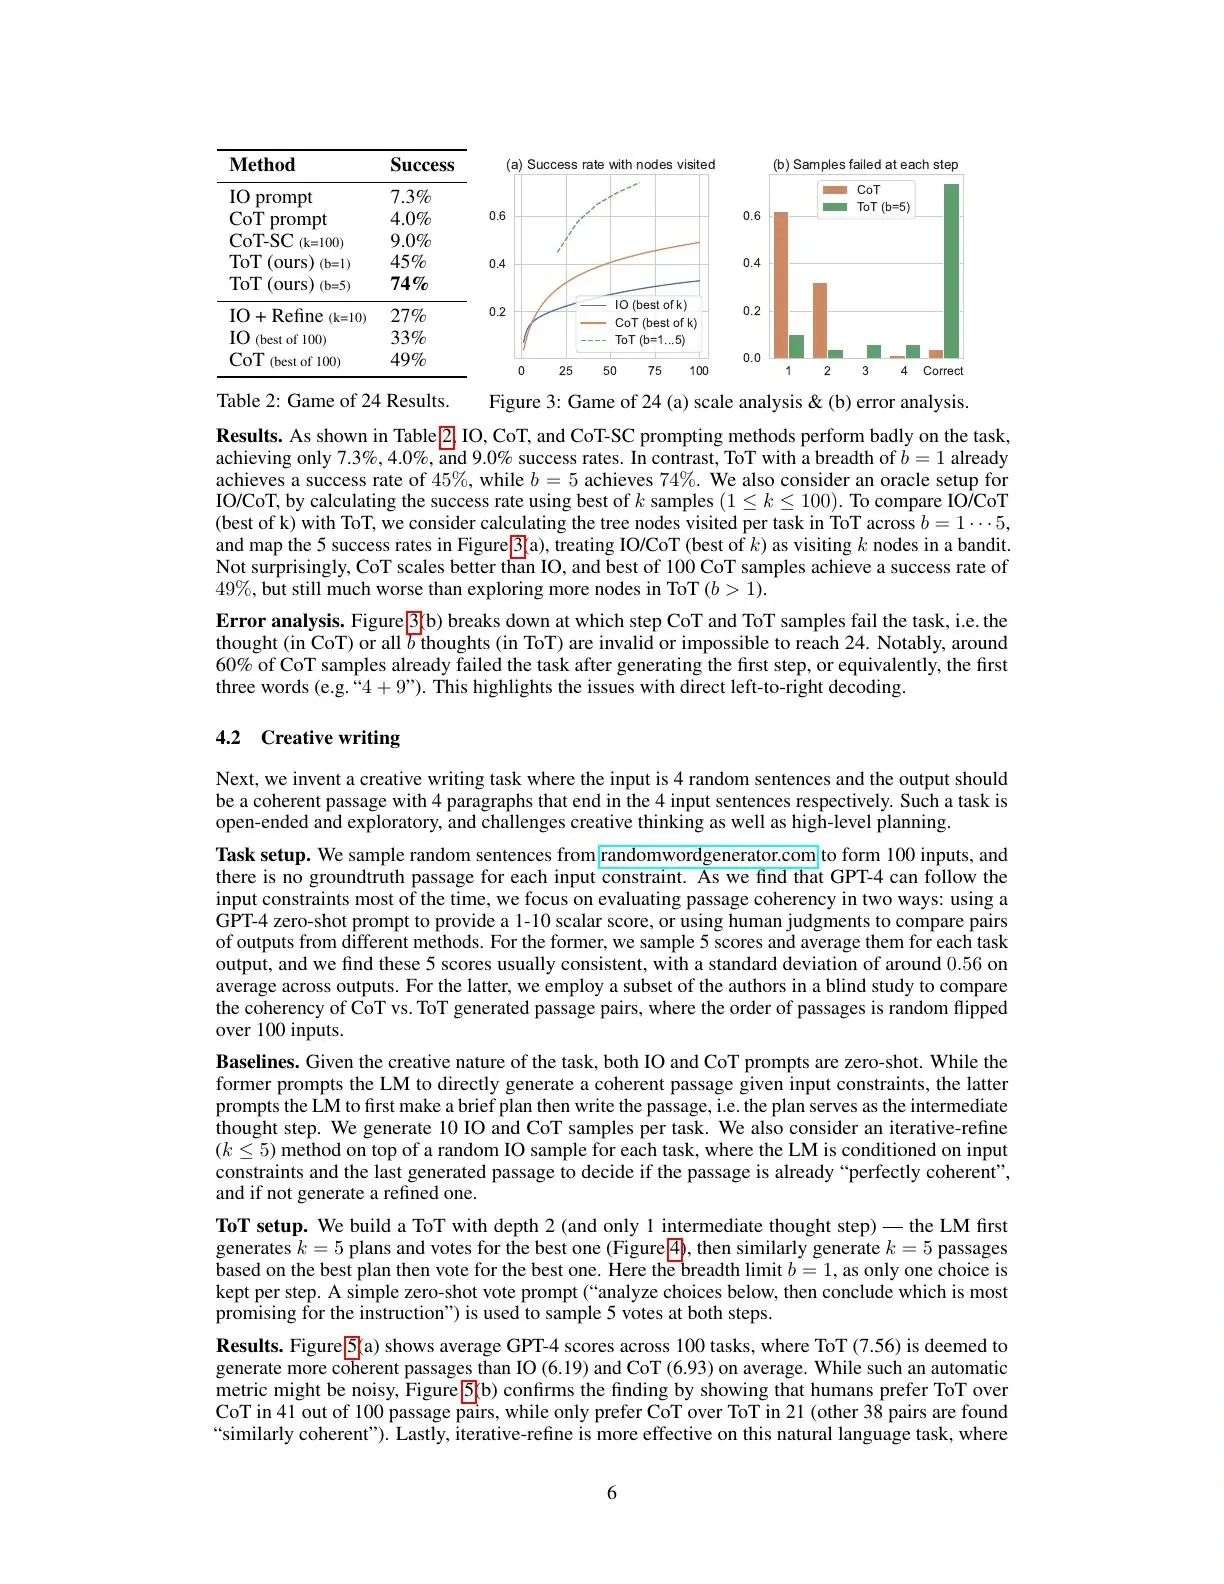
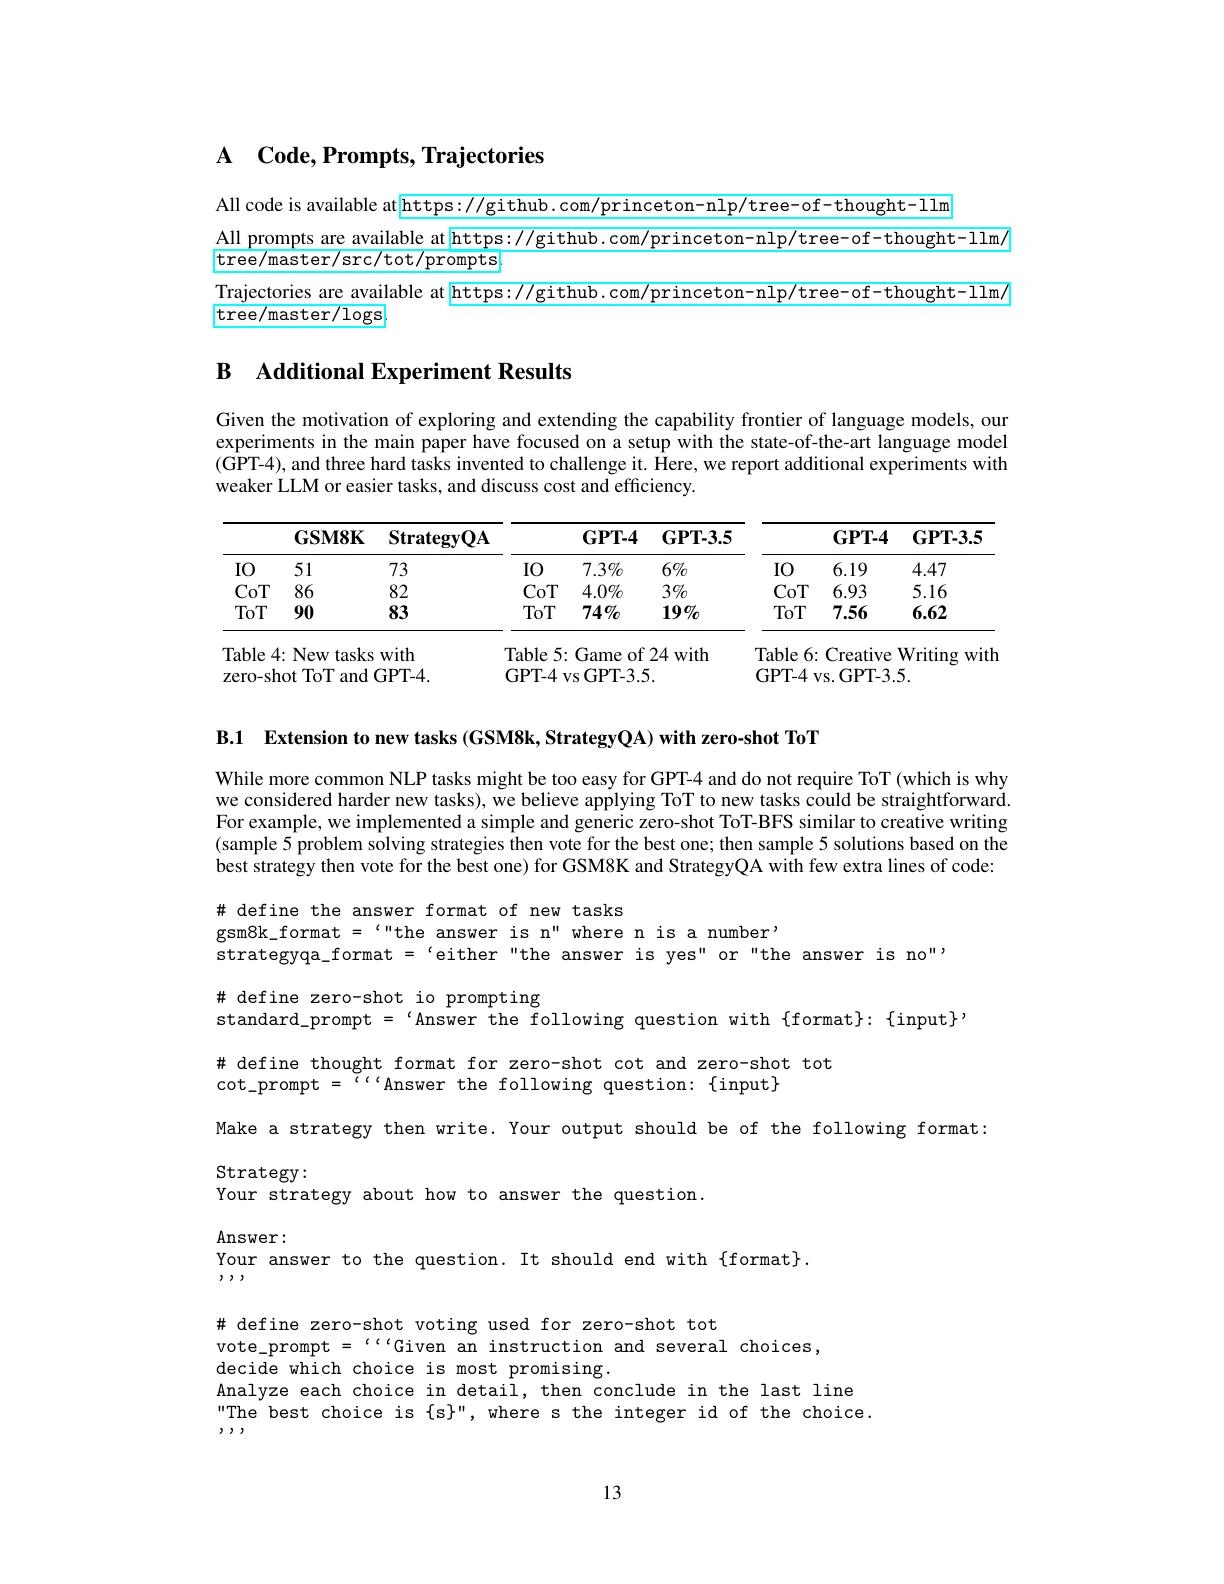
IO 7.3%,CoT 4.0%,CoT-SC 9.0%, ToT(b=5)74%。60% 的 CoT 错误发生在第一步,ToT 通过并行探索和评估避免早期错误。
3.2 创意写作
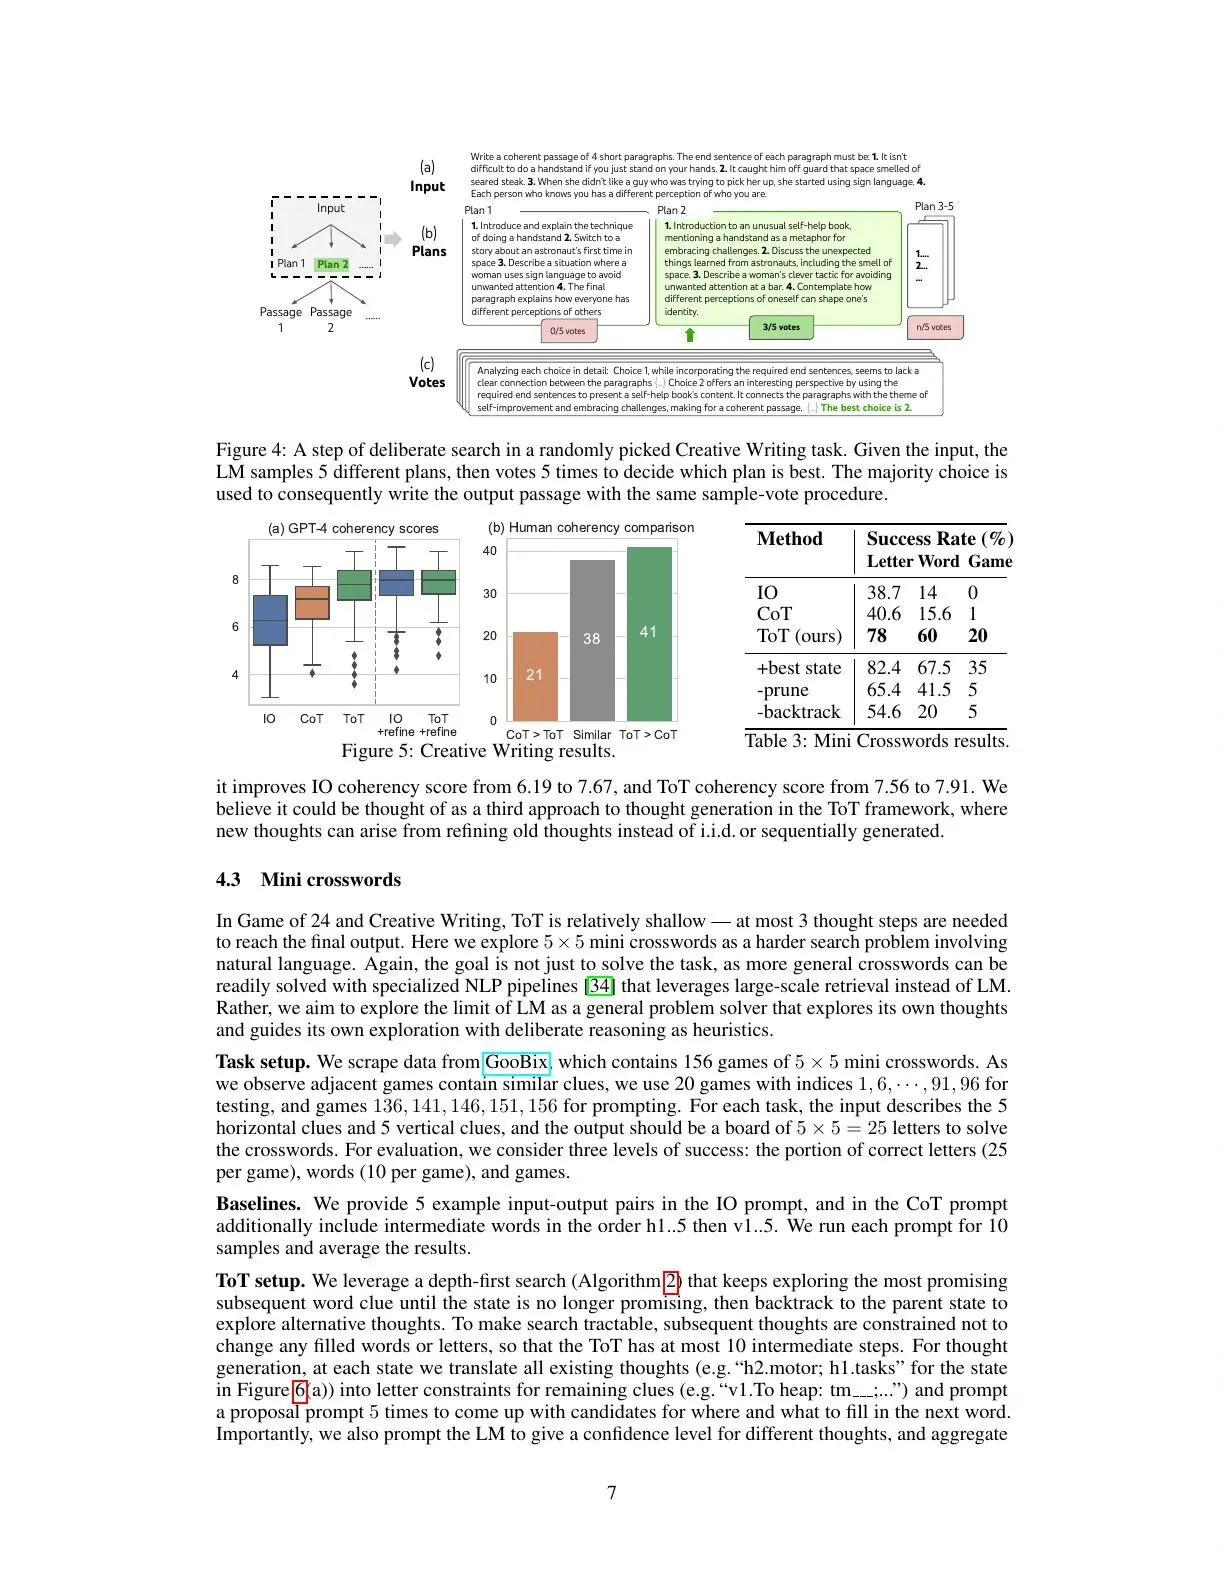
人类评估中 41% 偏好 ToT、21% 偏好 CoT;GPT-4 自动评分 ToT 7.56 > CoT 6.93 > IO 6.19。
3.3 5×5 迷你填字游戏
IO 单词准确率 14%,CoT 15.6%, ToT 60%,解出 4/20 个完整游戏。DFS 可在后续线索无法满足时回溯换词。
4. 与其他方法的对比
| 方法 | 探索多路径 | 前瞻/回溯 | 自我评估 | 适用复杂规划任务 |
|---|---|---|---|---|
| IO / CoT | ❌ | ❌ | ❌ | 低 |
| CoT-SC | ✅ | ❌ | ❌ | 中 |
| ToT | ✅ | ✅ | ✅ | 高 |
5. 优点与局限性
优点
- IO、CoT、CoT-SC 都可视为 ToT 的特例。
- 思维生成、评估、搜索算法可模块化替换。
- 无需训练,且每一步思维和评估结果可读。
局限性
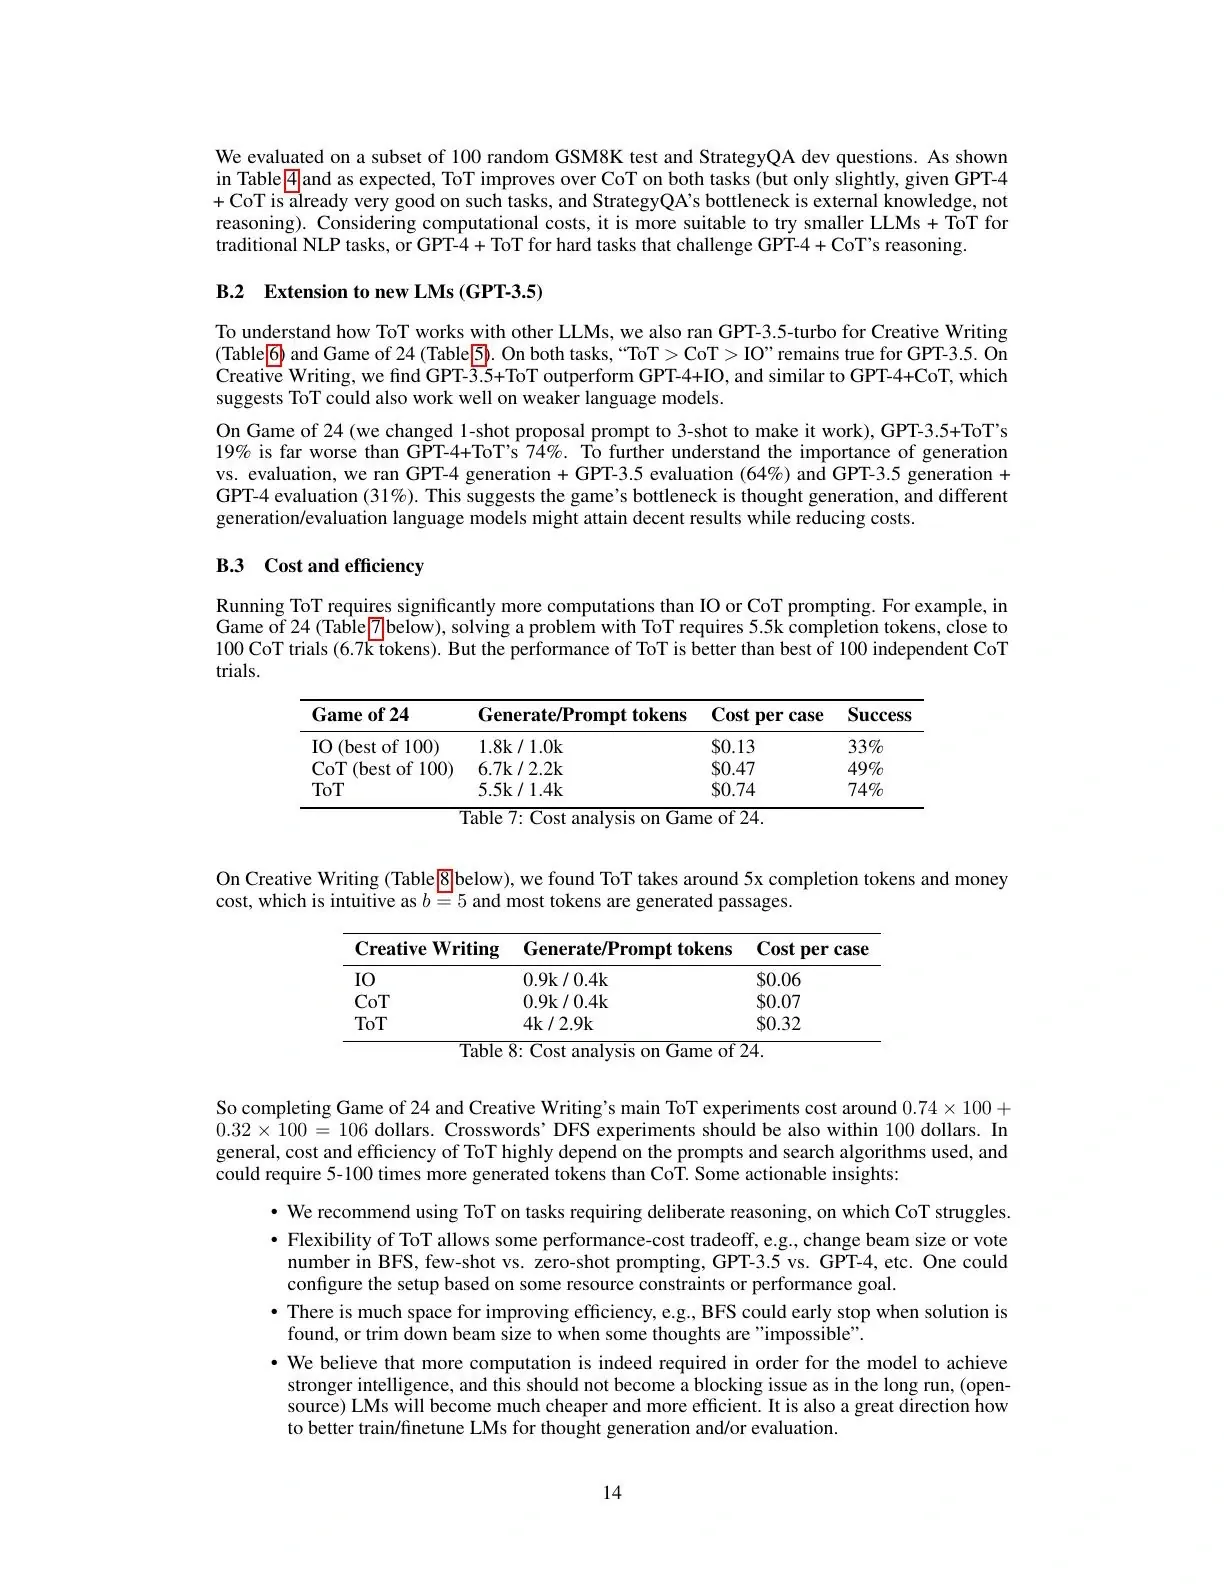
- 计算开销大,token 消耗可能高出 CoT 5~100 倍。
- 依赖强大的基础模型,GPT-3.5 在 24 点上仅 19%。
- 每个任务都需要人工设计思维粒度、prompt、评估方式和搜索策略。
6. 核心贡献总结
- 将经典 AI 搜索与大语言模型融合,提出通用 ToT 框架。
- 在 24 点、创意写作、迷你填字等复杂任务上显著提升,24 点从 4% 提升至 74%。
- 使用 LLM 自身作为状态评估器,替代传统启发式函数。
- 为编程、机器人、数据分析等需要规划、探索和回溯的场景铺路。
原论文在线预览
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
TOT思维树
https://www.shanfengpm.com/posts/2026-03-11-paper-tree-of-thoughts/本文首发于「山风blog」,作者:山风(余涛)。欢迎转发、分享本文链接, 但禁止任何形式的未授权转载、摘编、改写或商业使用。

推荐文章论文阅读
1
CoT思维链
笔记提炼 Chain-of-Thought 思维链提示的核心问题、方法机制、实验结果与适用边界,并附原论文在线预览。
2
自我一致性
笔记提炼 Self-Consistency 自我一致性方法的核心问题、采样投票机制、实验结果与适用边界,并附原论文在线预览。
3
反思机制
笔记提炼 Reflexion 言语强化学习的核心方法、实验结果与适用边界,并附原论文在线预览。
4
大模型认知基础
笔记大模型认知基础课程资料,涵盖 AI、机器学习、深度学习、大模型、RAG、Agent 与微调。
5
Transformer 直觉
笔记用产品经理能理解的方式解释 Transformer、自注意力与上下文关系,并将模型能力边界转化为产品判断。