


自我一致性
1273 字
6 分钟
自我一致性
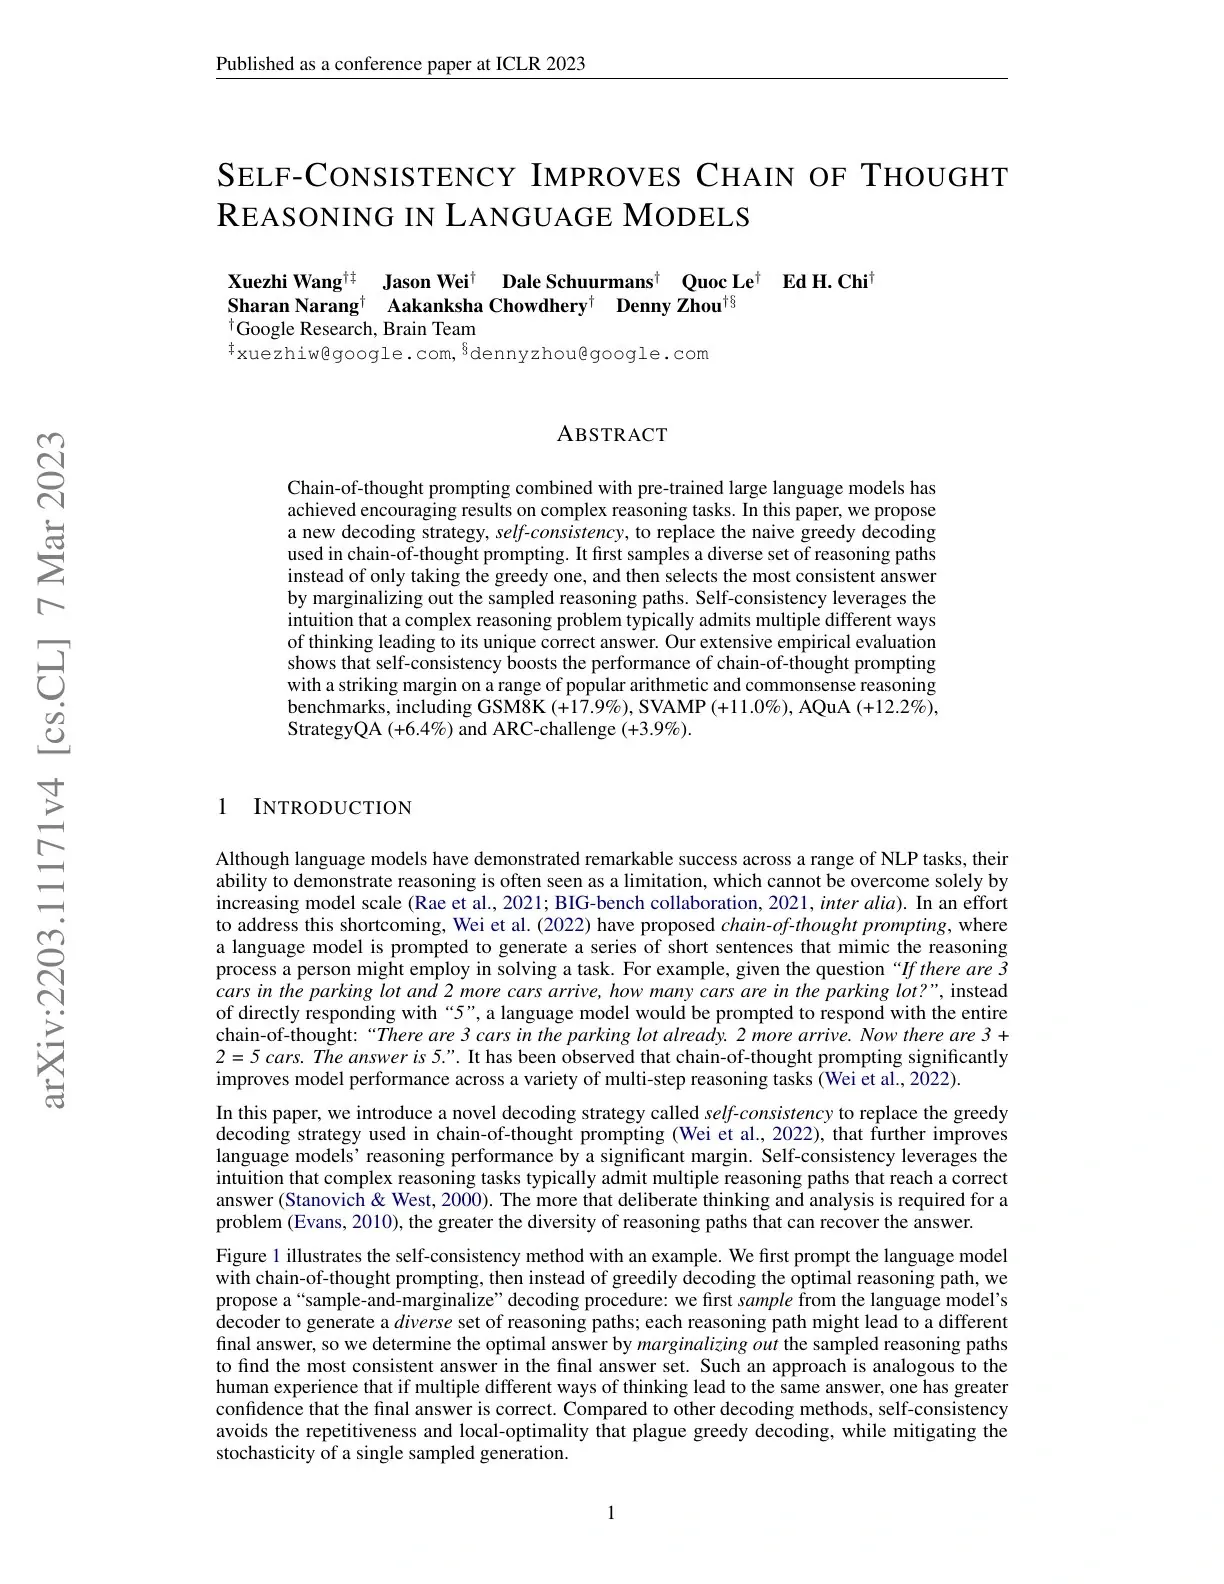
论文核心内容提炼:Self-Consistency Improves Chain of Thought Reasoning in Language Models
作者:Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed H. Chi, Sharan Narang, Aakanksha Chowdhery, Denny Zhou (Google Research)
发表:NeurIPS / arXiv 2022
1. 研究问题
- 思维链(Chain-of-Thought, CoT) prompting 已能提升大模型在多步推理任务上的表现。
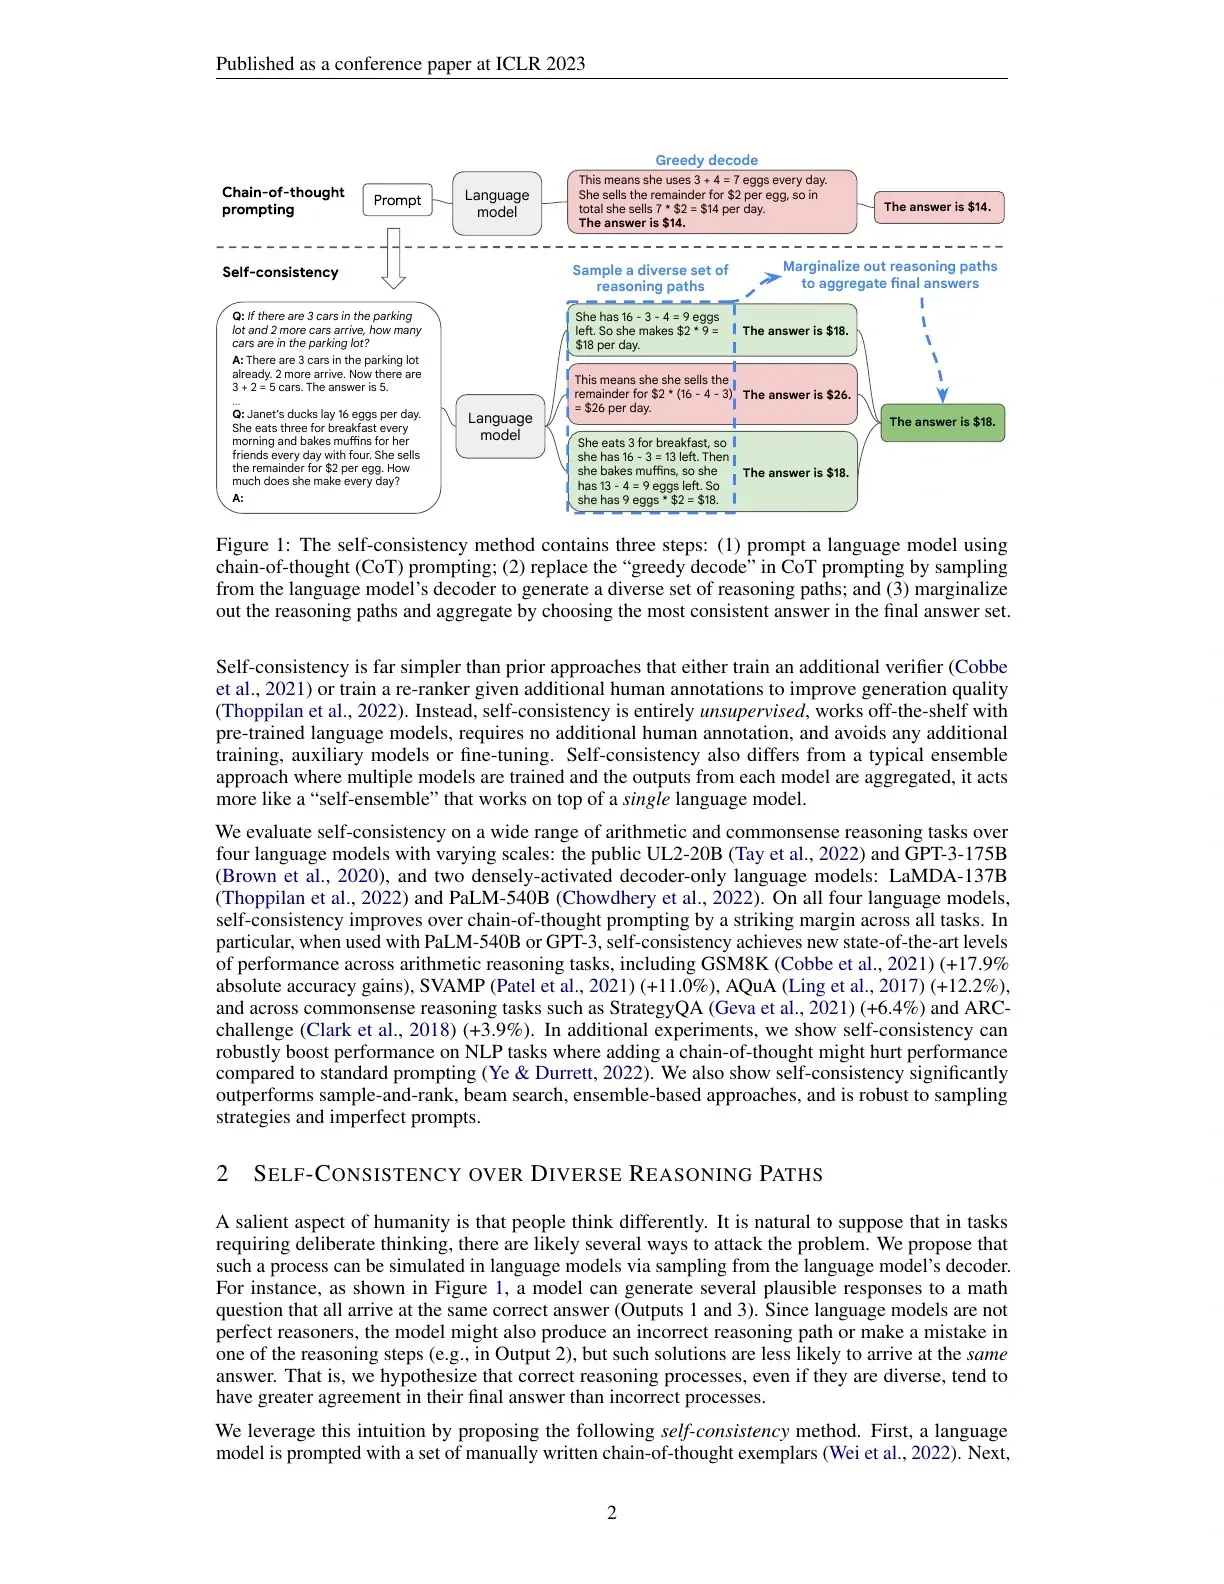
- 但 CoT 默认使用 贪婪解码(greedy decoding),只生成一条推理路径,容易陷入局部最优或计算错误。
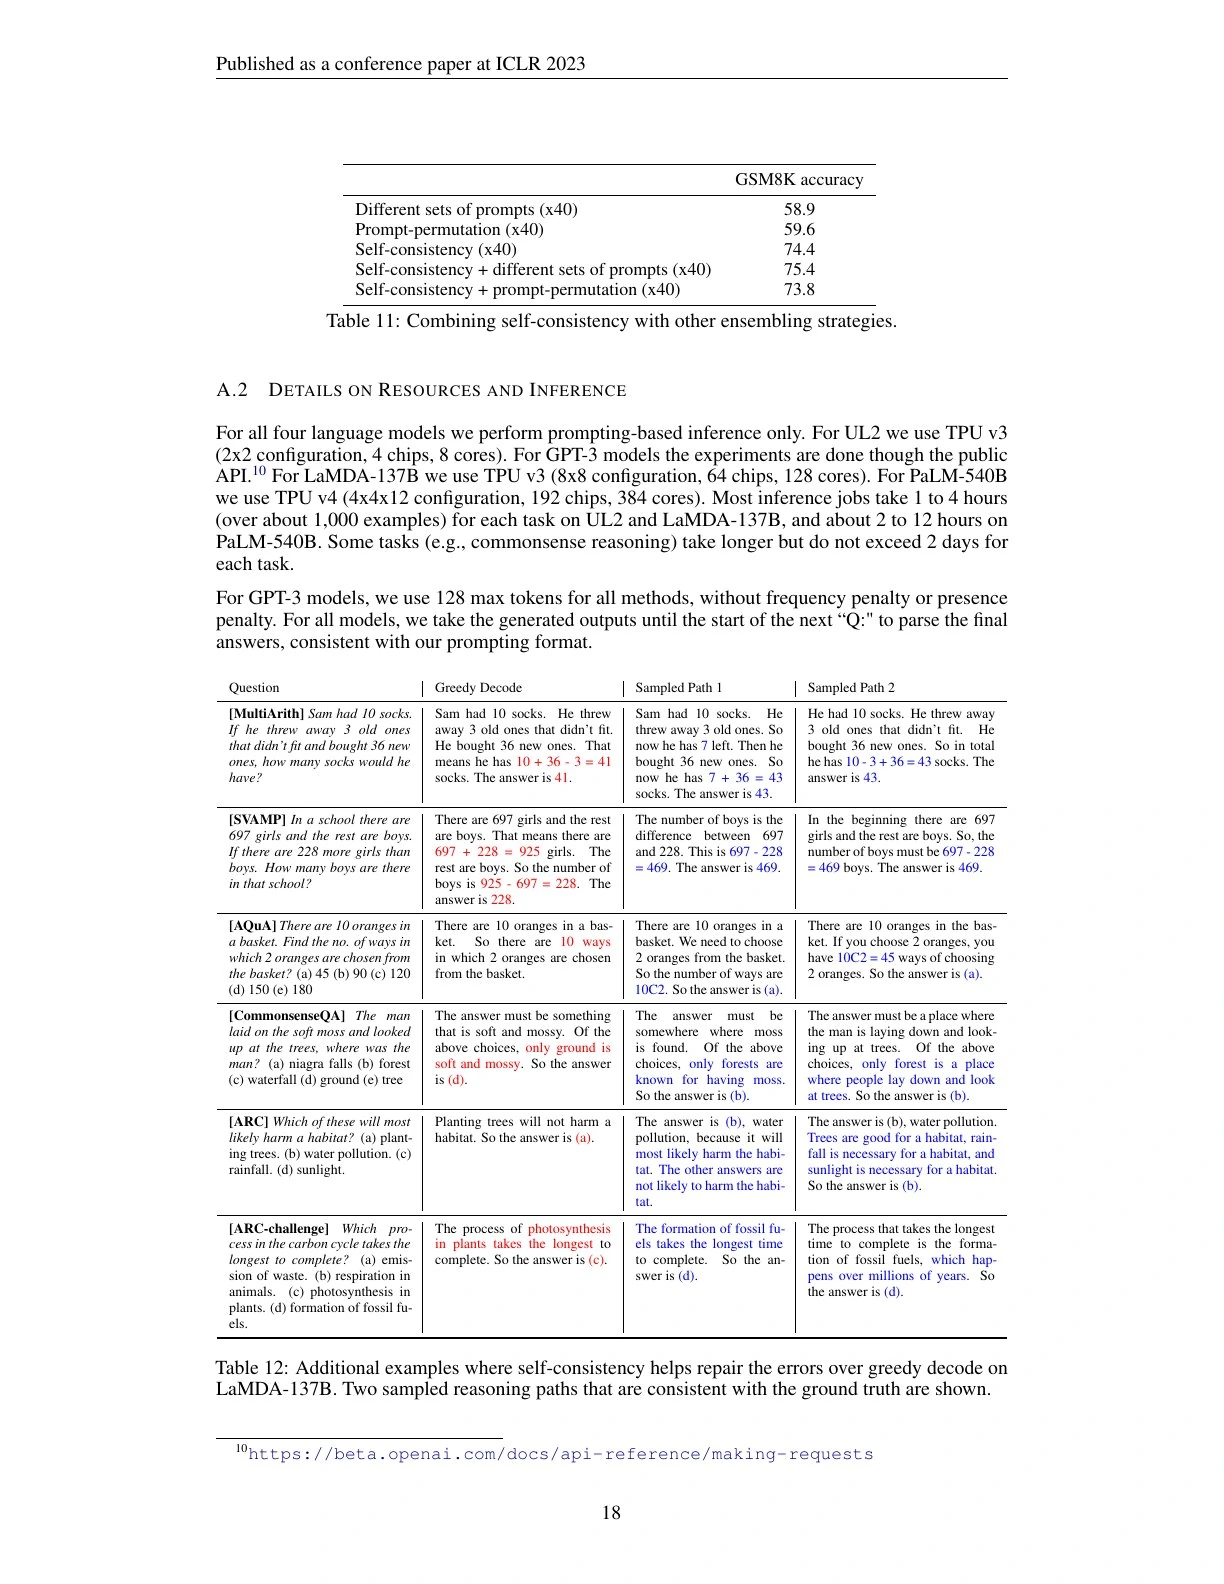
- 本文提出: 复杂推理问题通常存在多条不同的有效推理路径,且都通向同一正确答案。若能采样多条路径并投票,可显著提升准确率。
2. 核心方法:自我一致性(Self-Consistency)
基本流程(三步)
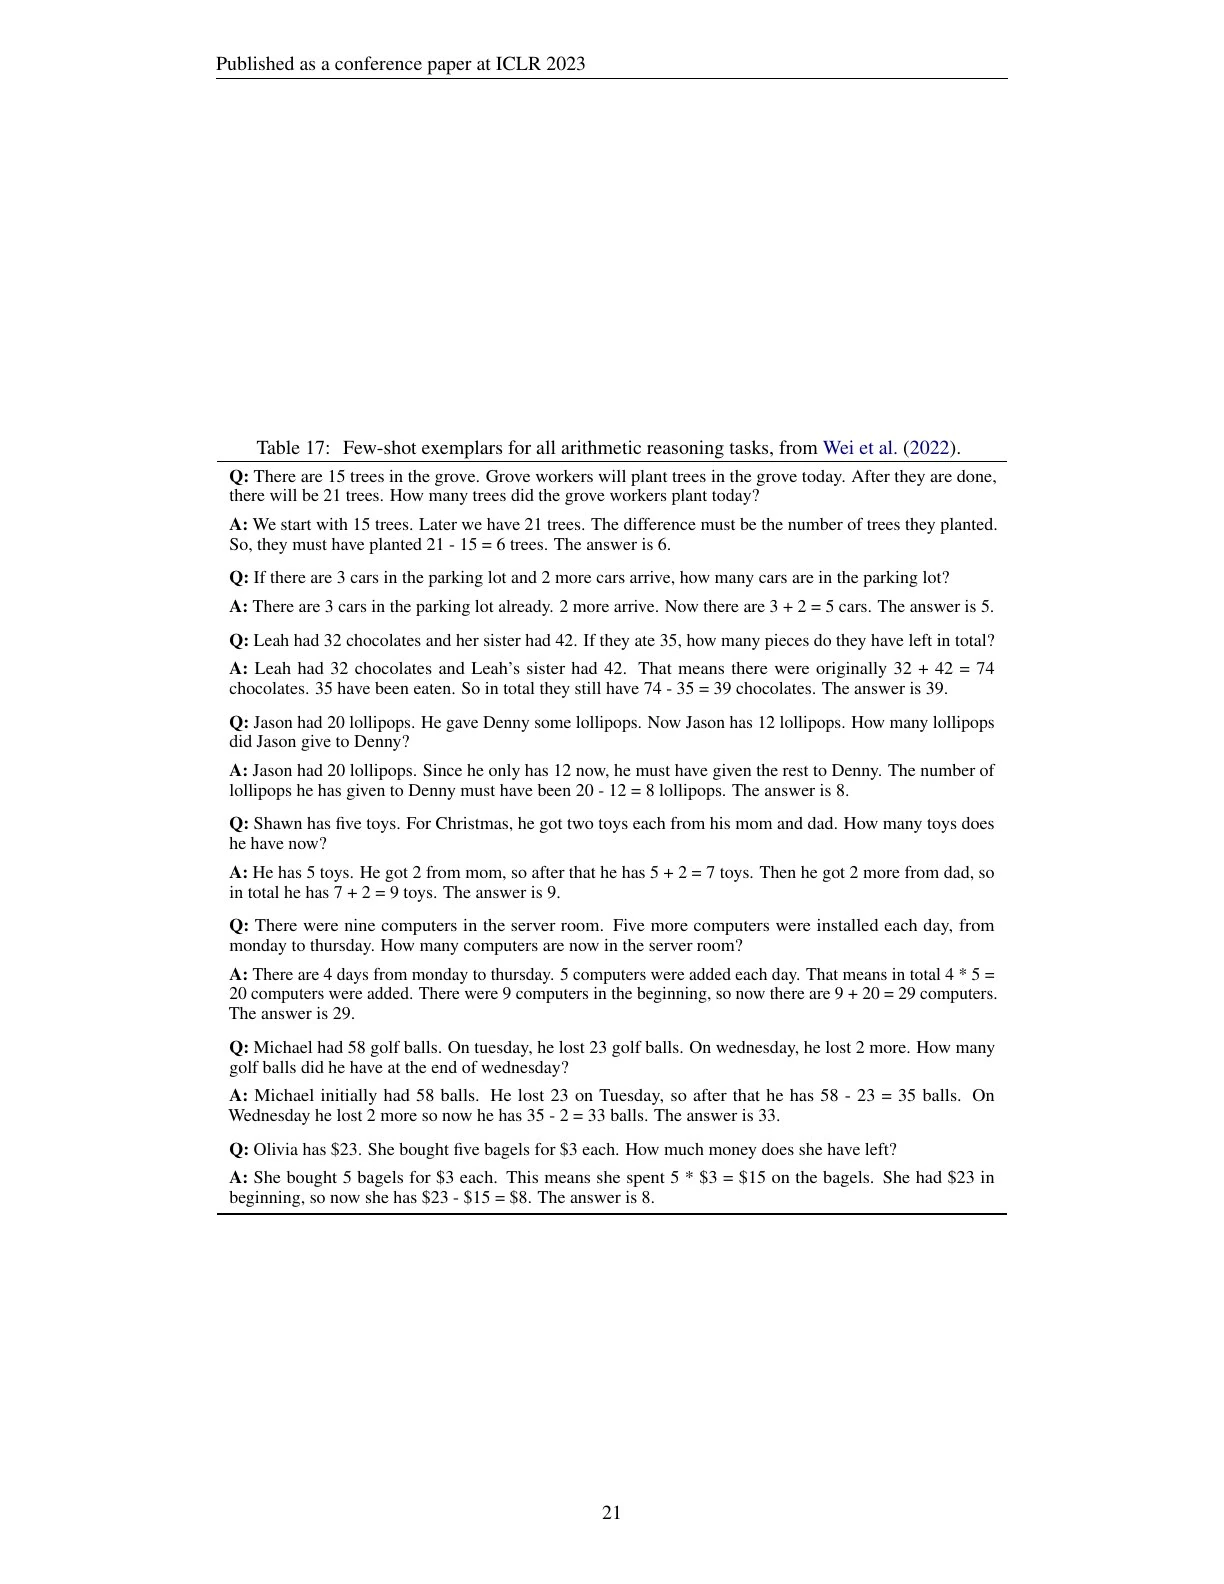
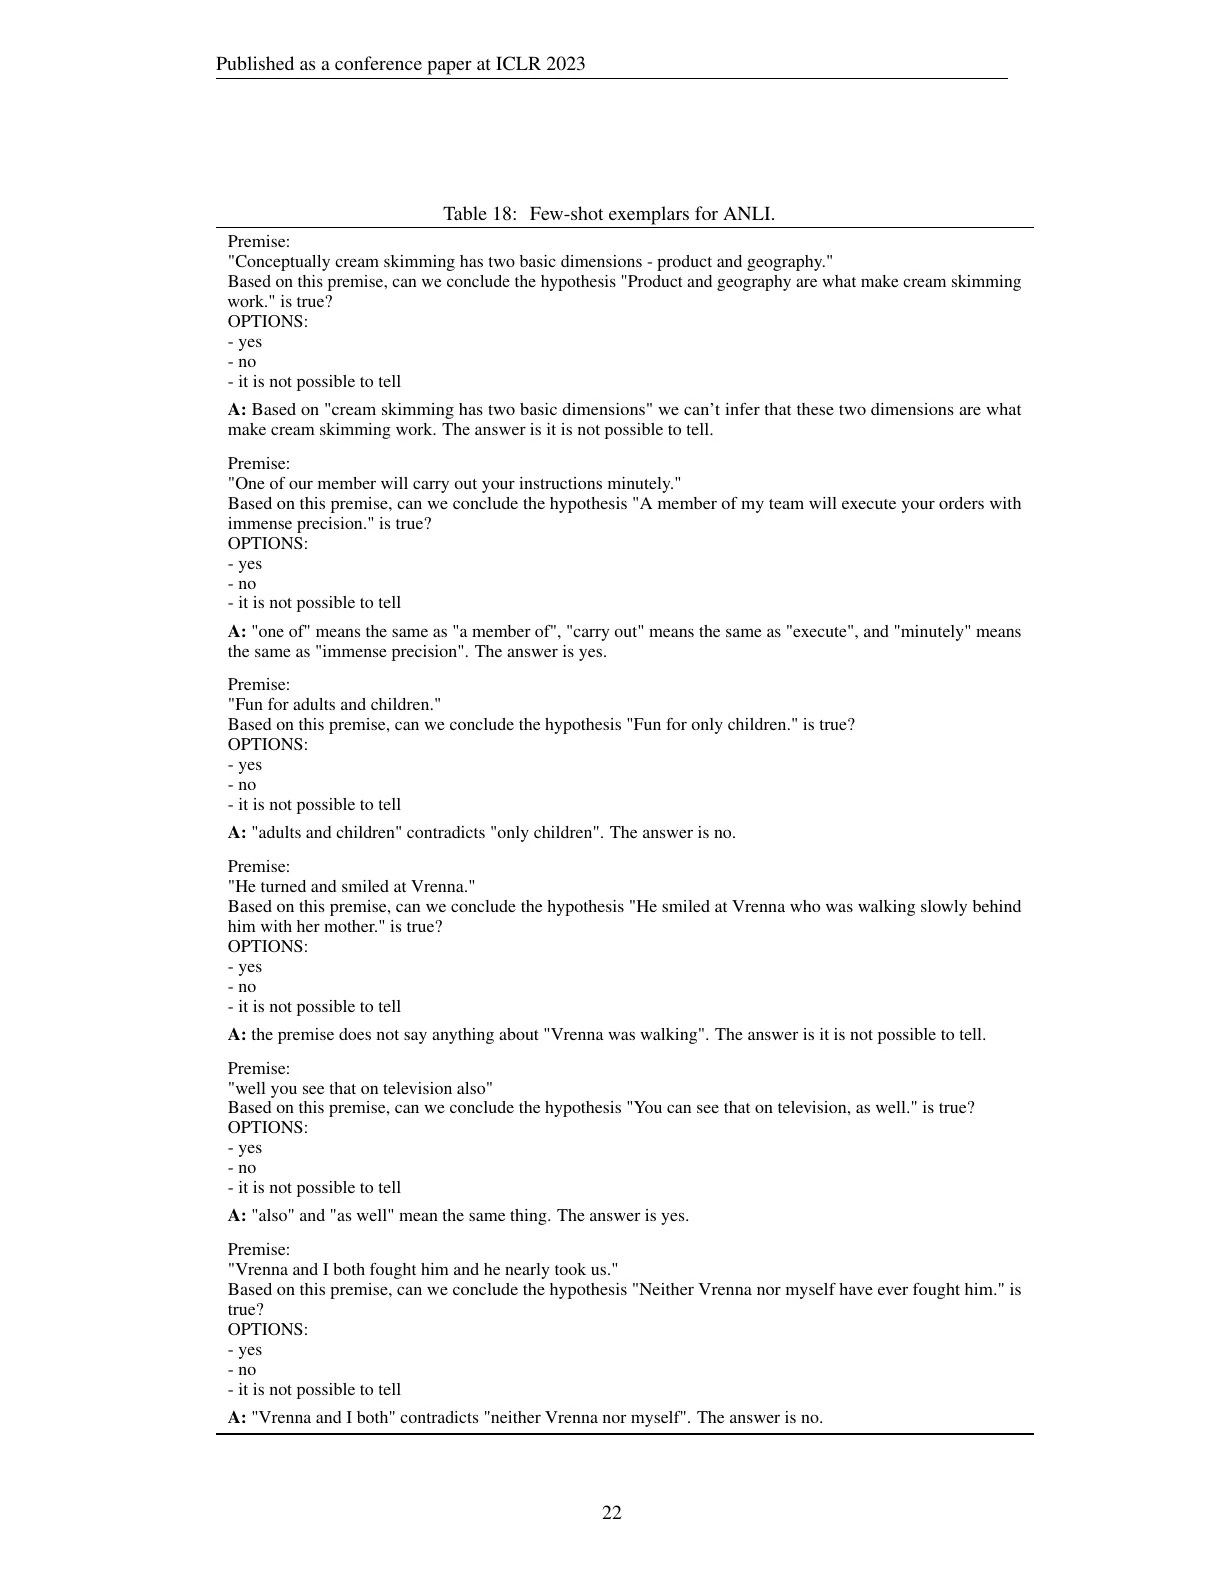
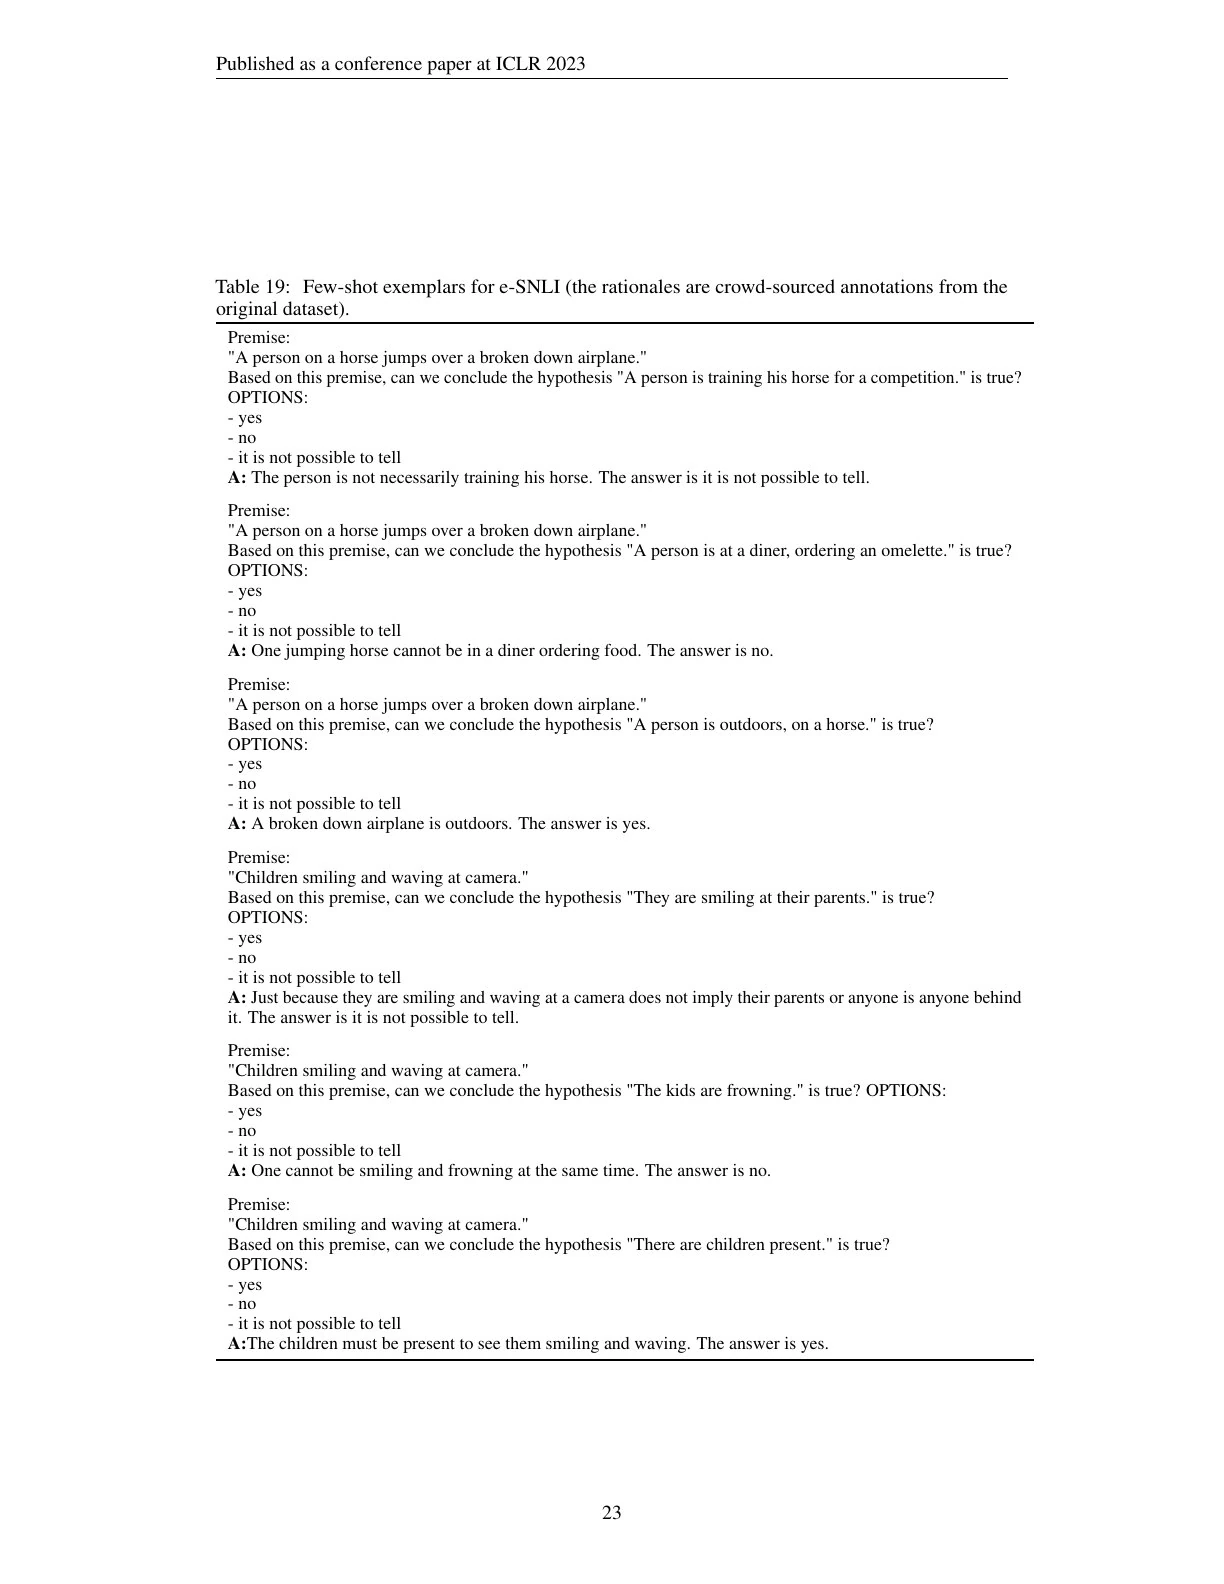
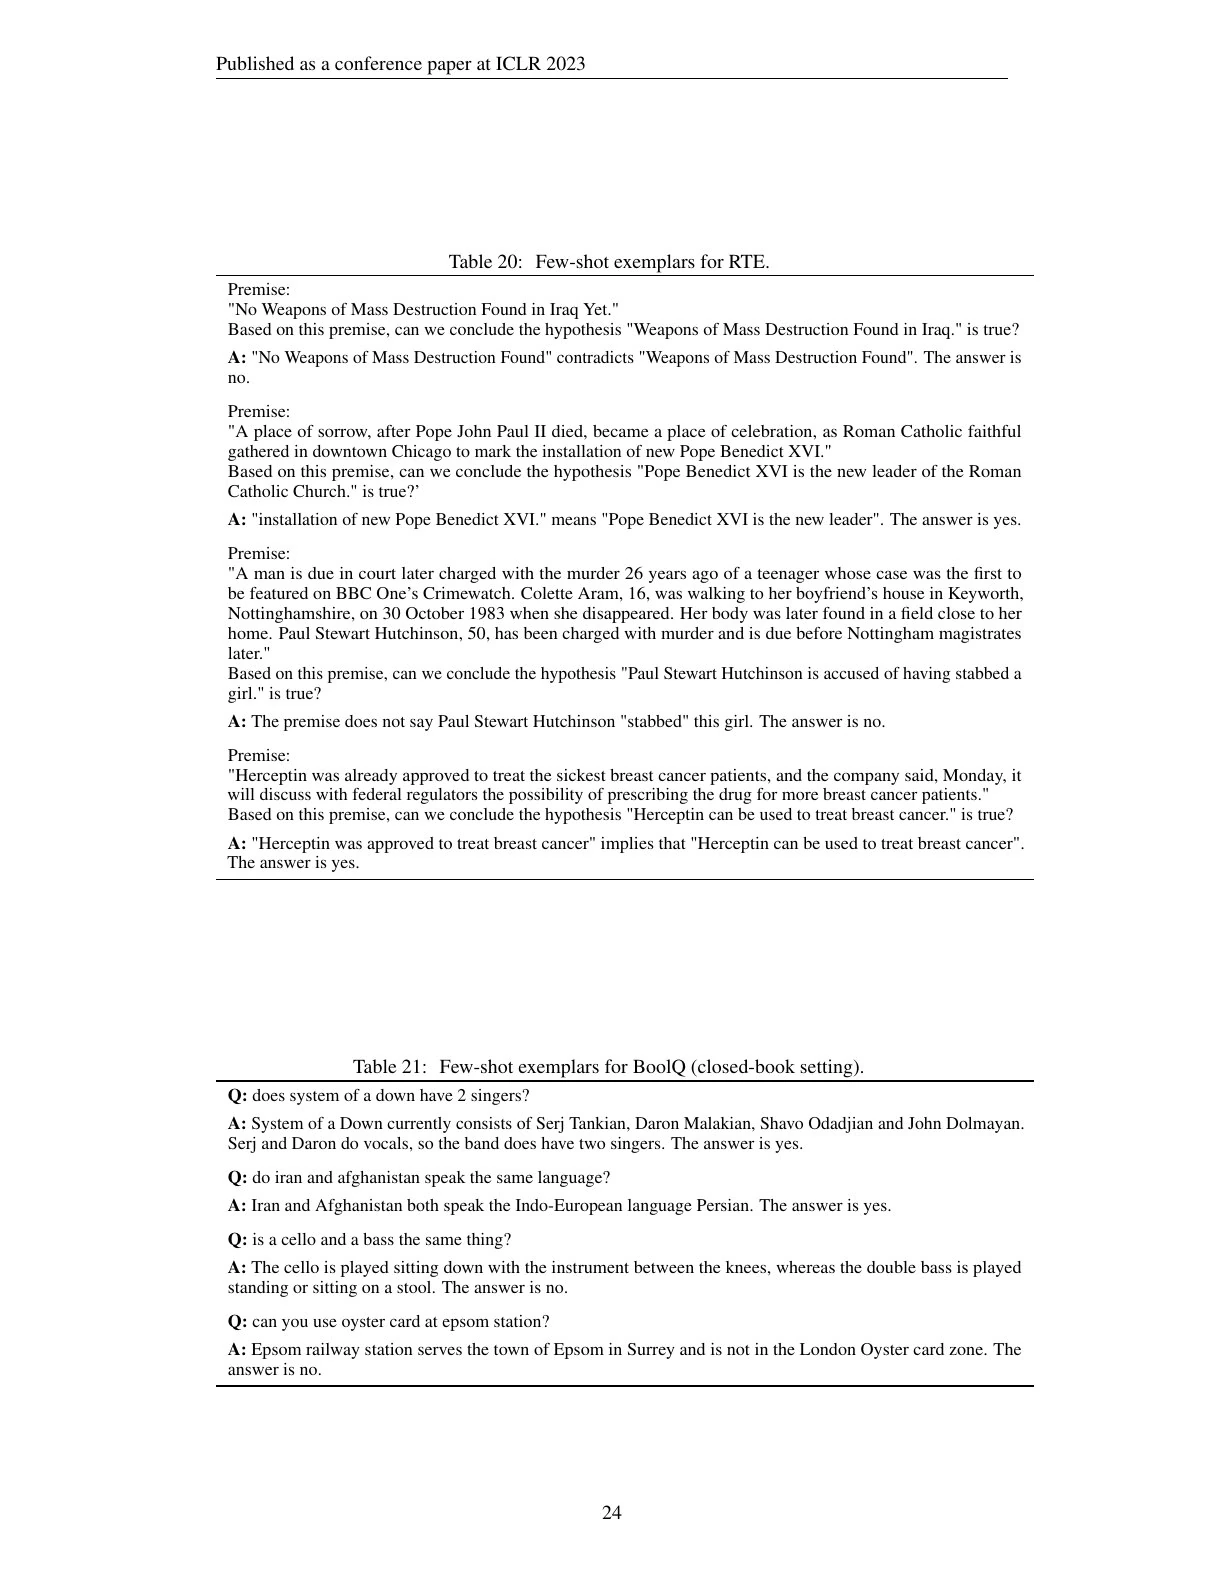
- CoT 提示:与标准 CoT 一样,用少量带有推理步骤的示例 prompt 模型。
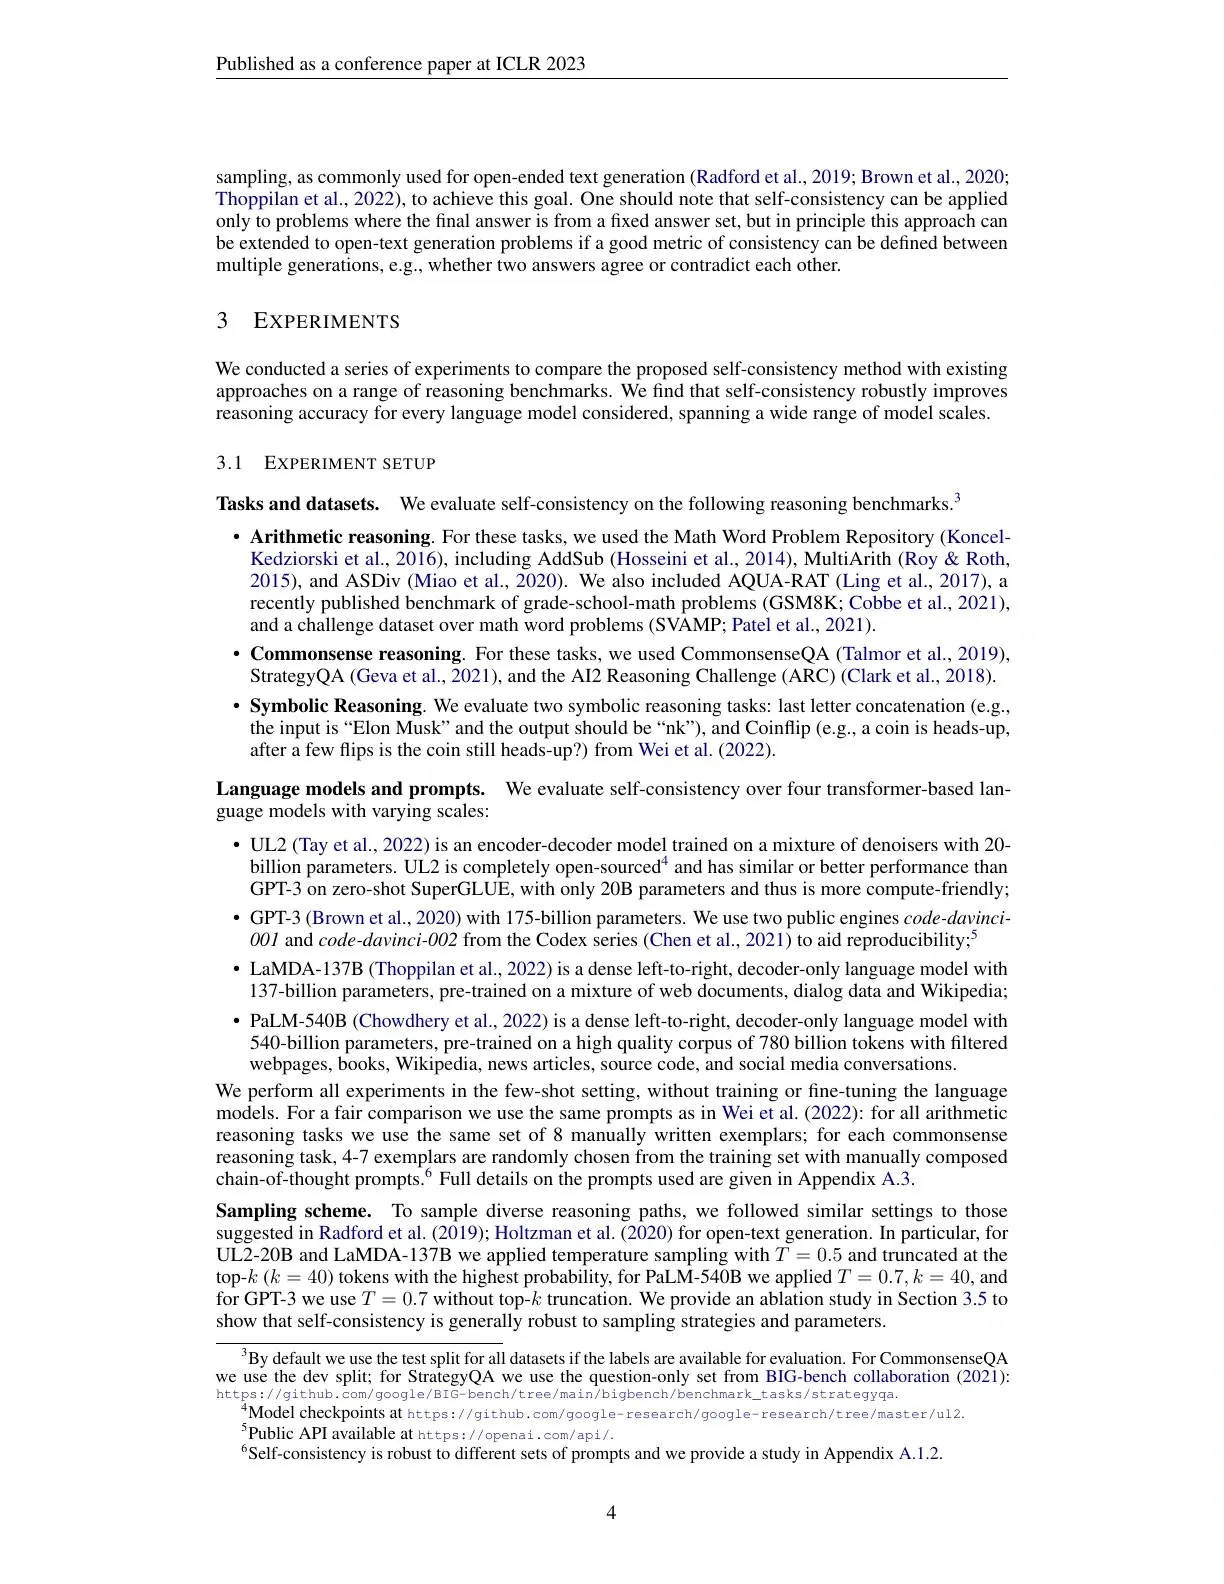
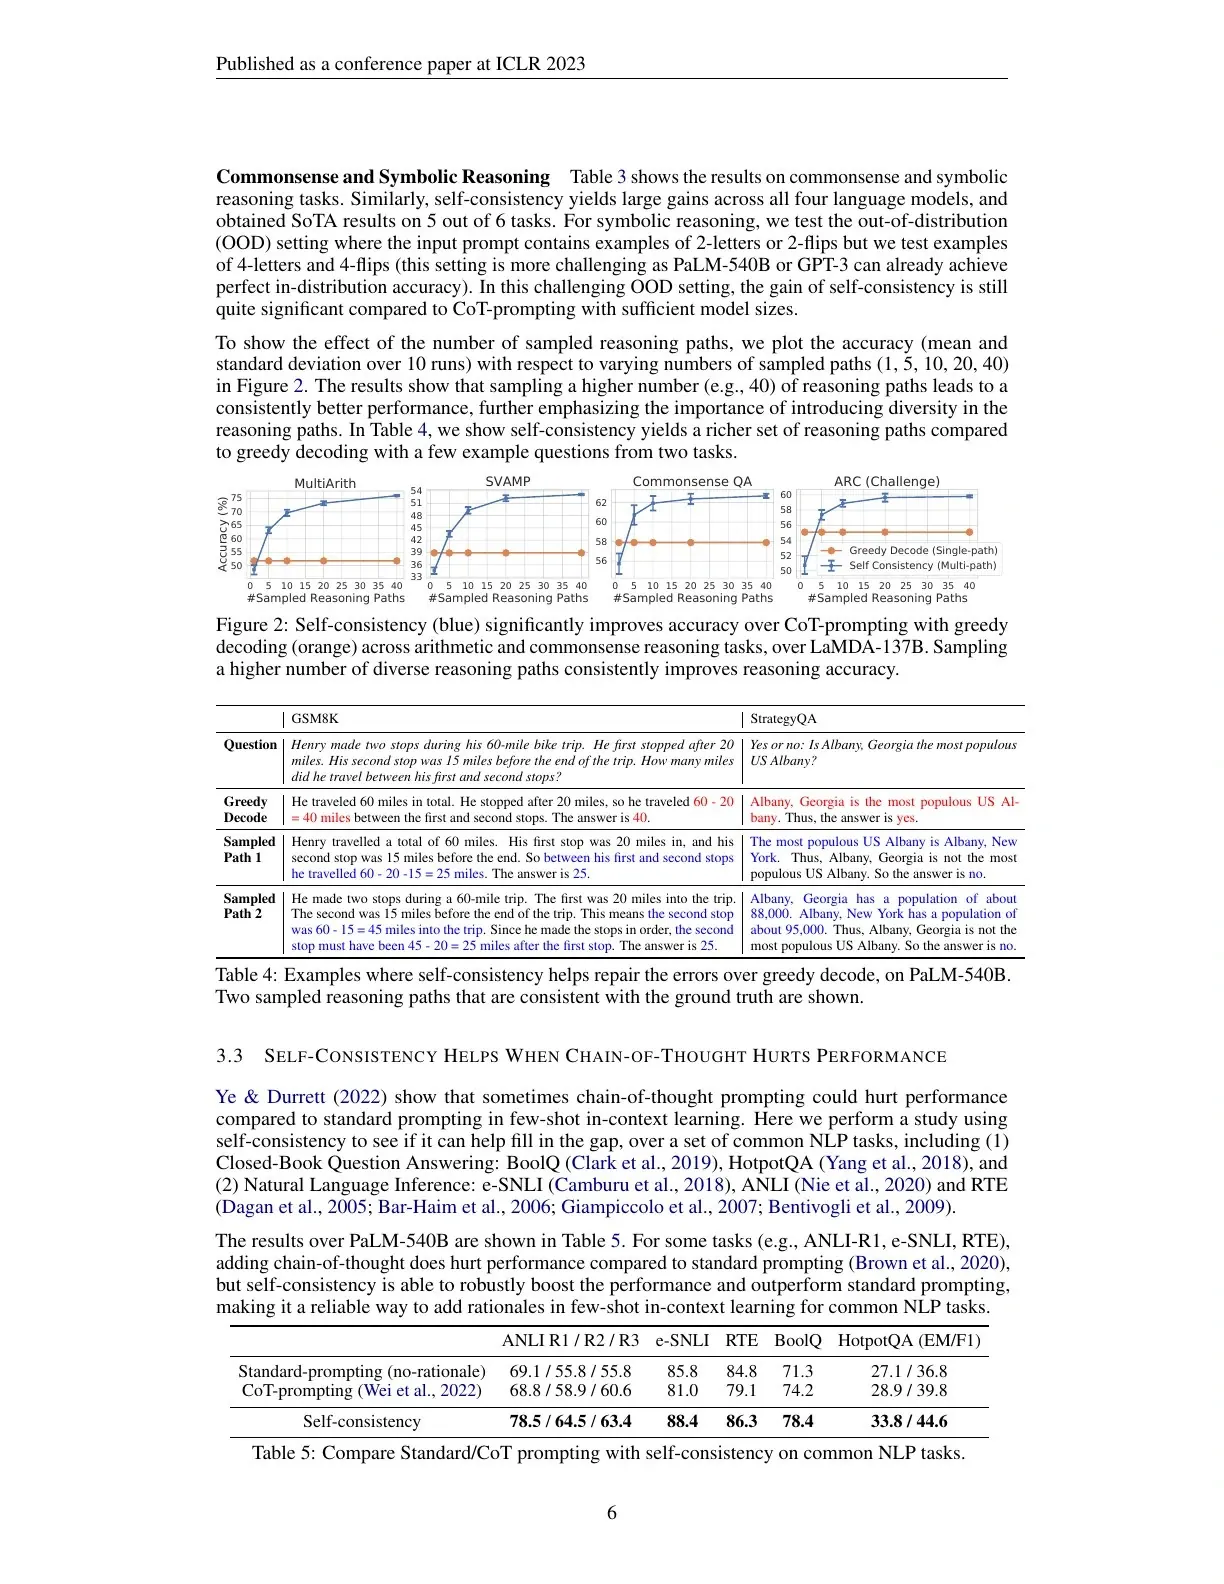
- 采样多条推理路径:不采用贪婪解码,而是用 温度采样(temperature sampling) 或 top-k / nucleus 采样,生成 m 条 不同的推理链(每条链包含推理过程 + 最终答案)。
- 答案汇总(marginalize):从 m 条路径中提取最终答案,通过 多数投票(majority vote) 选择最一致的答案作为最终输出。
形式化表述
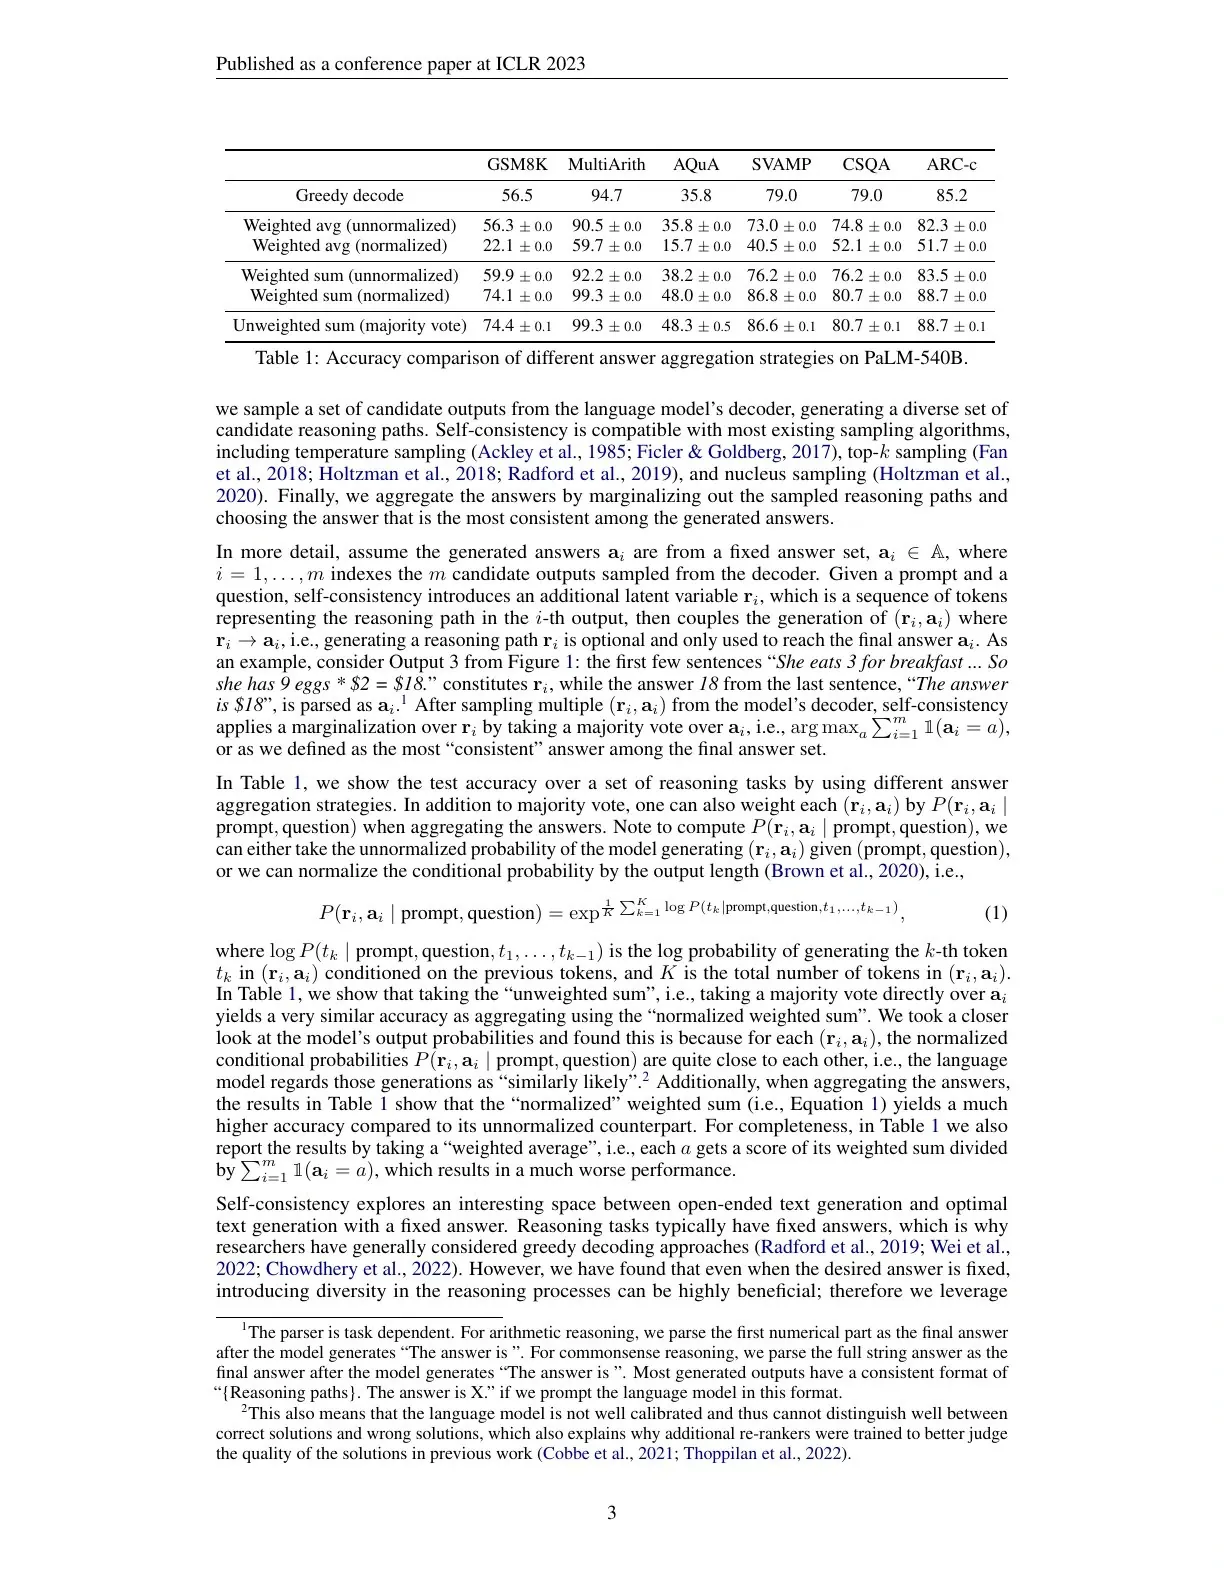
- 设第 i 条采样路径为
(r_i, a_i),其中r_i是推理过程,a_i是最终答案。 - 最终答案通过下式获得:
- 也可使用 归一化加权求和 (按生成概率加权),但实验显示多数投票已经足够好。
3. 关键实验与结果
评测任务
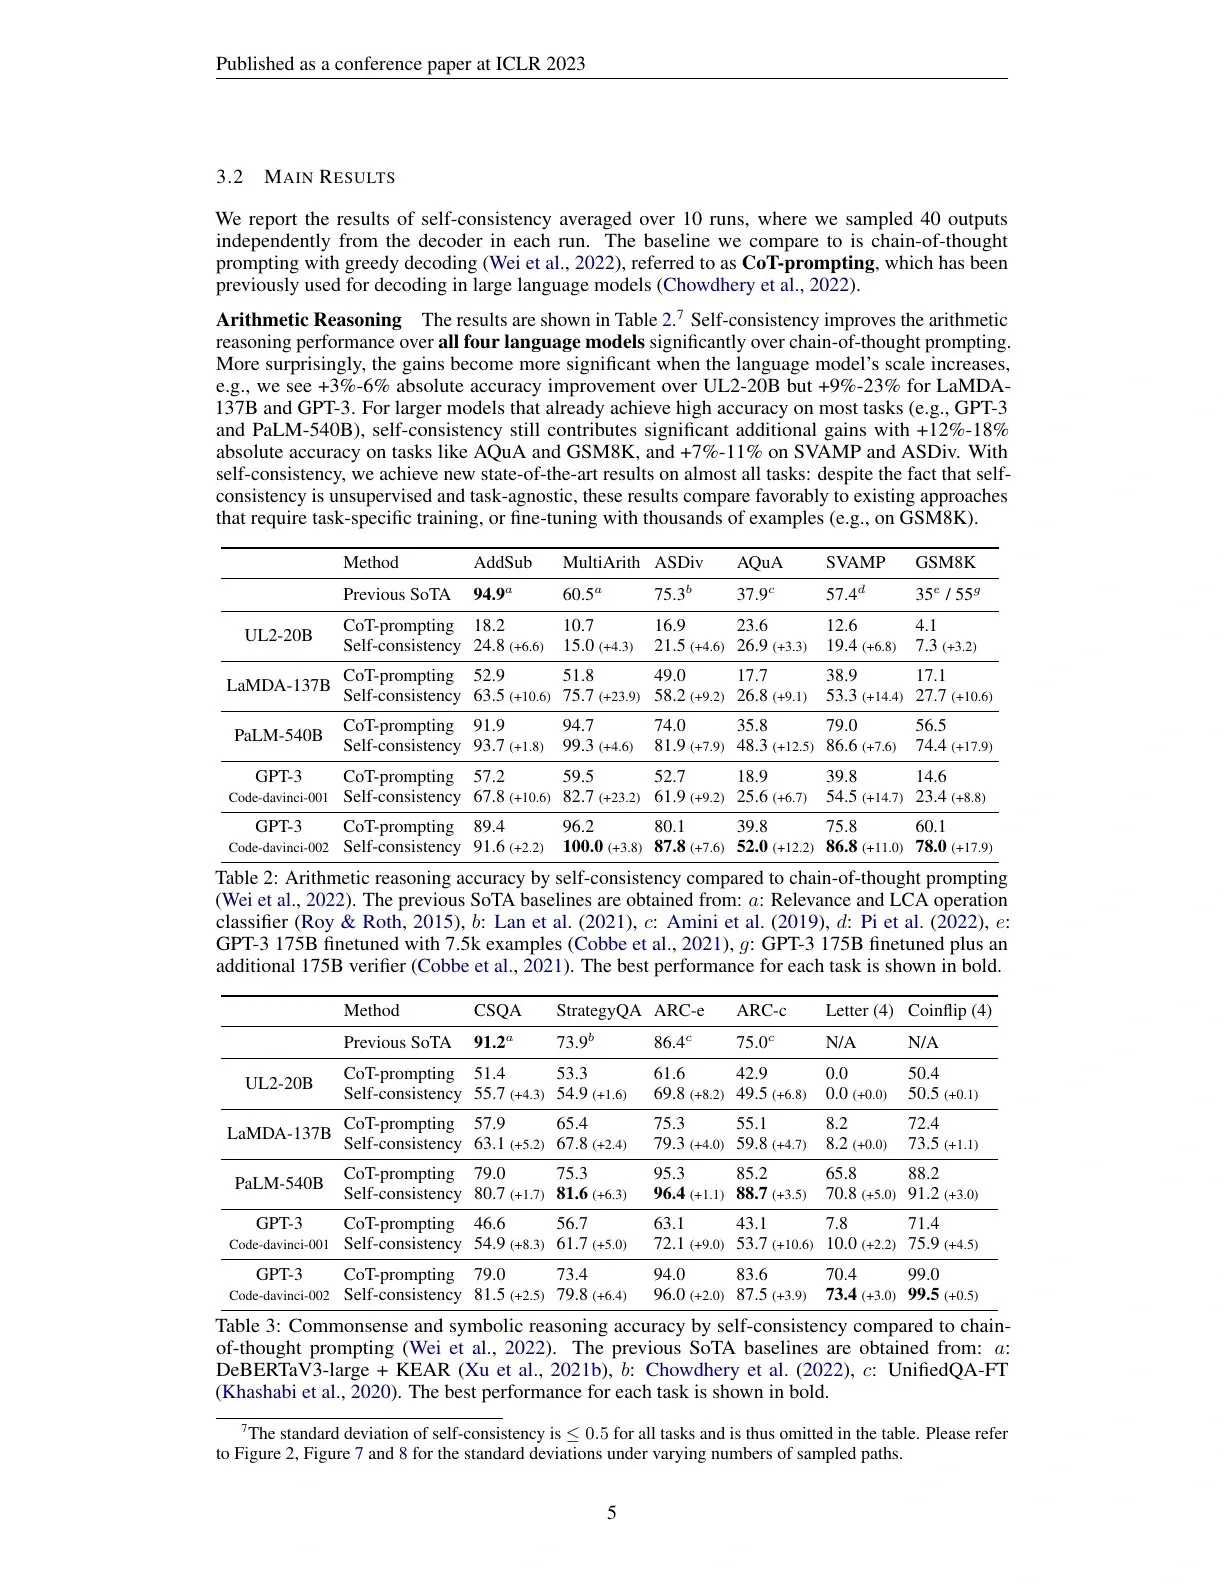
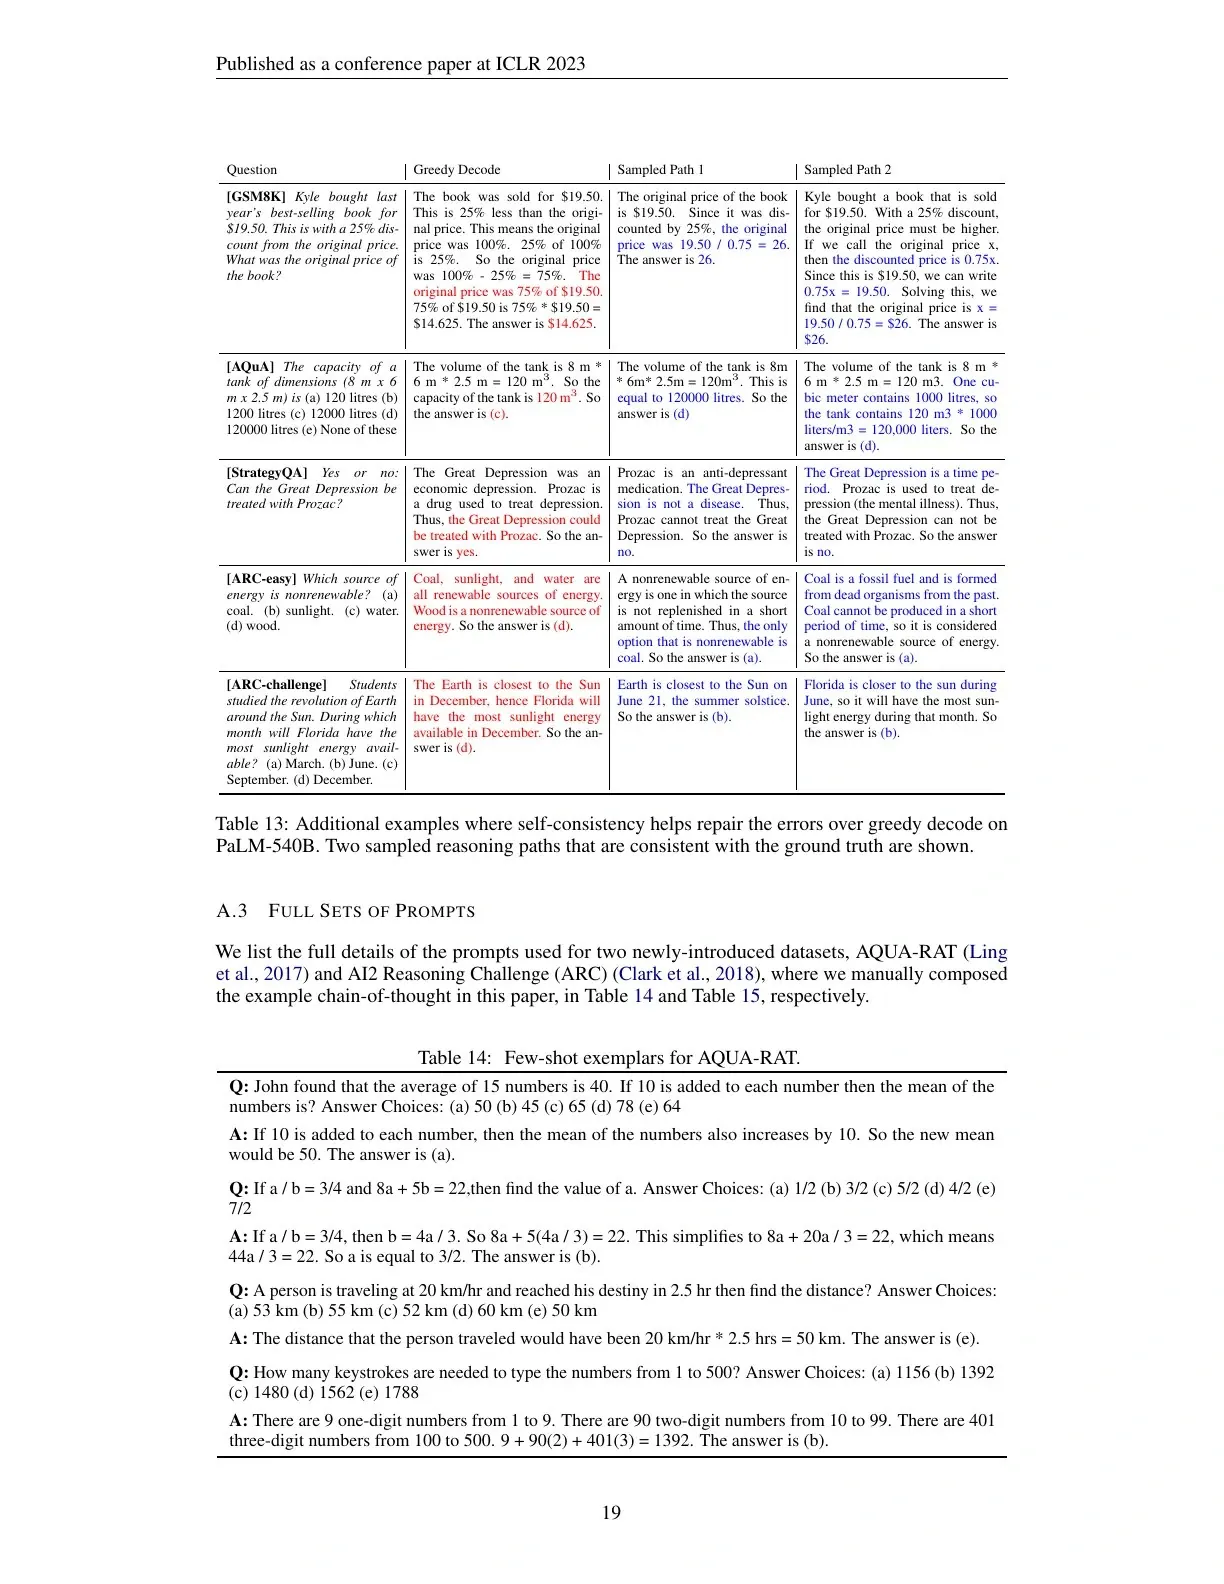
- 算术推理:GSM8K, SVAMP, AQuA, ASDiv, MultiArith, AddSub
- 常识推理:StrategyQA, ARC-challenge, CSQA
- 符号推理:Last letter concatenation, Coin flip
使用的模型
- UL2-20B, GPT-3 (175B), LaMDA-137B, PaLM-540B
主要结果(绝对准确率提升)
| 任务 | CoT (greedy) | Self-Consistency (40 paths) | 提升 |
|---|---|---|---|
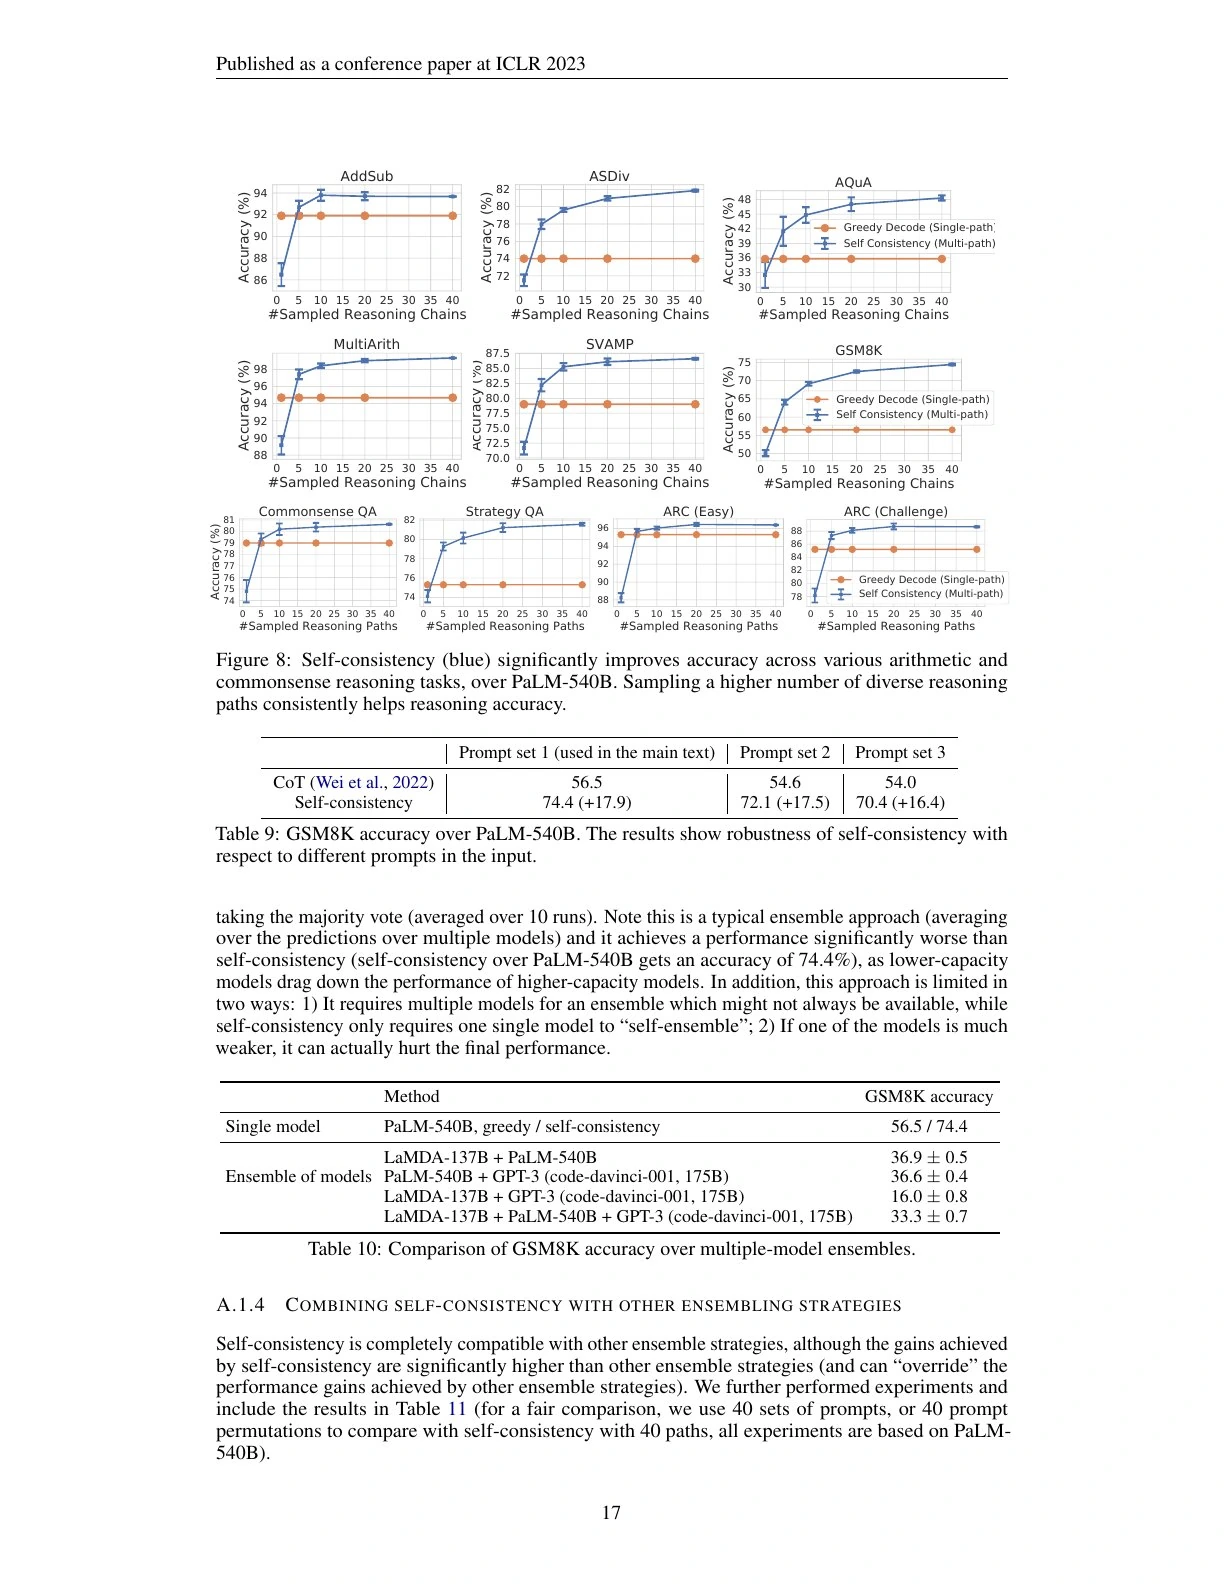
| GSM8K (PaLM-540B) | 56.5% | 74.4% | +17.9% |
| SVAMP (GPT-3) | 75.8% | 86.8% | +11.0% |
| AQuA (PaLM-540B) | 35.8% | 48.3% | +12.5% |
| StrategyQA (PaLM-540B) | 75.3% | 81.6% | +6.3% |
| ARC-challenge (GPT-3) | 83.6% | 87.5% | +3.9% |
其他关键发现
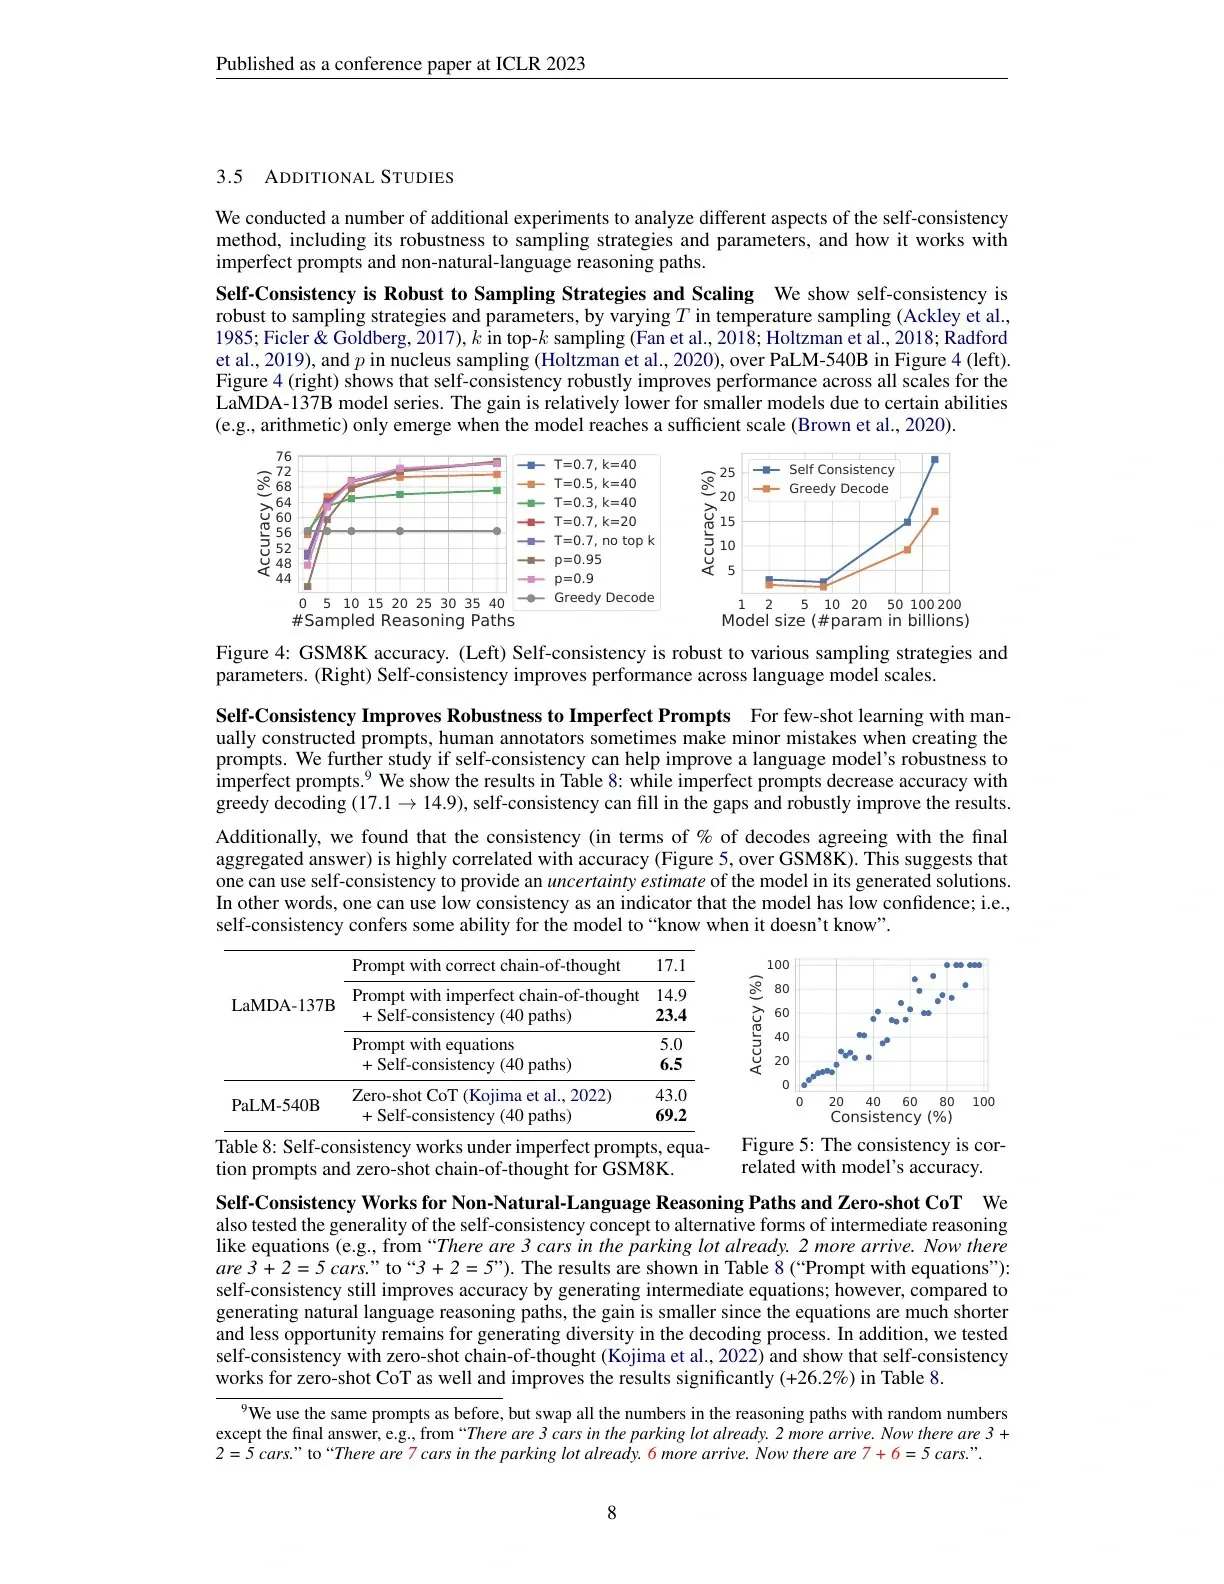
- 模型规模越大,收益越明显:小模型(< 20B)增益很小甚至为负,说明“采样+投票”依赖模型本身的推理能力。
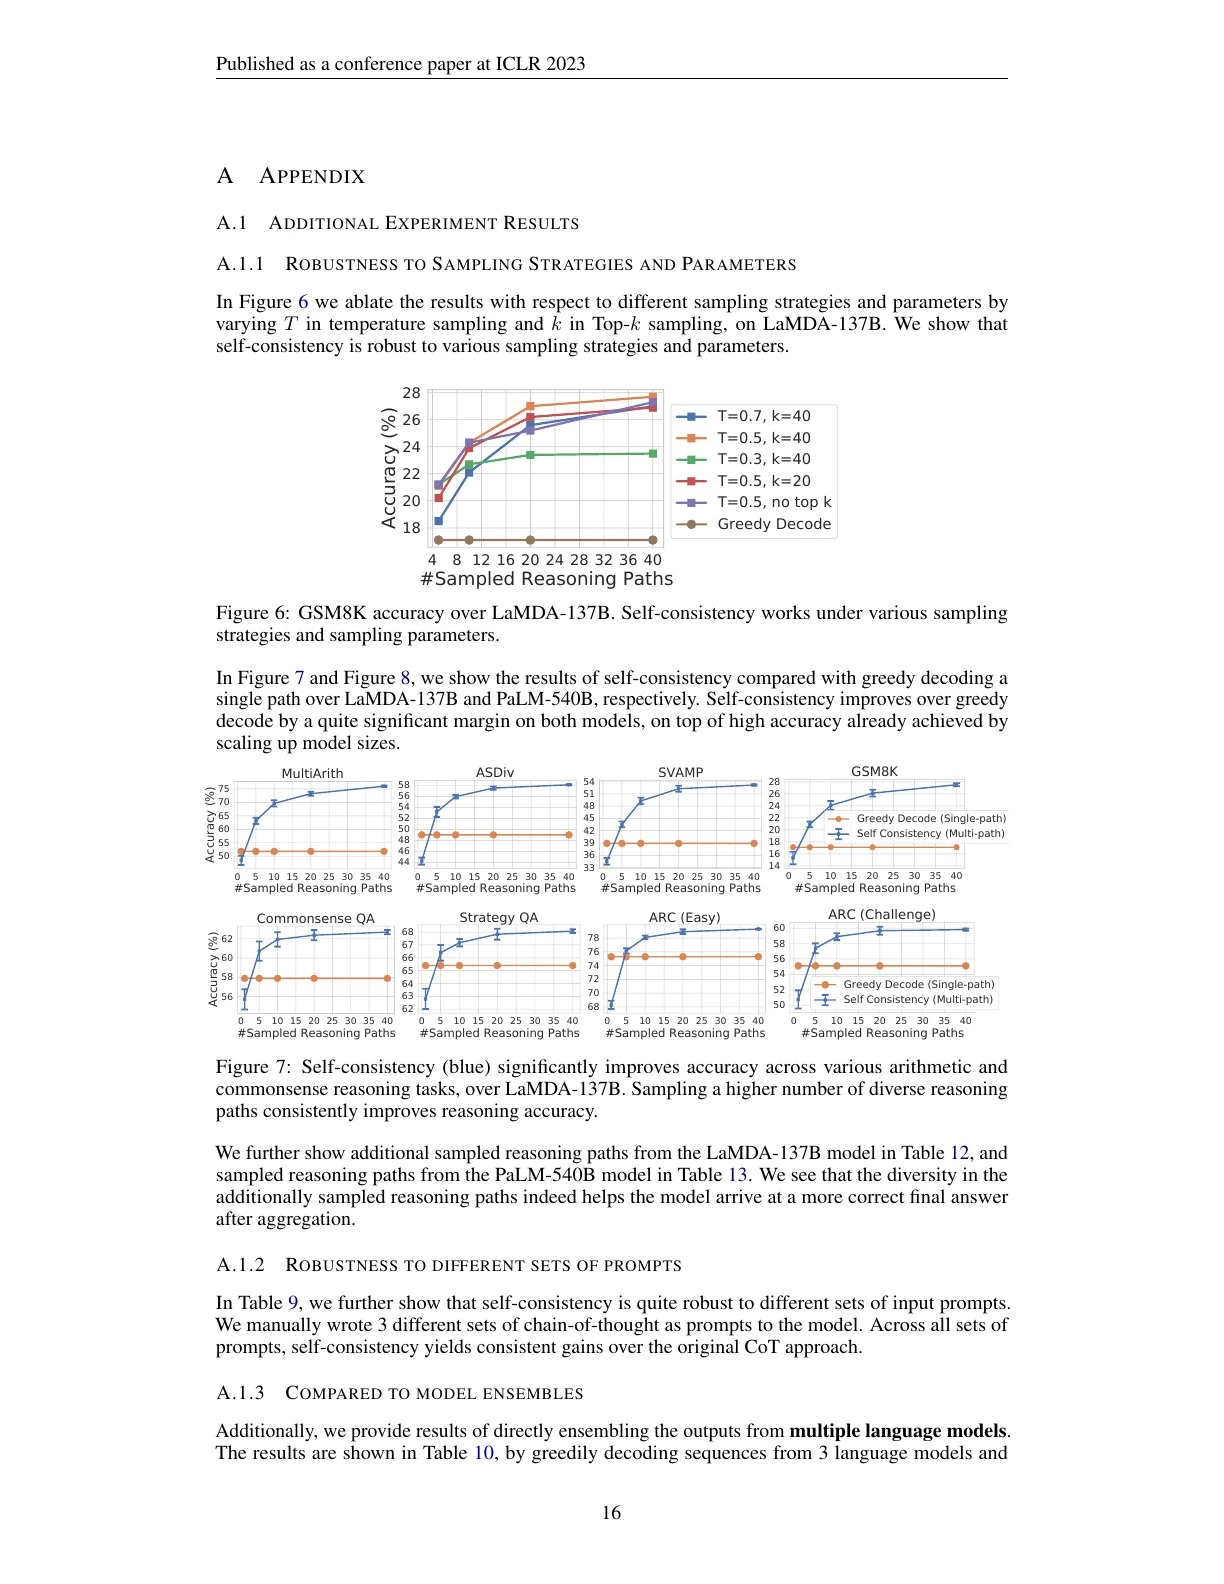
- 采样路径数:从 1 条增加到 40 条,准确率持续上升,但 10~20 条时已能获得大部分收益。
- 鲁棒性:对采样温度、top-k 参数、不完美的 prompt 均表现出较强的鲁棒性。
4. 与其他方法的对比
| 方法 | 是否需要训练 | 是否需要额外标注 | GSM8K 准确率 (PaLM-540B) |
|---|---|---|---|
| CoT (greedy) | 否 | 否 | 56.5% |
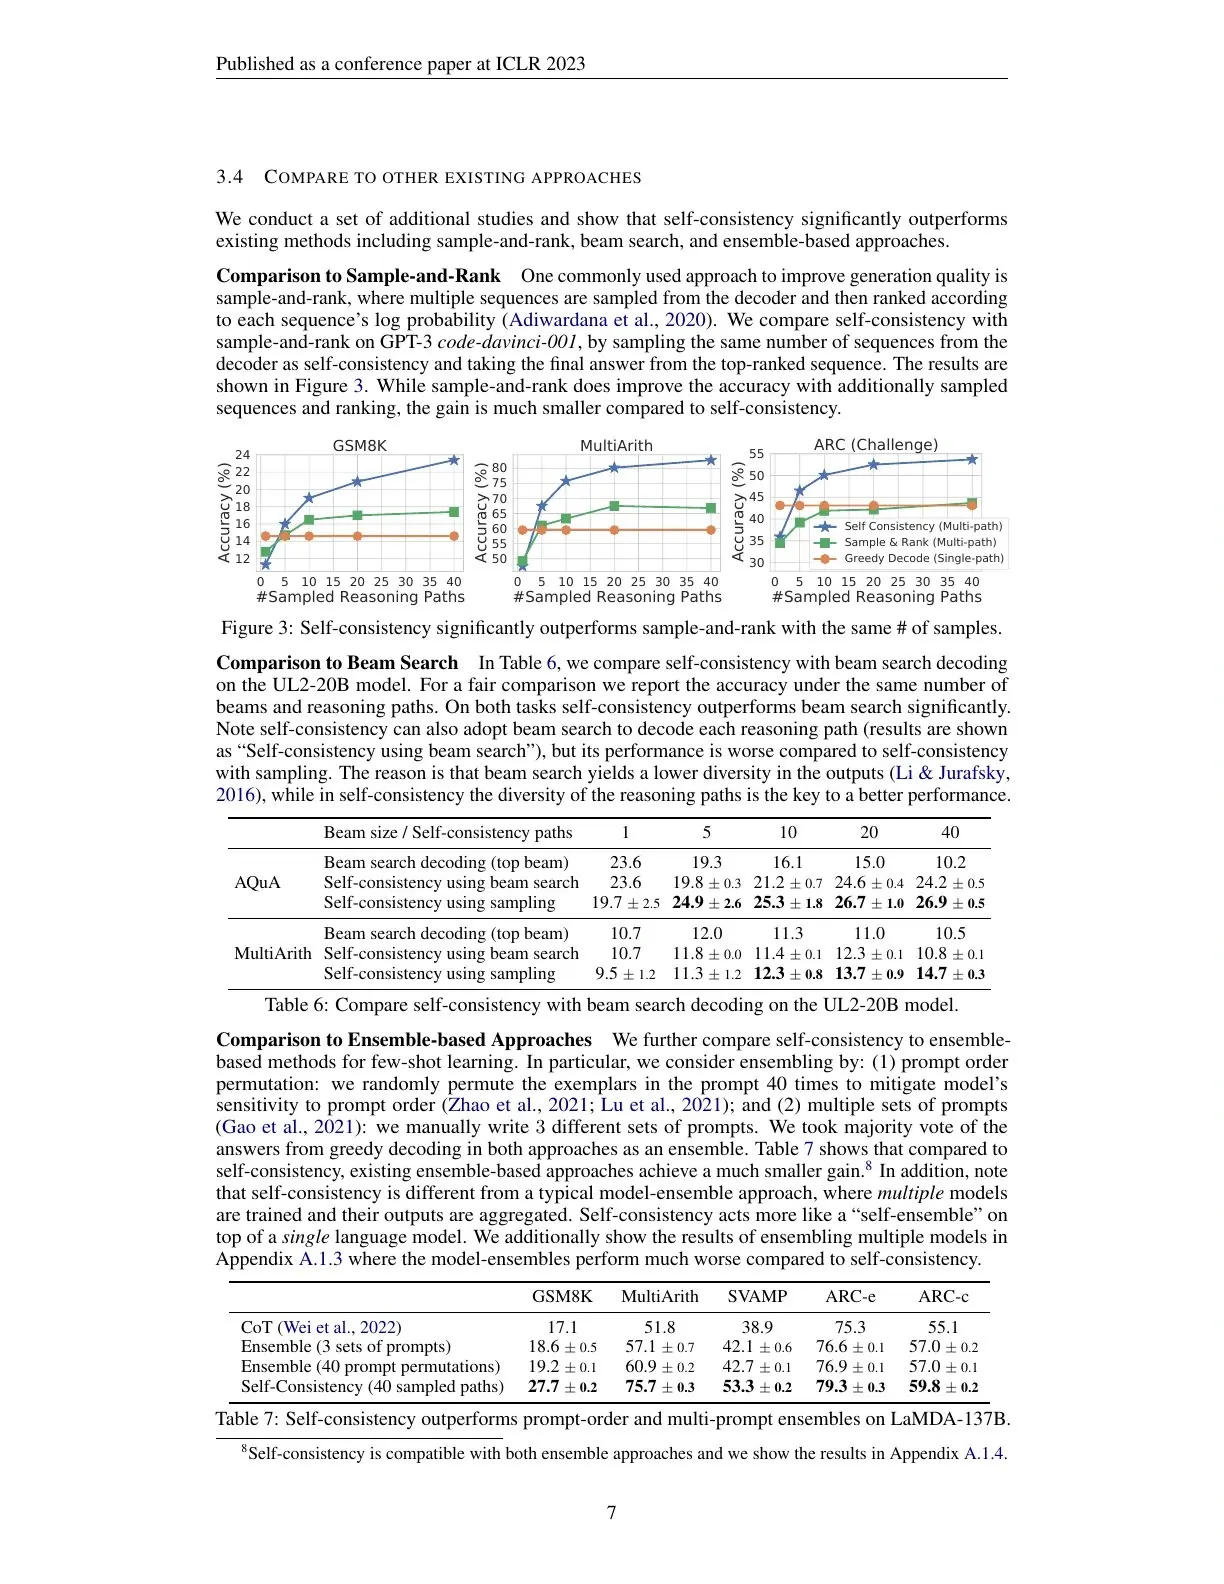
| 采样 + 排序(sample-and-rank) | 否 | 否 | 约 60% |
| 集束搜索(beam search) | 否 | 否 | 低于 self-consistency |
| 多 prompt 集成(ensemble) | 否 | 否 | 增益远小于 self-consistency |
| Self-Consistency | 否 | 否 | 74.4% |
- 对比结论:Self-Consistency 明显优于集束搜索(因集束搜索缺乏多样性)和简单的采样+排序。
5. 优点与局限性
优点
- 完全无监督:不需要训练、微调或额外标注。
- 即插即用:可直接用于任何已有 CoT 能力的模型。
- 提供不确定性估计:答案的一致性(投票集中度)可作为模型对答案置信度的指标。
局限性
- 计算成本高:需采样 10~40 条推理路径,相比单次 greedy 解码多出数倍开销。
- 依赖模型质量:若模型本身推理能力太弱,采样出的路径多为错误路径,投票无效。
- 仅适用于固定答案任务:对开放式生成任务(如写作、摘要)难以使用多数投票。
6. 核心贡献总结
- 首次系统性地提出 “采样多条推理路径 + 多数投票” 作为提升 CoT 性能的通用策略。
- 在多个 SOTA 模型和基准上验证了该策略的有效性和鲁棒性。
- 揭示了 “推理路径的多样性” 与 “最终答案准确性” 之间的正相关关系。
- 提供了一种简单、低成本的方法来估计模型的 输出置信度。
原论文在线预览
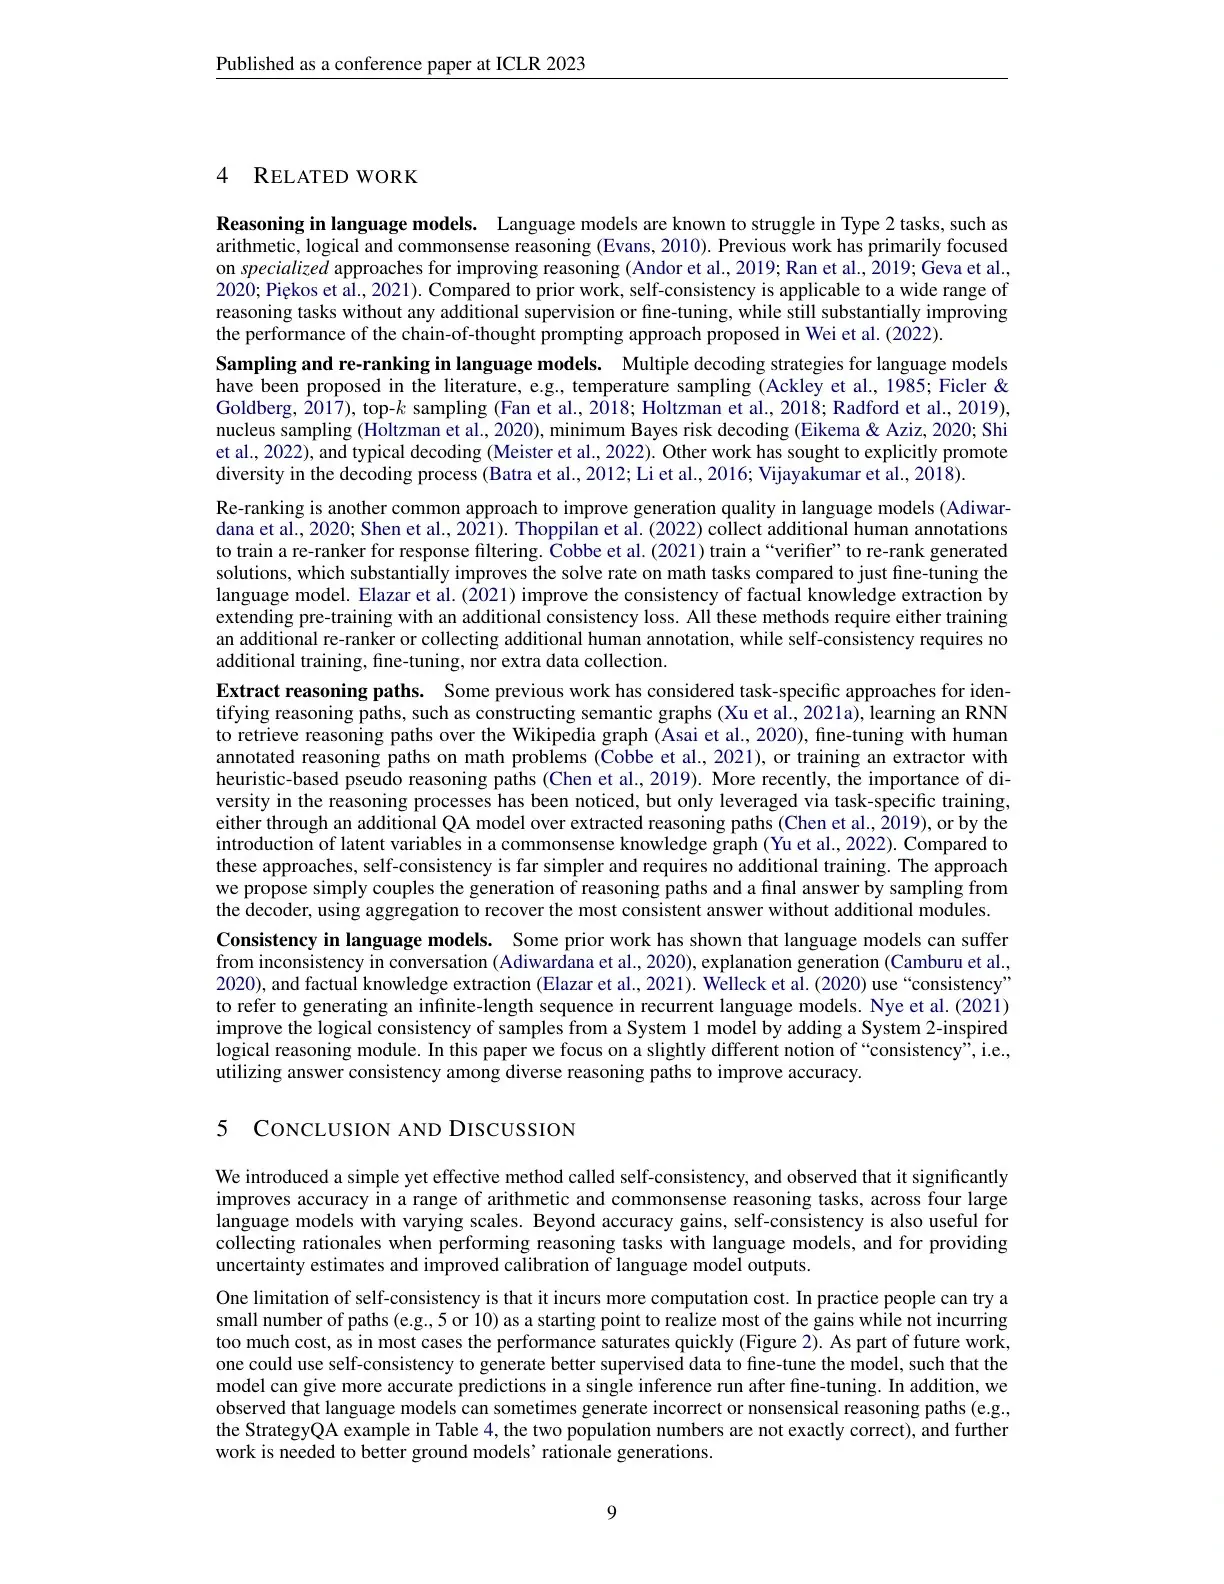
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
自我一致性
https://www.shanfengpm.com/posts/2026-02-17-paper-self-consistency/本文首发于「山风blog」,作者:山风(余涛)。欢迎转发、分享本文链接, 但禁止任何形式的未授权转载、摘编、改写或商业使用。

推荐文章论文阅读