主页 · 7
反思机制
不改任何参数,只把失败写成一段文字存进记忆,下次带着它再试。编程任务首次通过率 91%;消融实验显示,自生成测试的贡献比反思本身更大。
思维树
把思维链从一条线扩成一棵树,同时留几个候选,往前多看几步,走不通就退回来换分支。24 点游戏成功率从 4% 提到 74%,代价是调用次数翻倍。
自我一致性
同一份提示,只换解码方式:随机采四十条推理路径,忽略中间过程,只统计哪个最终答案出现得最多。GSM8K 准确率从 56.5% 提到 74.4%。
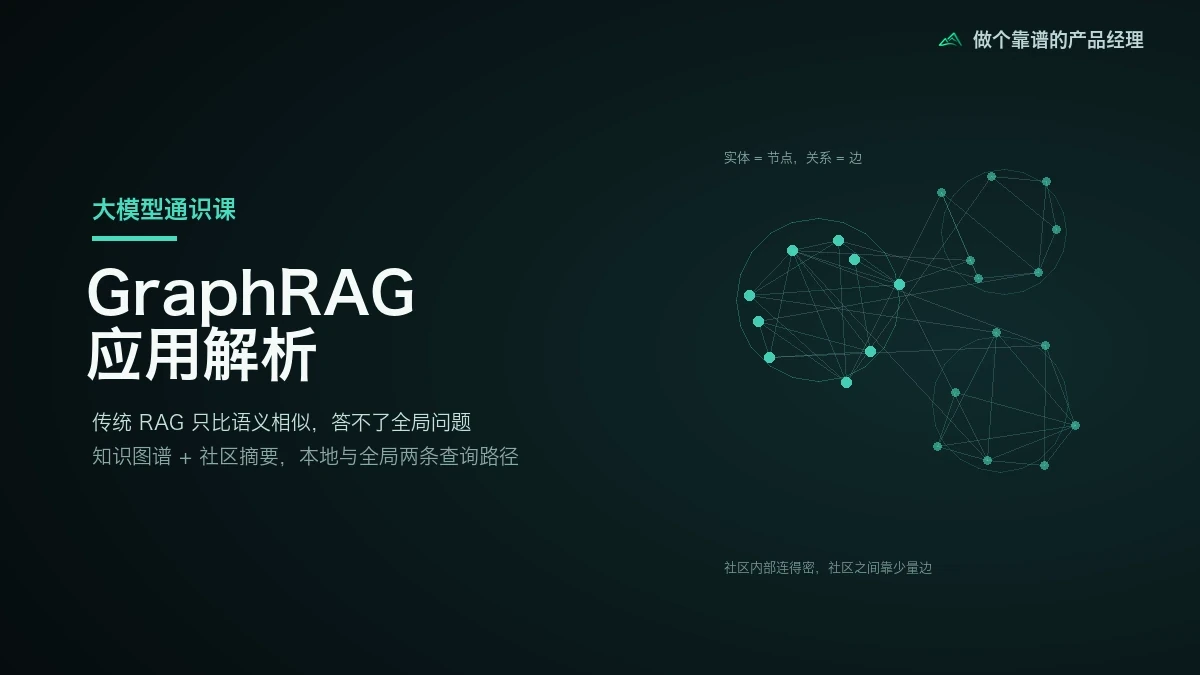
GraphRAG 应用解析
传统 RAG 只比语义相似,遇到「这本书讲了什么」这类全局问题就答不上来。GraphRAG 先把实体和关系抽成知识图谱,用 Leiden 划社区、逐层生成摘要,查询再分本地搜索与全局 Map-Reduce 两条路。
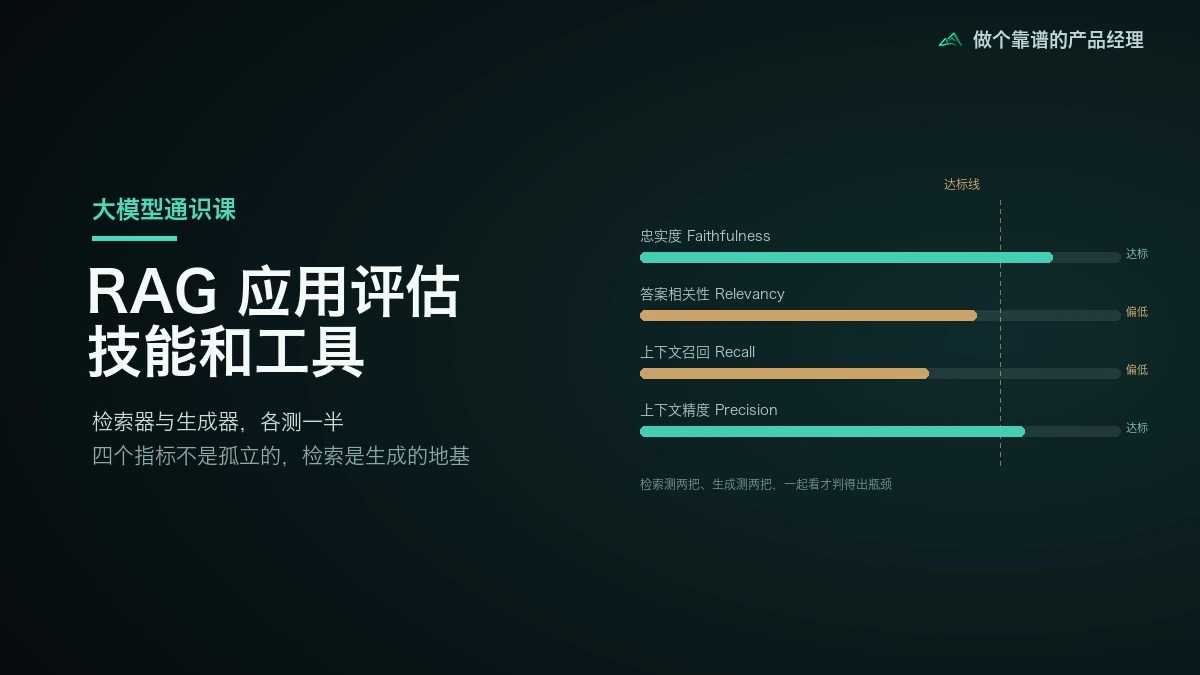
RAG 应用评估技能和工具
RAG 的输出不确定、知识库还在变,所以得先有评估依据:检索测上下文相关性与召回率,生成测忠实度与答案相关性。工具用 Ragas 和 TruLens,然后拿医疗问答、知识块大小、智能汽车挑战赛三个实战,把指标怎么指导优化走一遍。
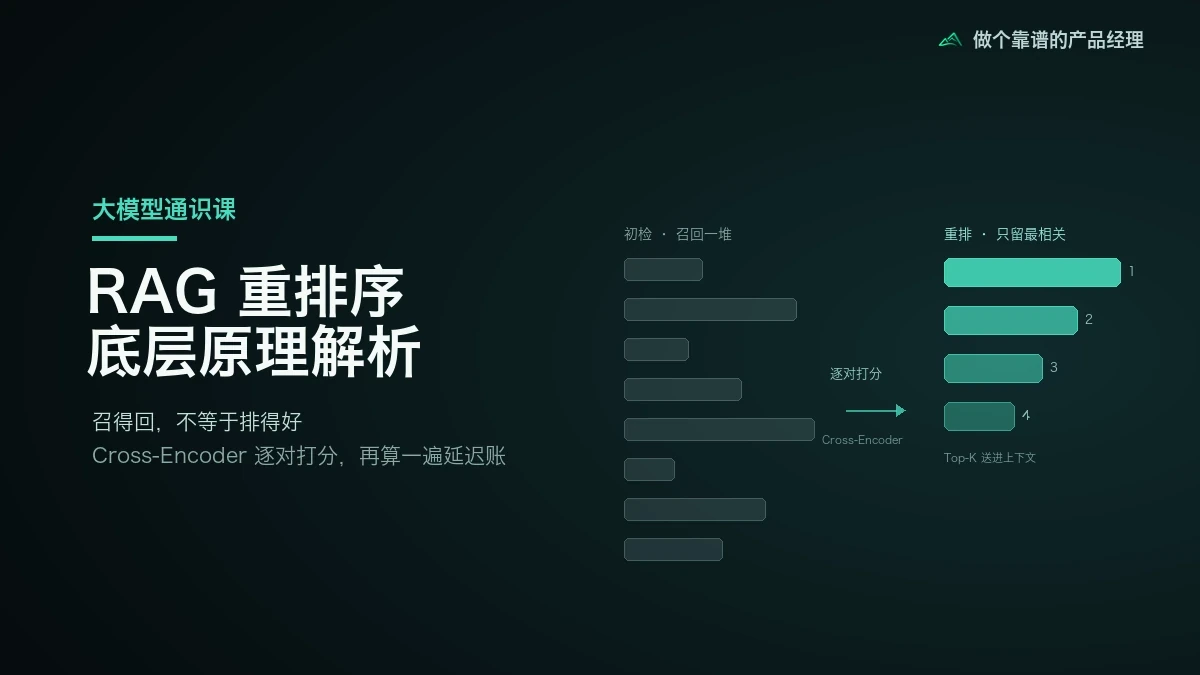
RAG 重排序底层原理解析
初步检索能召回,却不一定排得准。重排序是第二道过滤:Cross-Encoder 把问题和文档成对送进模型打分,再按分数重排,文末还算了一笔延迟成本。
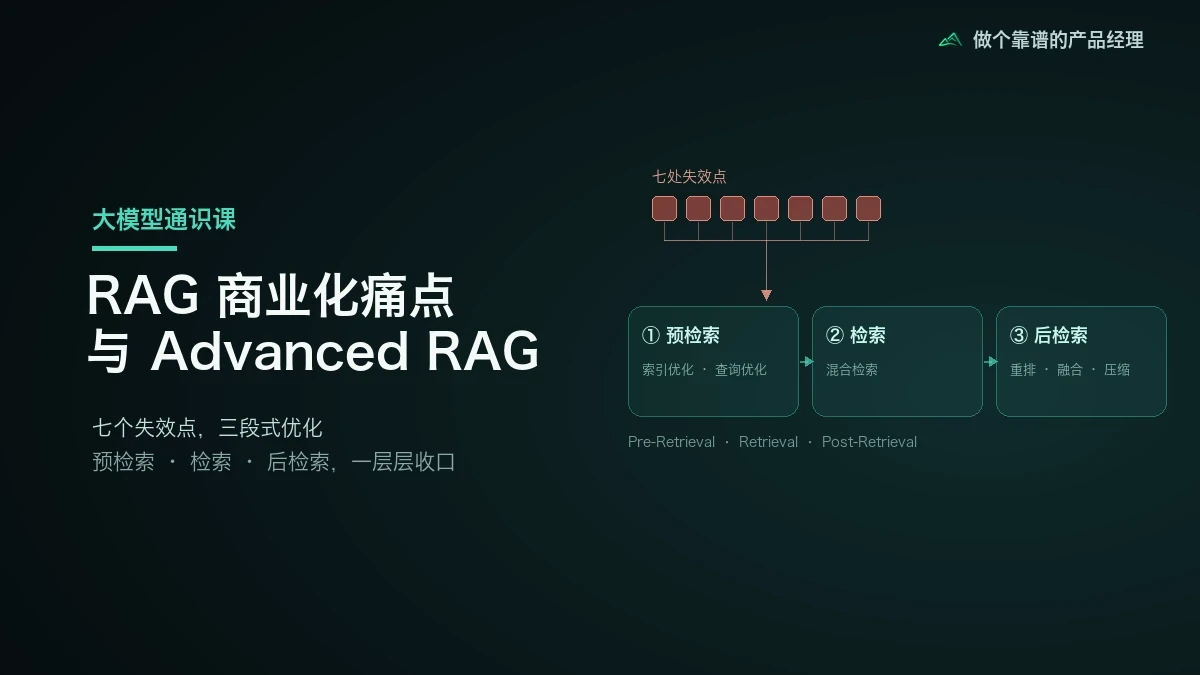
RAG 商业化痛点与 Advanced RAG
Naive RAG 上线容易,商用却难。文章借一篇论文摊开七个失效点,其中索引构建四个、检索增强三个,再给出 Pre-Retrieval、检索、Post-Retrieval 三段式框架。
向量检索算法
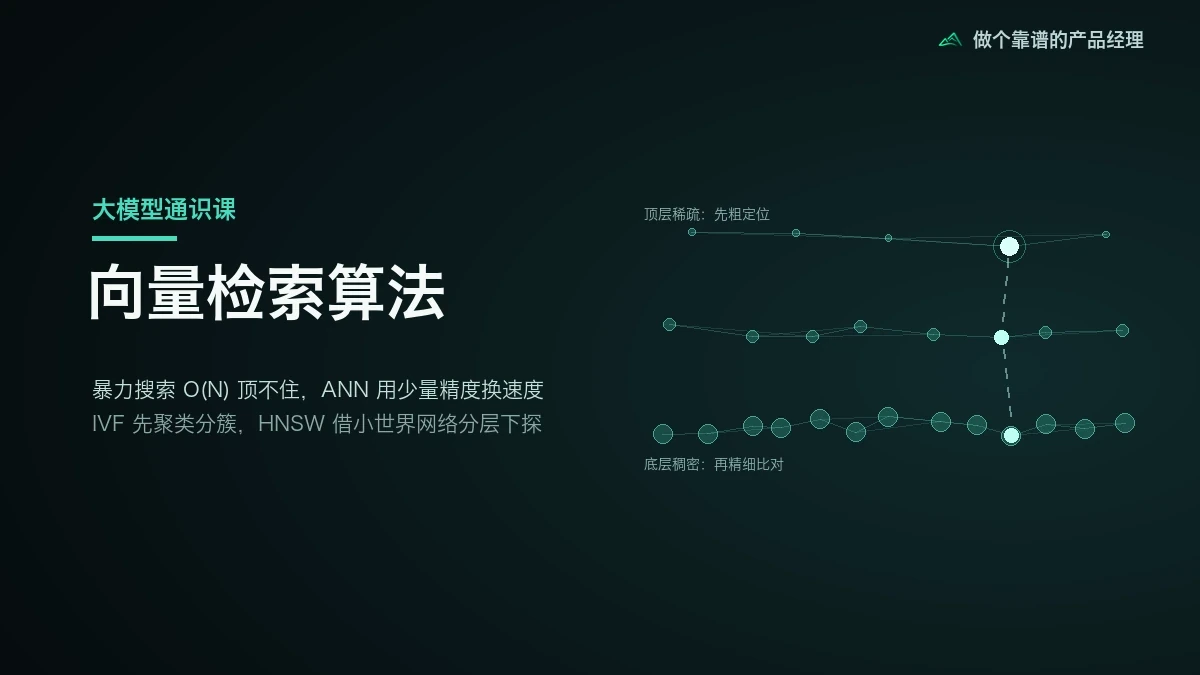
暴力搜索精度能到 100%,复杂度却是 O(N),数据一多就慢到不能用。IVF 先聚类分簇、查询只比质心,HNSW 用分层图逐层下探,文末附一张选型对比表。
RAG 的分块策略
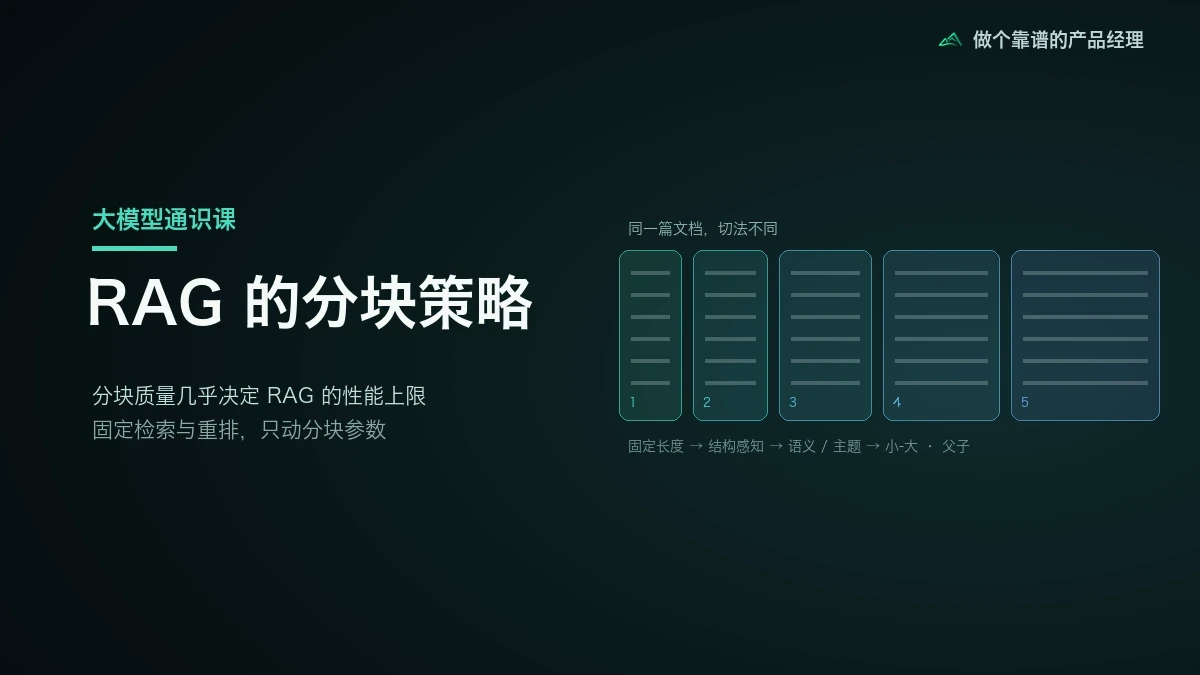
分块切得好不好,几乎决定 RAG 的上限,换更强的模型也补不回来。五种策略从固定长度排到父子索引,最后落在一句话上:固定检索,只动分块参数。
Naive RAG 构建流程与应用实践
给大模型外挂一个知识库。先讲为什么需要 RAG,再走索引化、检索、增强生成三步;向量化用 BGE-M3,向量库用 Chroma,最后配两个实战案例。