往期
推荐阅读
暂无相关文章
本书目录
01
序言
02
第 1 章 · 认知困局
03
第 2 章 · 产品观
04
第 3 章 · 需求观
05
第 4 章 · 用户观
06
第 5 章 · 认知融合
07
第 6 章 · 问题定义
08
第 7 章 · 体验设计
09
第 8 章 · 数据证据
10
第 9 章 · 技术认知
11
第 10 章 · 决策沟通
12
第 11 章 · 路线图与优先级
13
第 12 章 · 场景建模
14
第 13 章 · 能力抽象
15
第 14 章 · 平台架构
16
第 15 章 · 商业思维
17
第 16 章 · 市场分析
18
第 17 章 · 增长思维
19
第 18 章 · 产品运营
20
第 19 章 · 项目协作
21
第 20 章 · 组织能力
22
第 21 章 · 长期价值
23
后记
文章目录
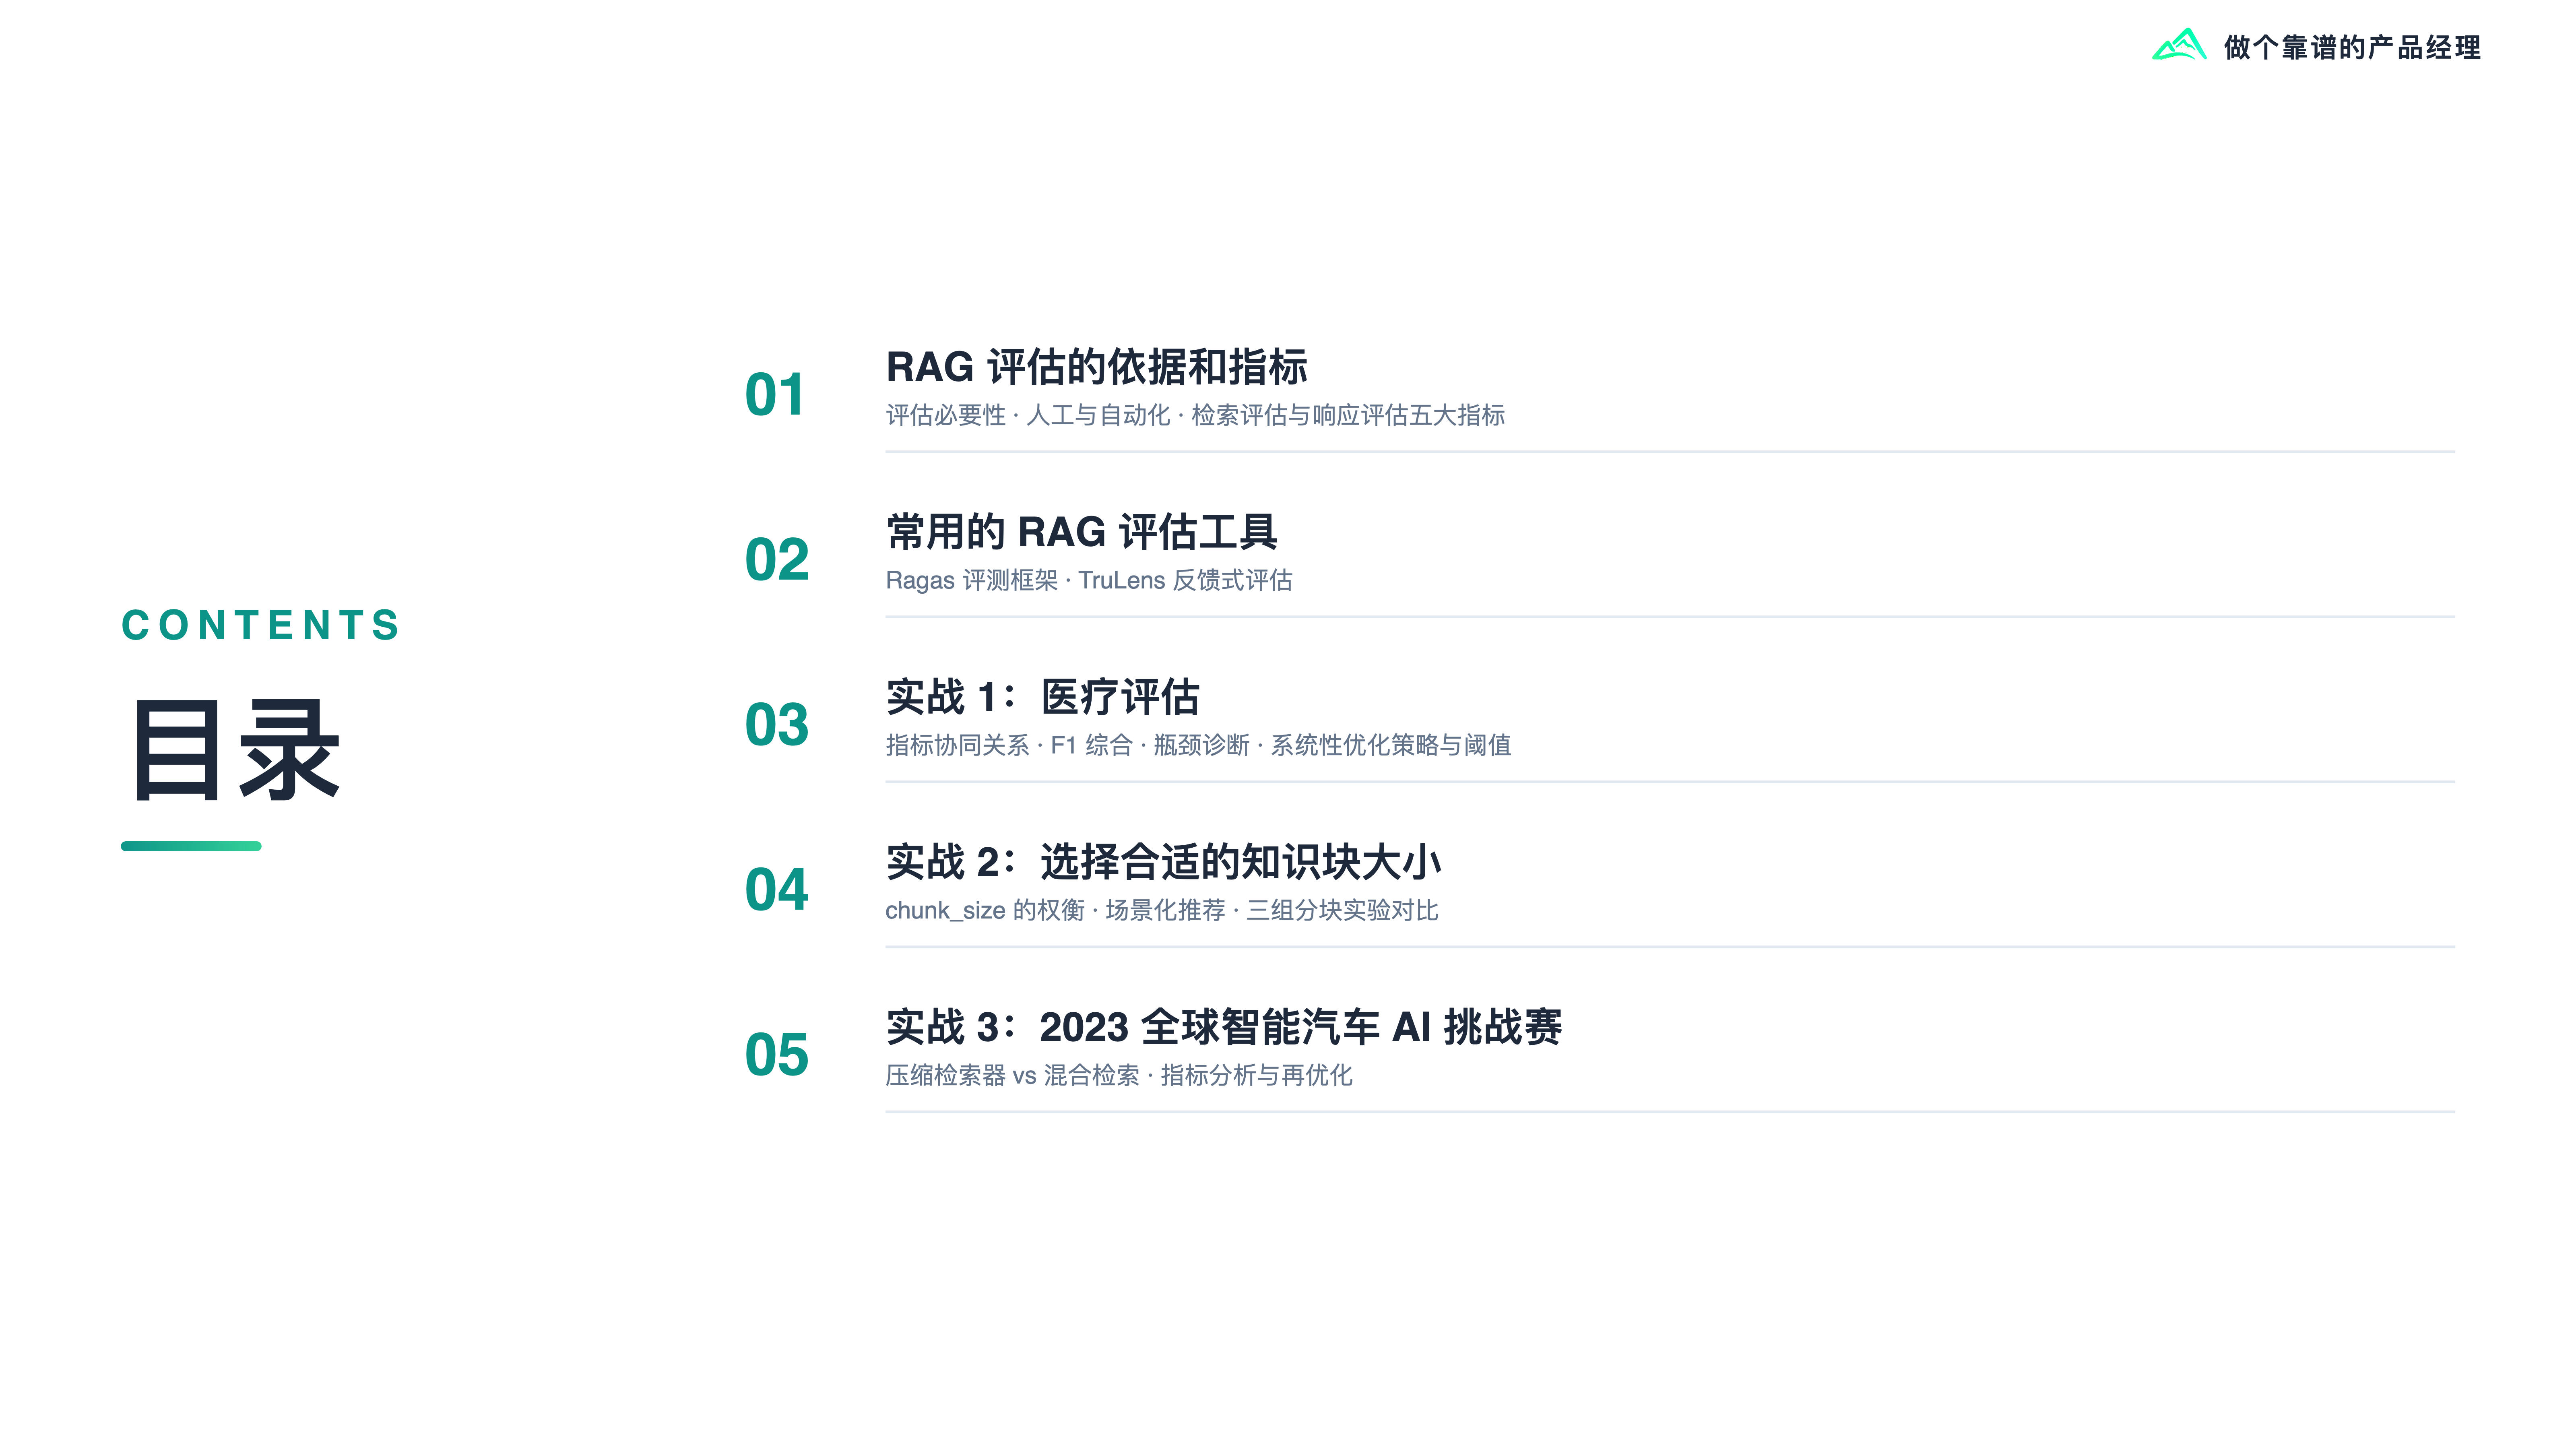
1
RAG 评估的依据和指标
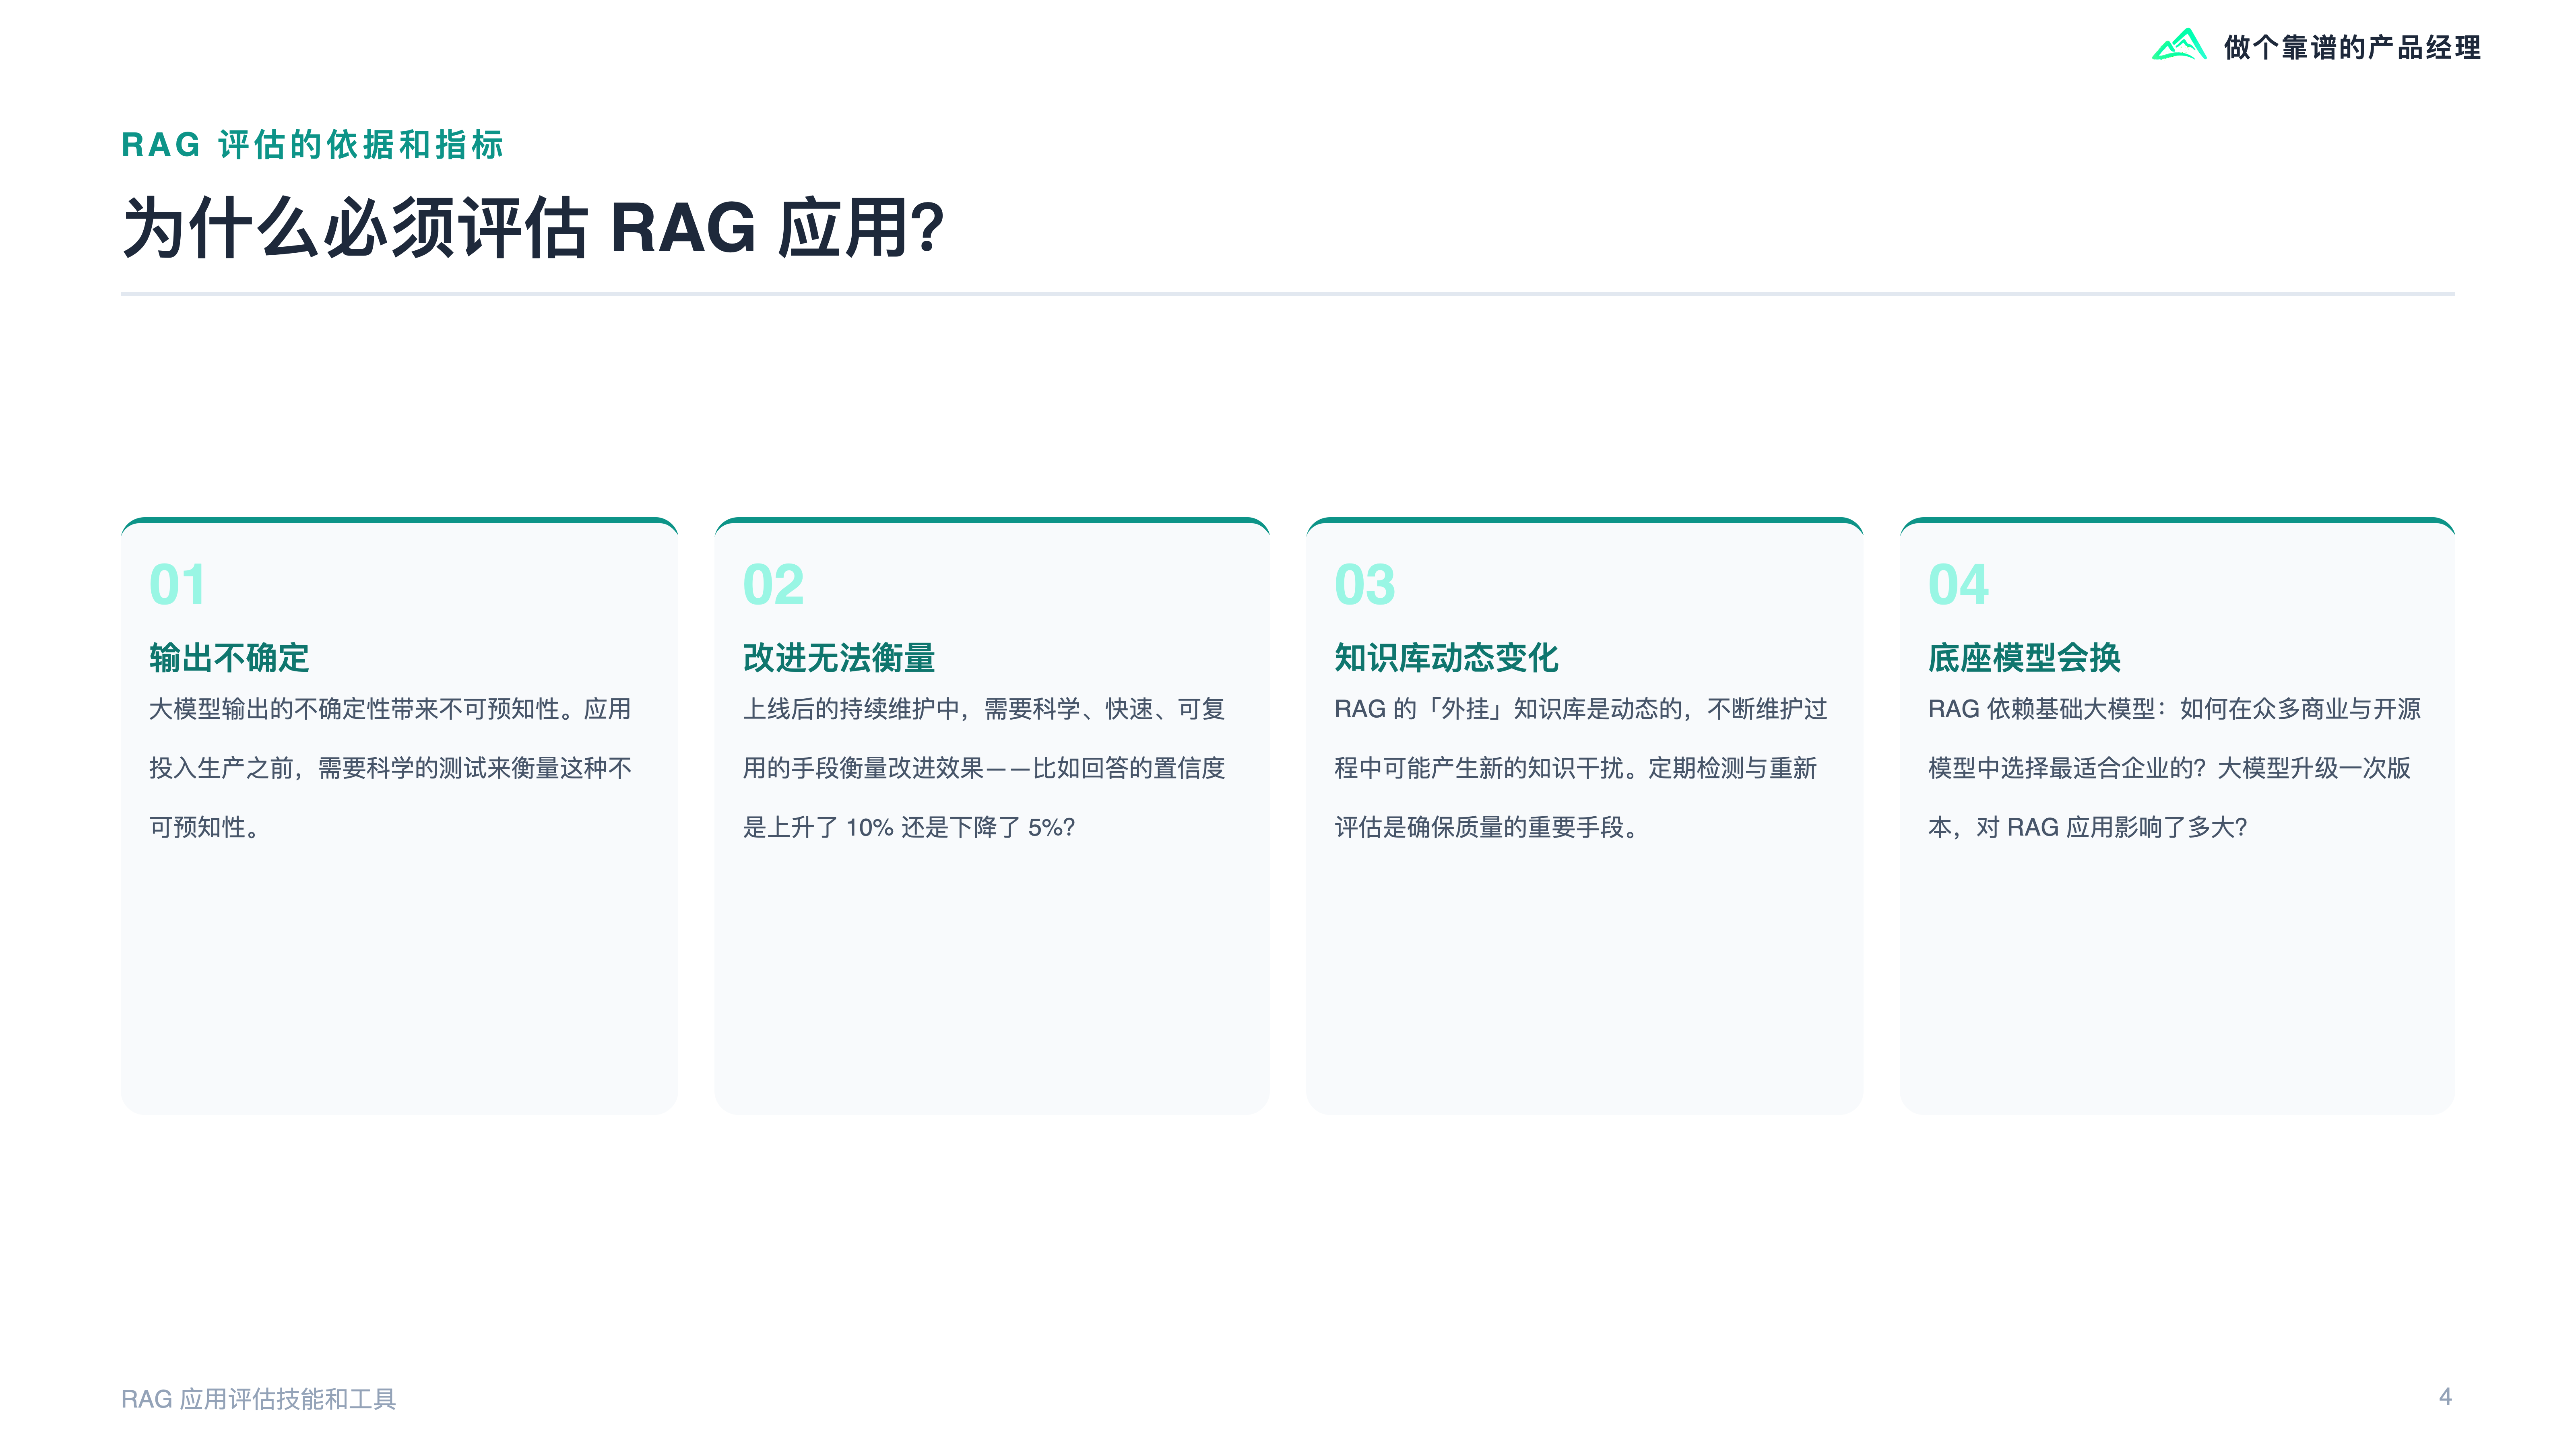
为什么必须评估 RAG 应用?
两种评估方法:人工评估 vs 自动化评估
评估什么:检索器与生成器,缺一不可
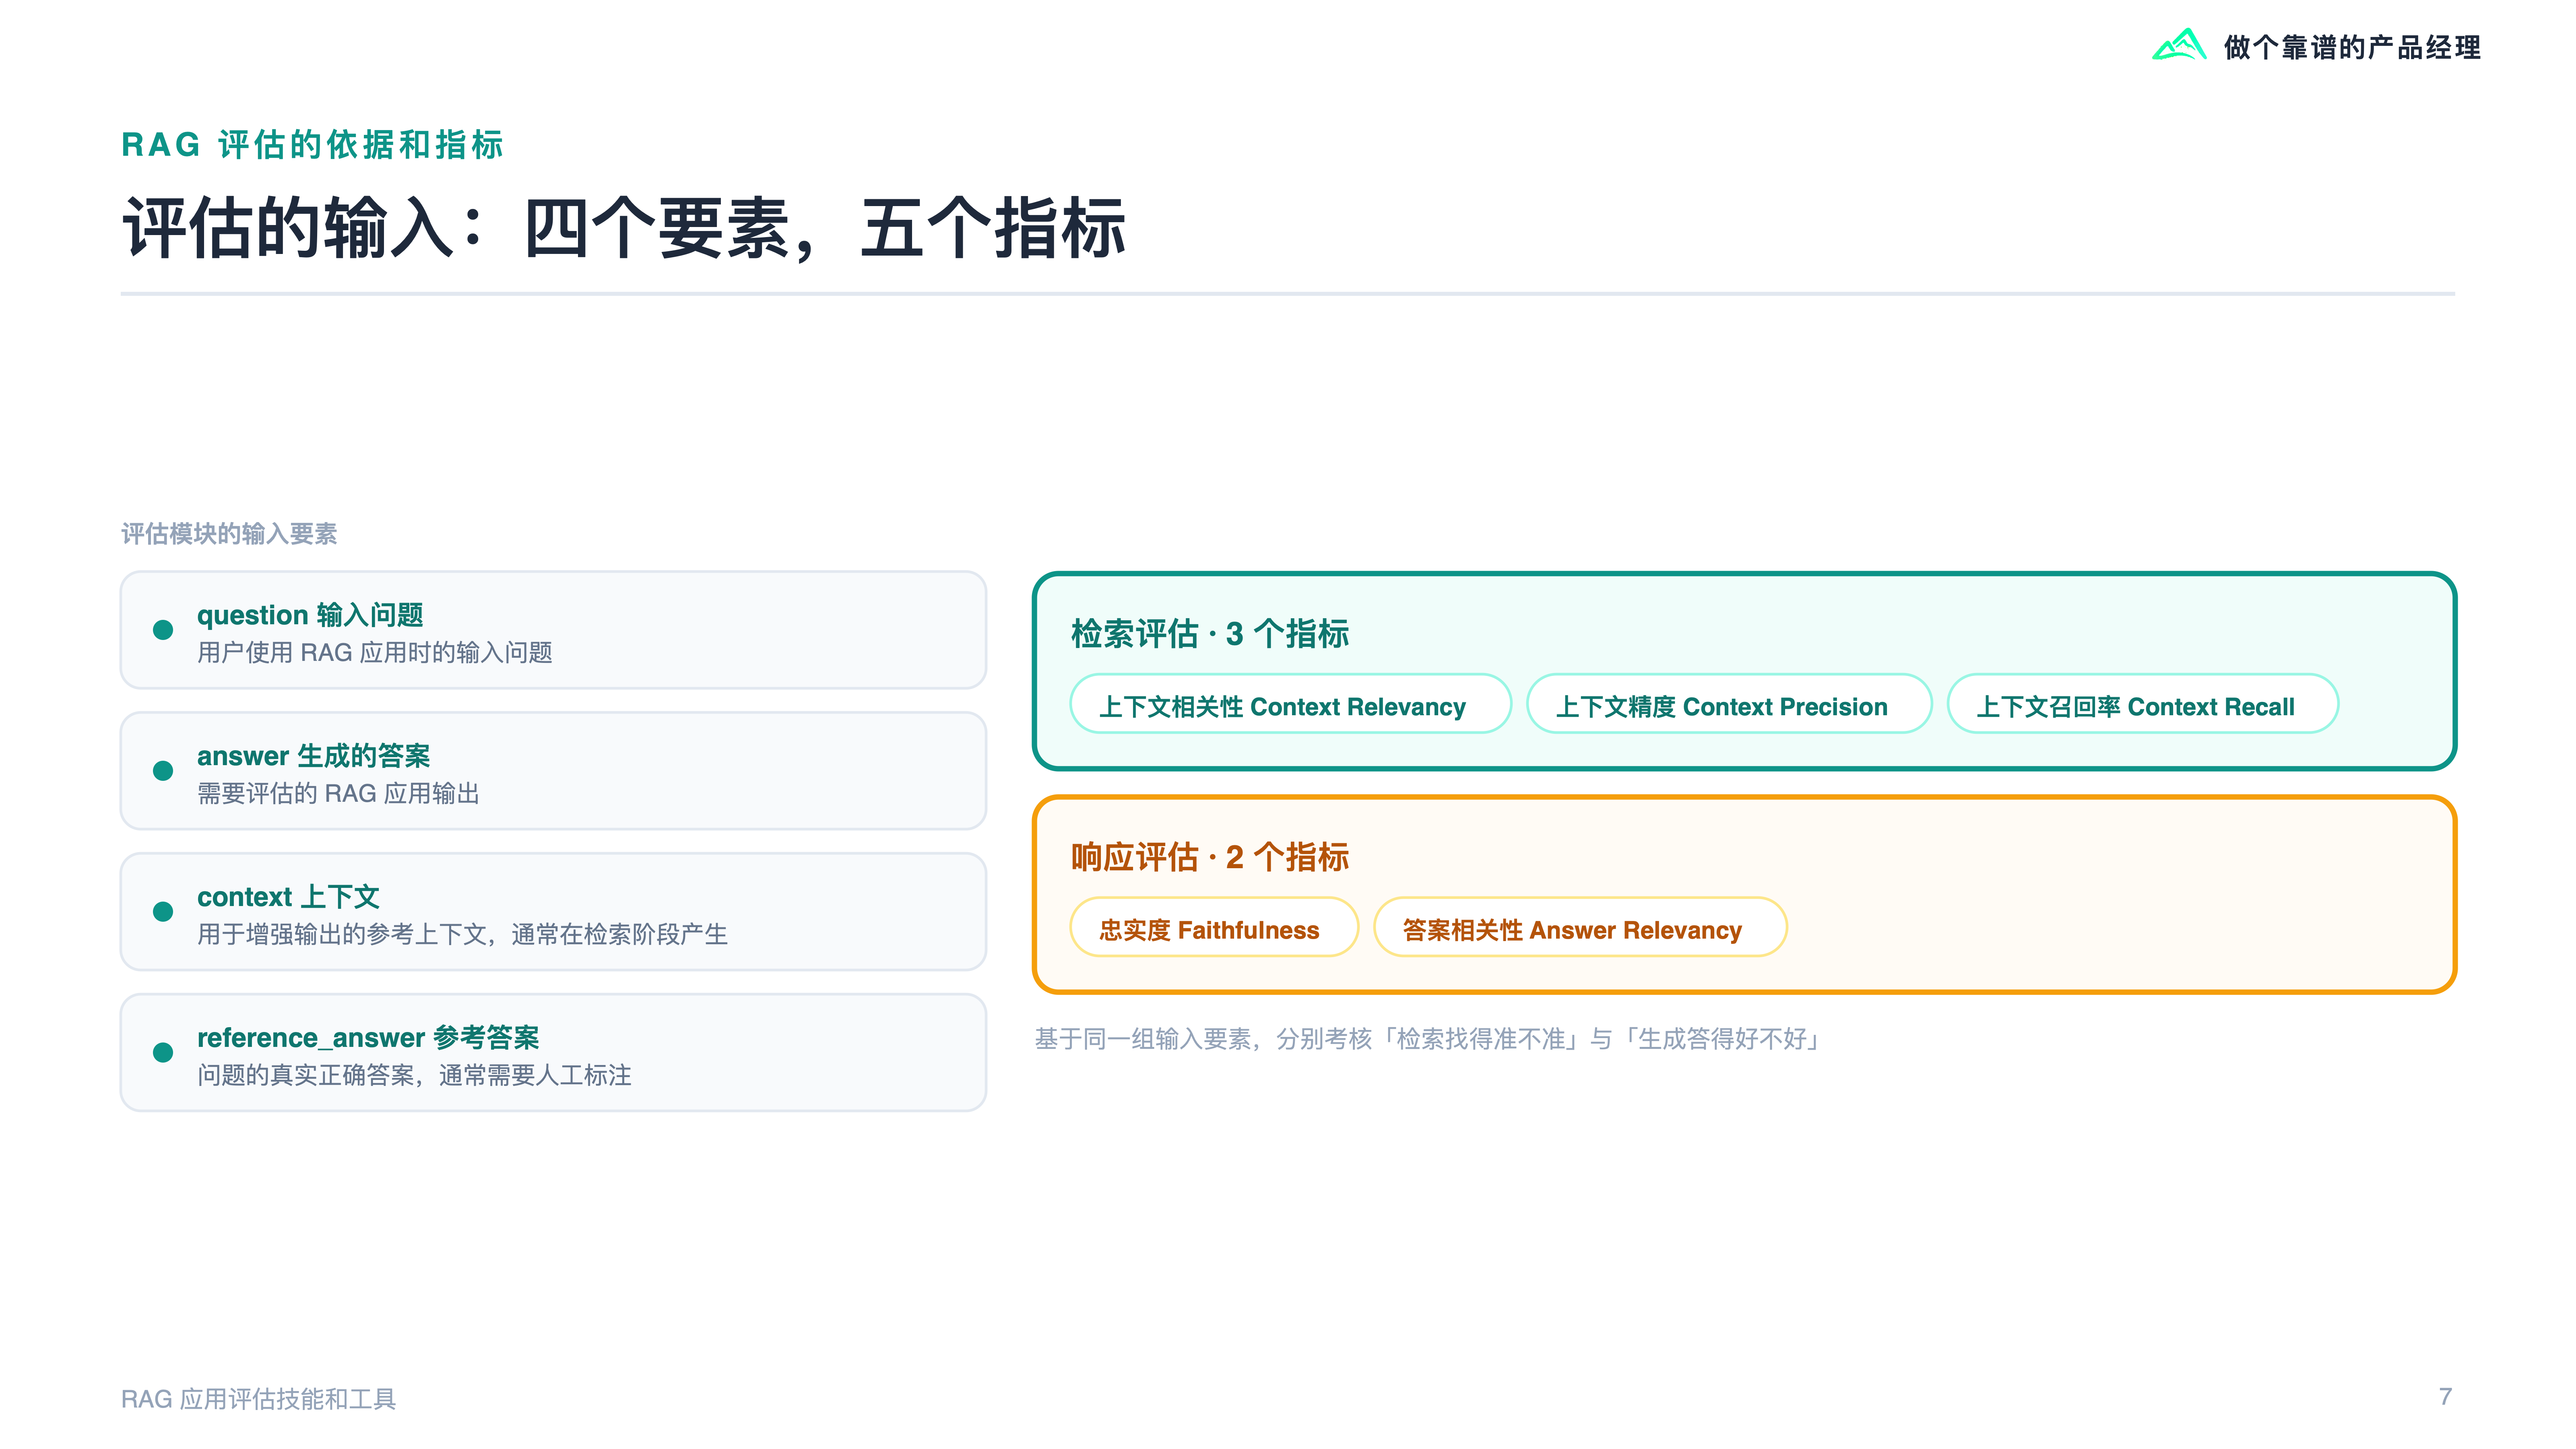
评估的输入:四个要素,五个指标
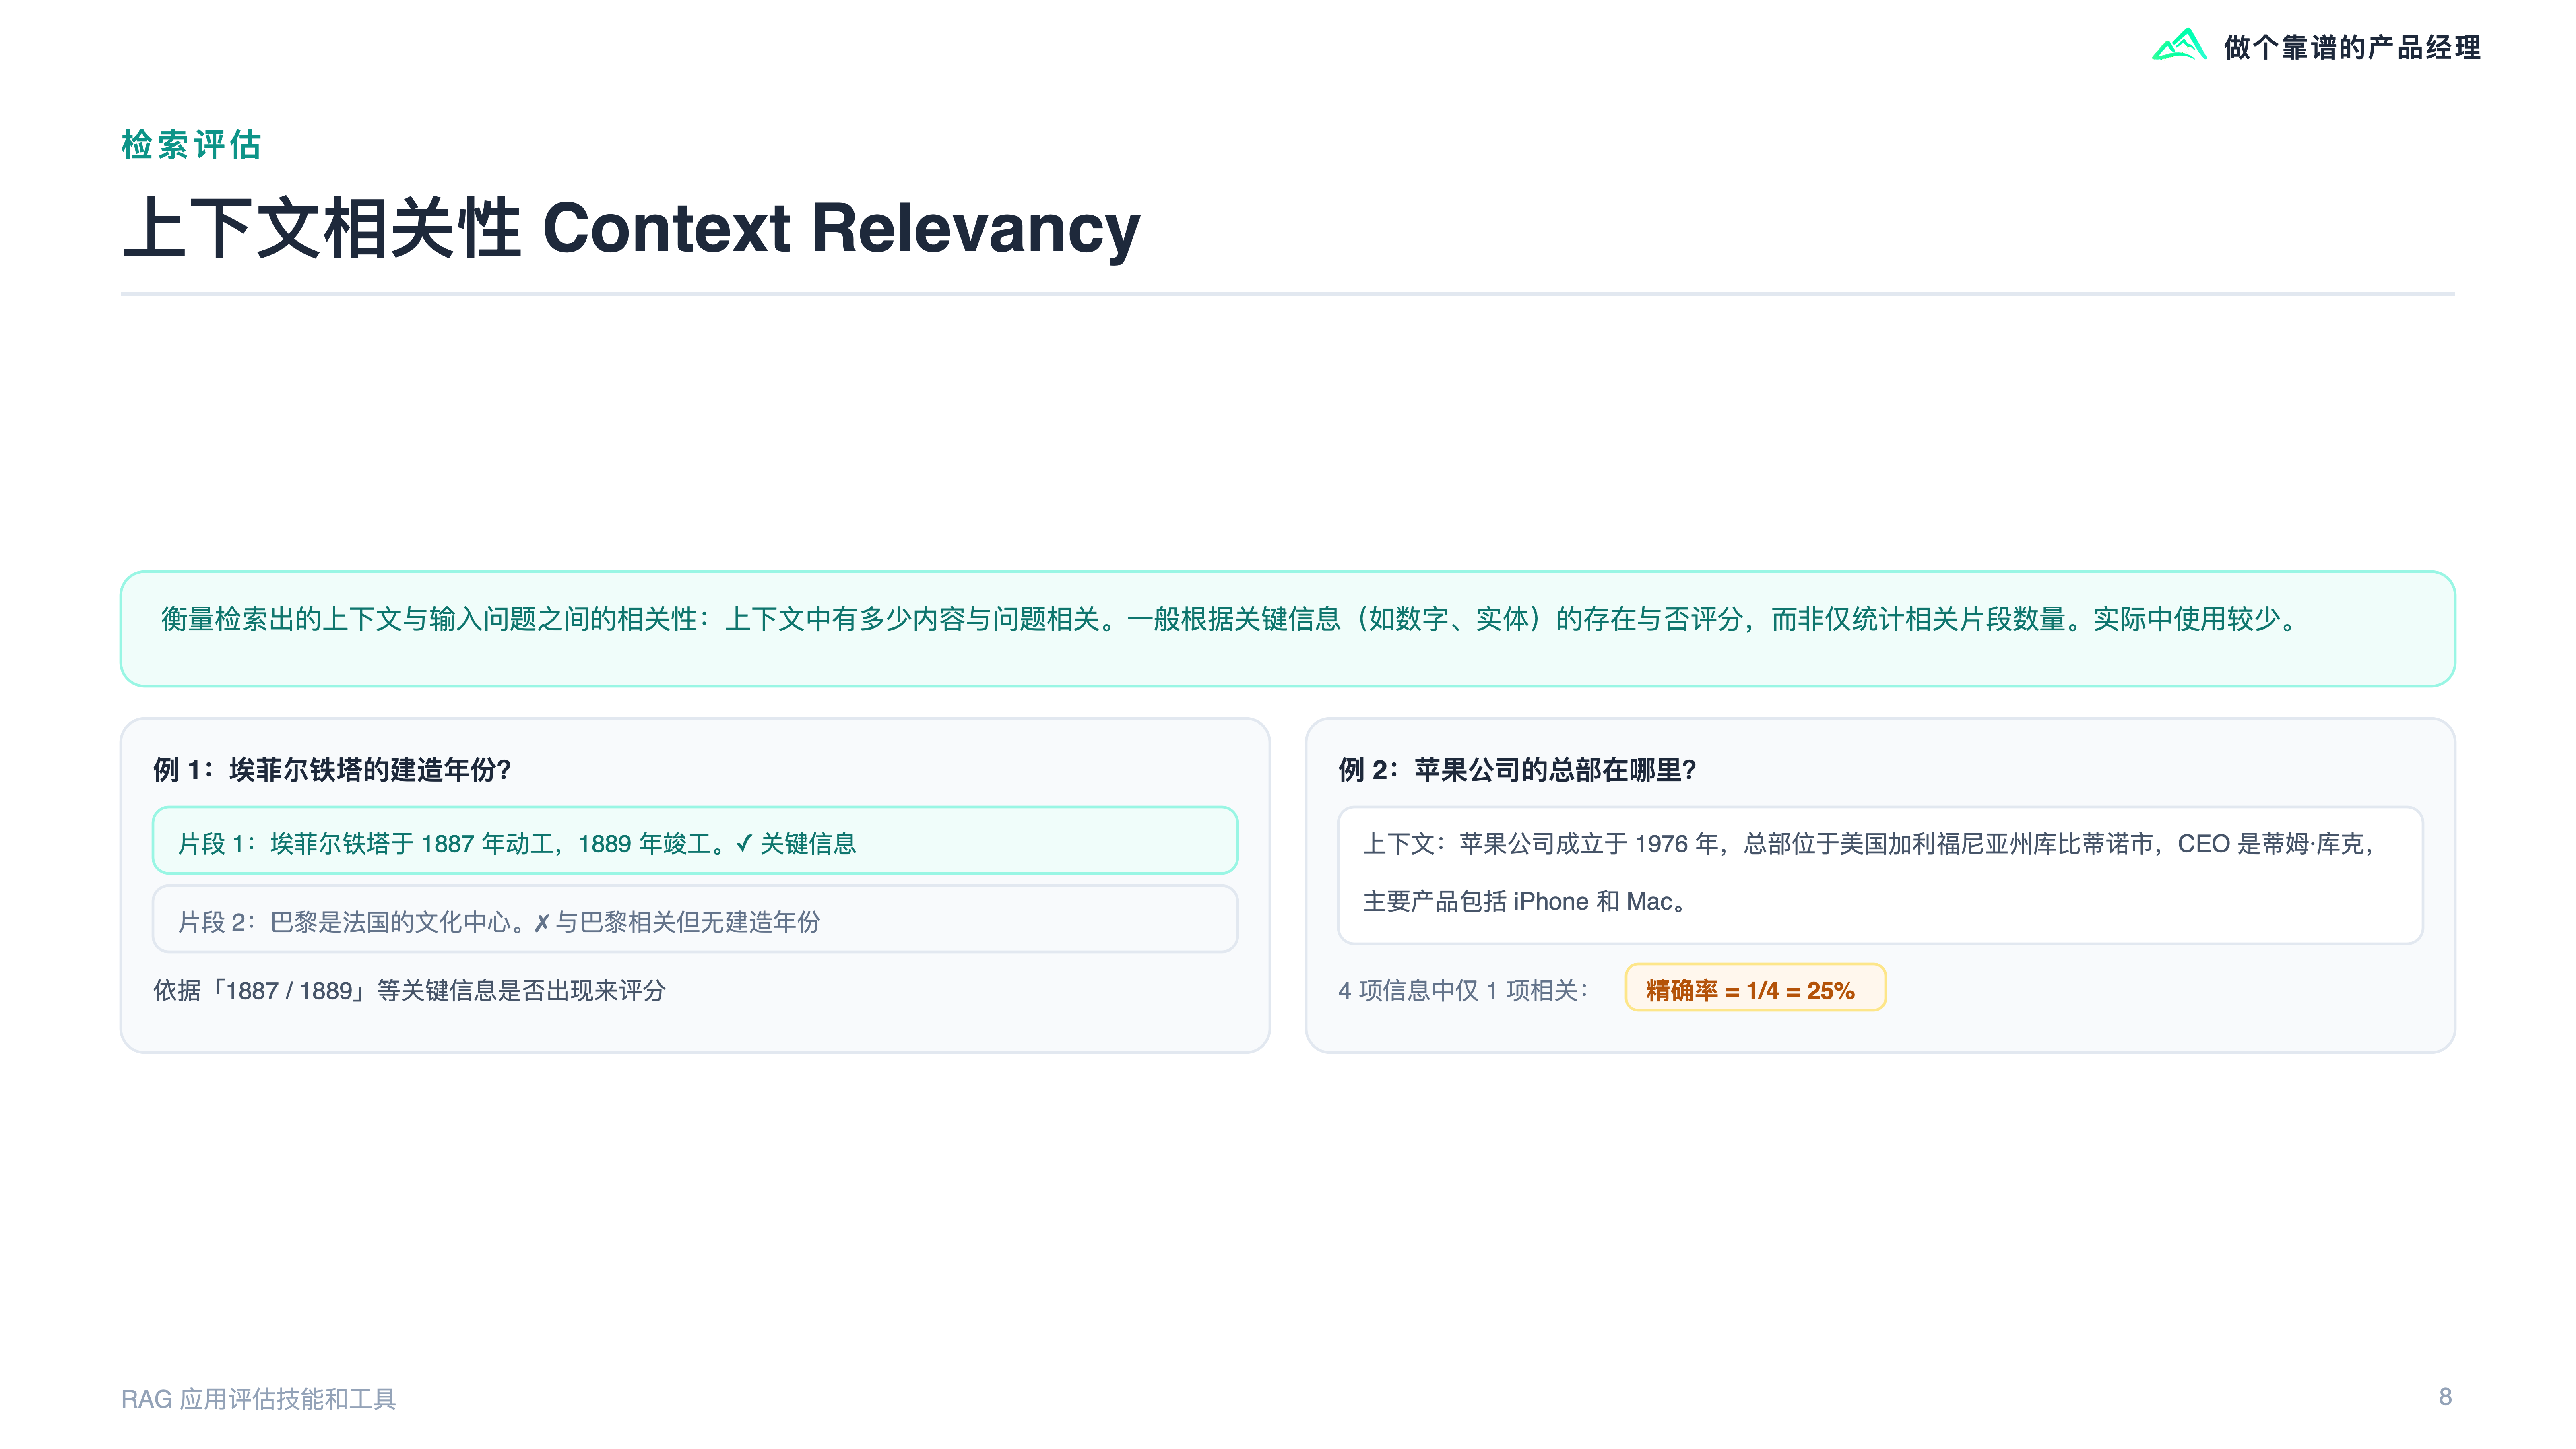
上下文相关性 Context Relevancy
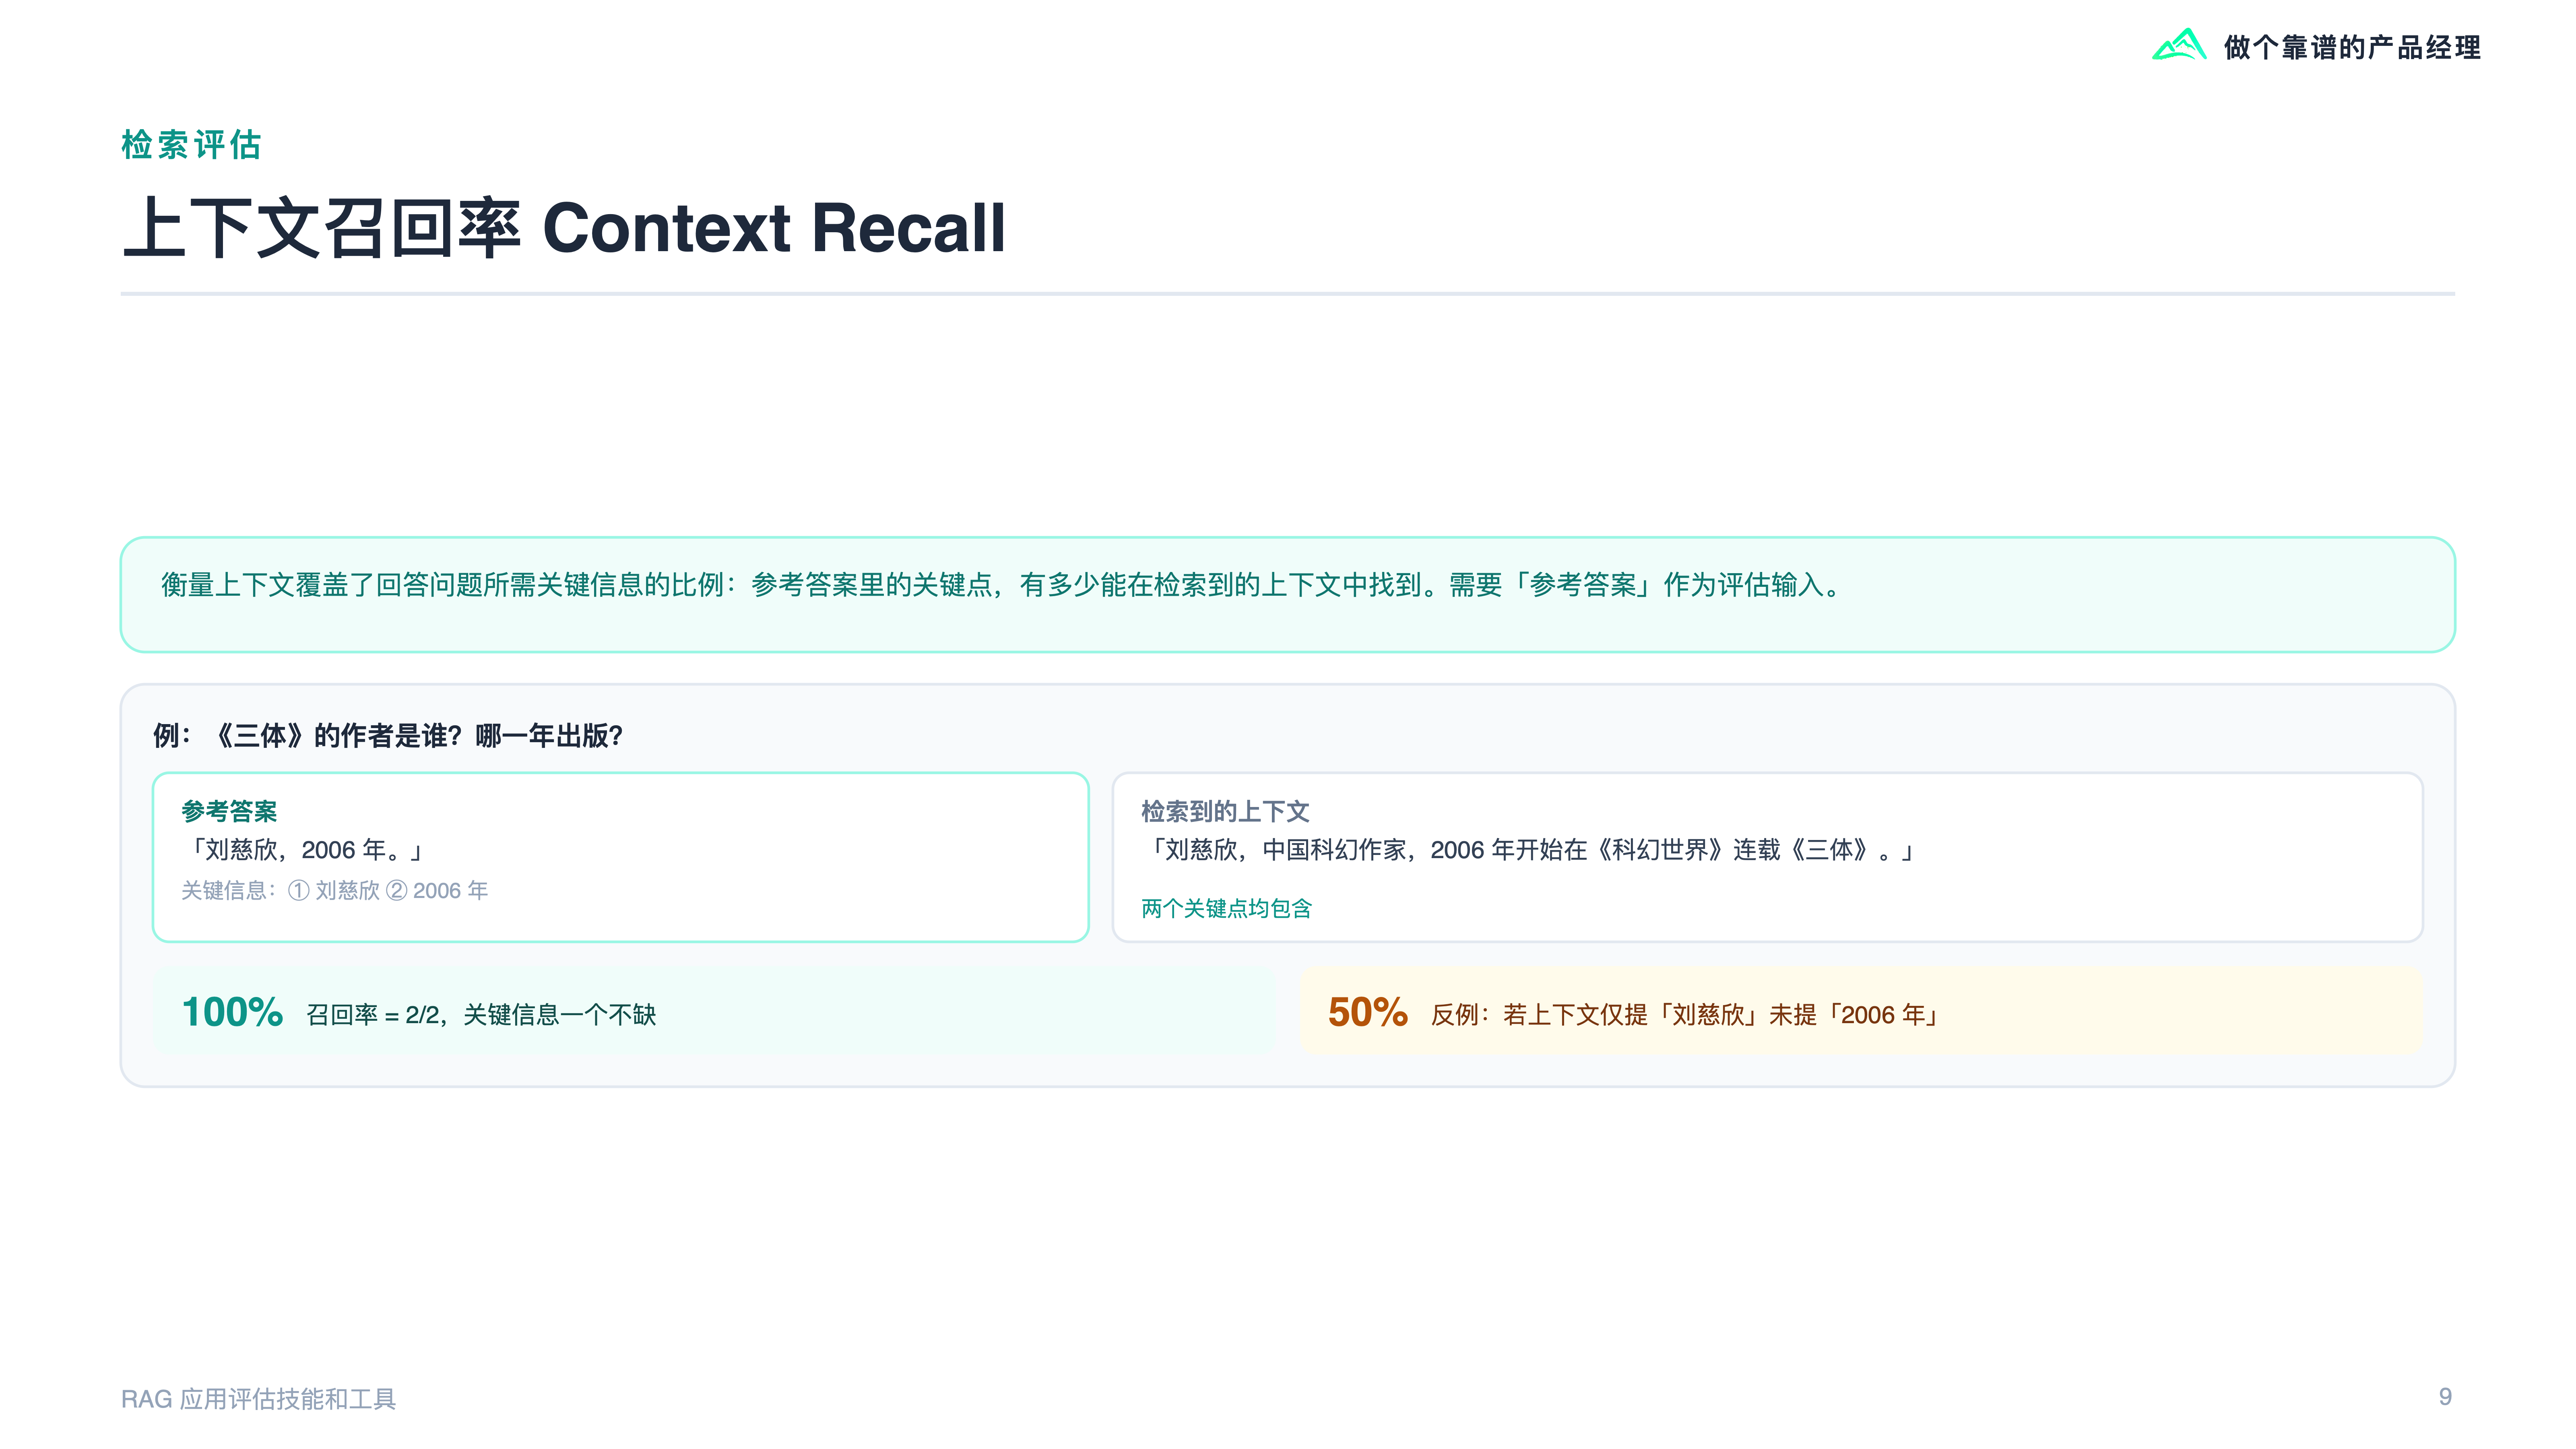
上下文召回率 Context Recall
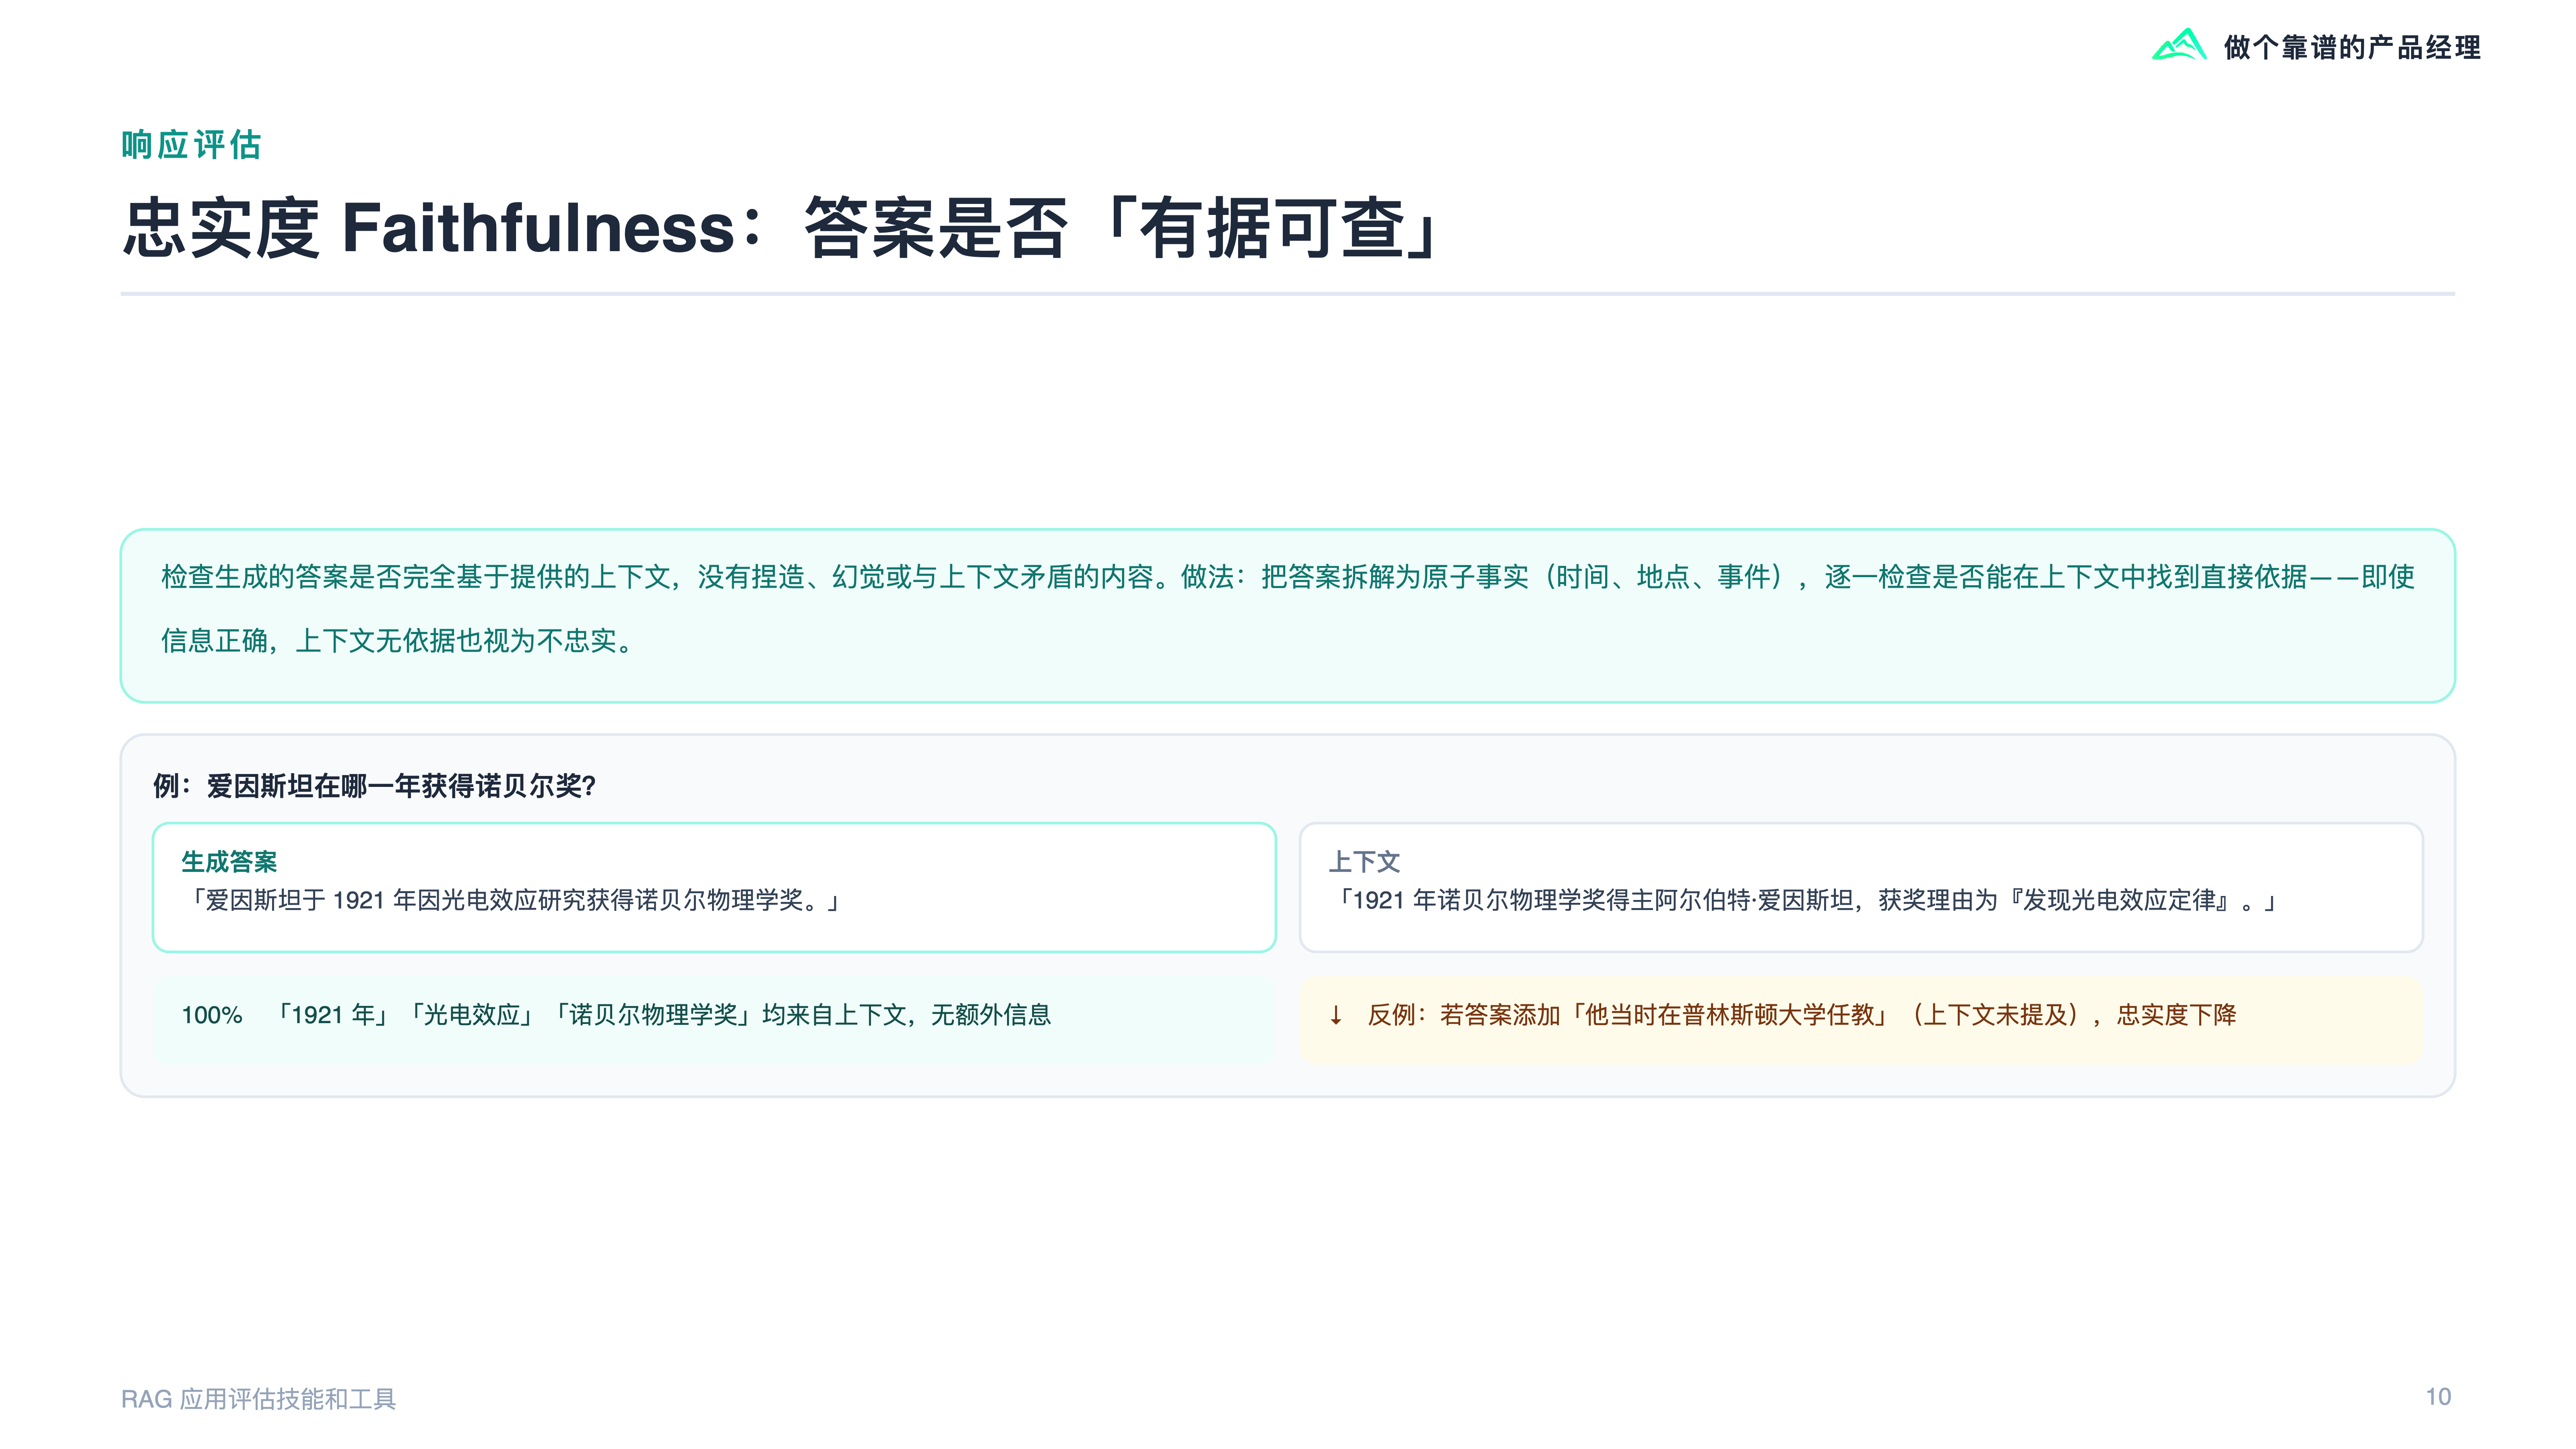
忠实度 Faithfulness:答案是否「有据可查」
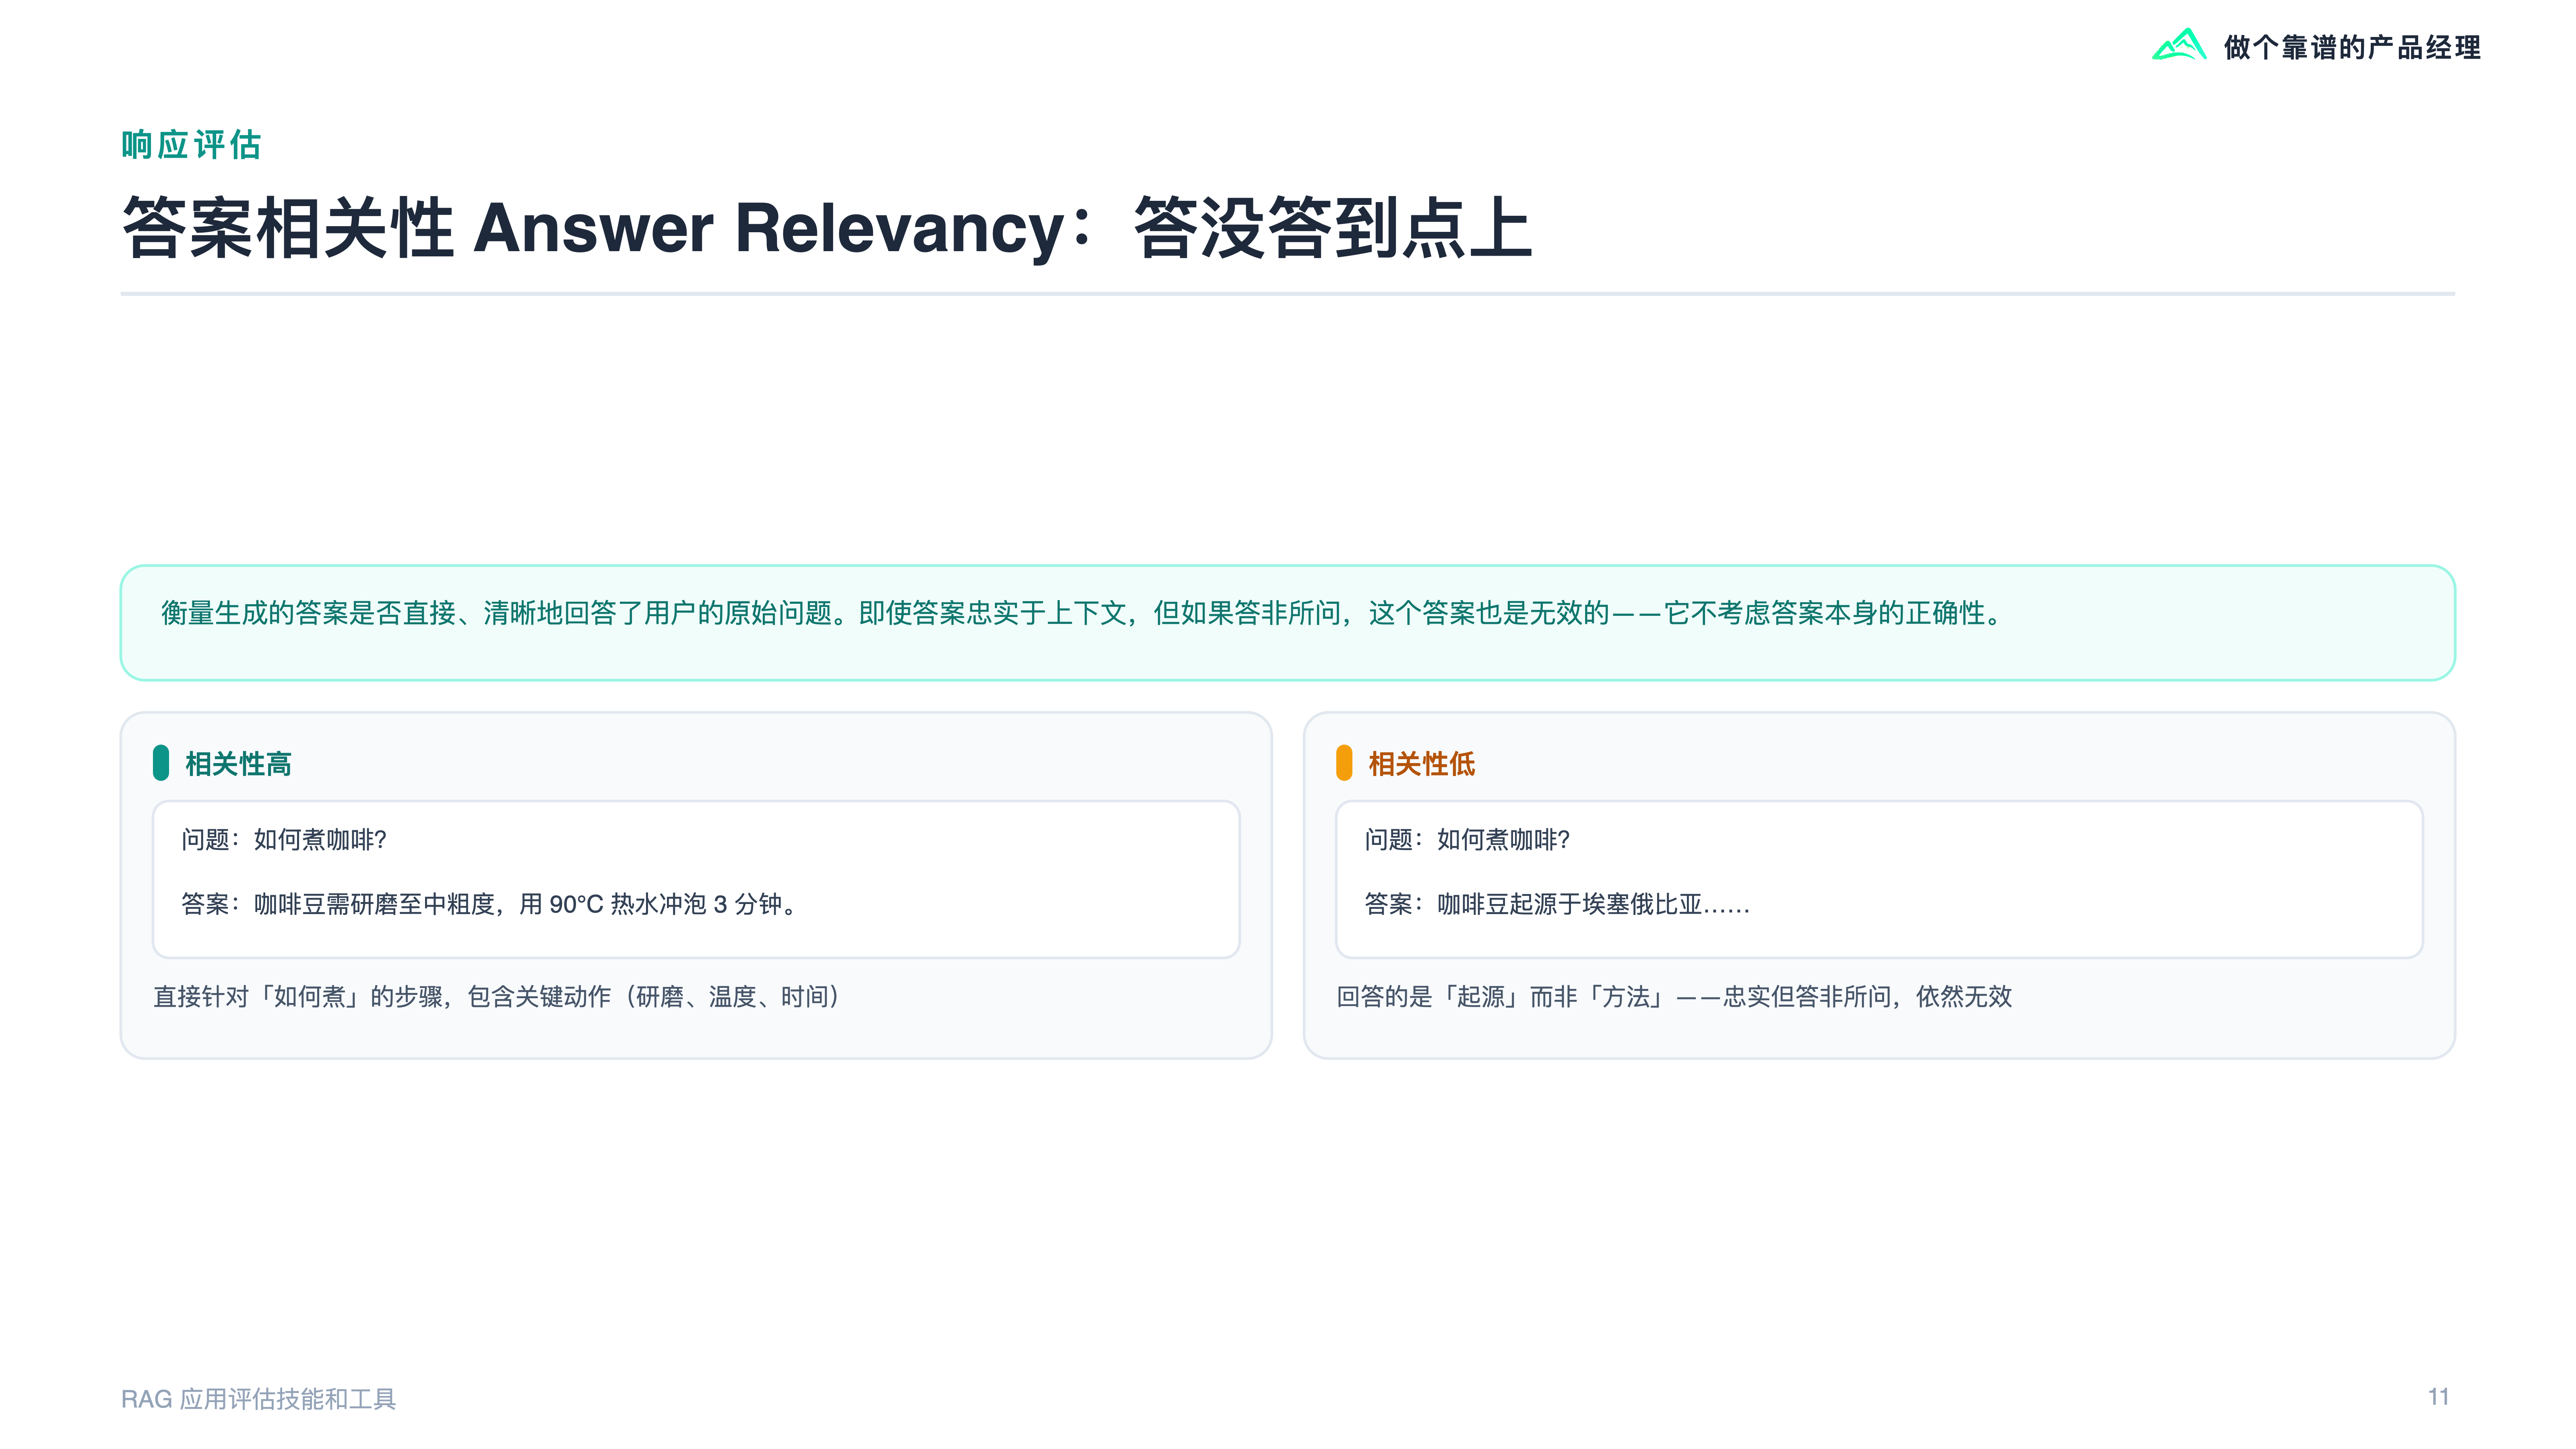
答案相关性 Answer Relevancy:答没答到点上
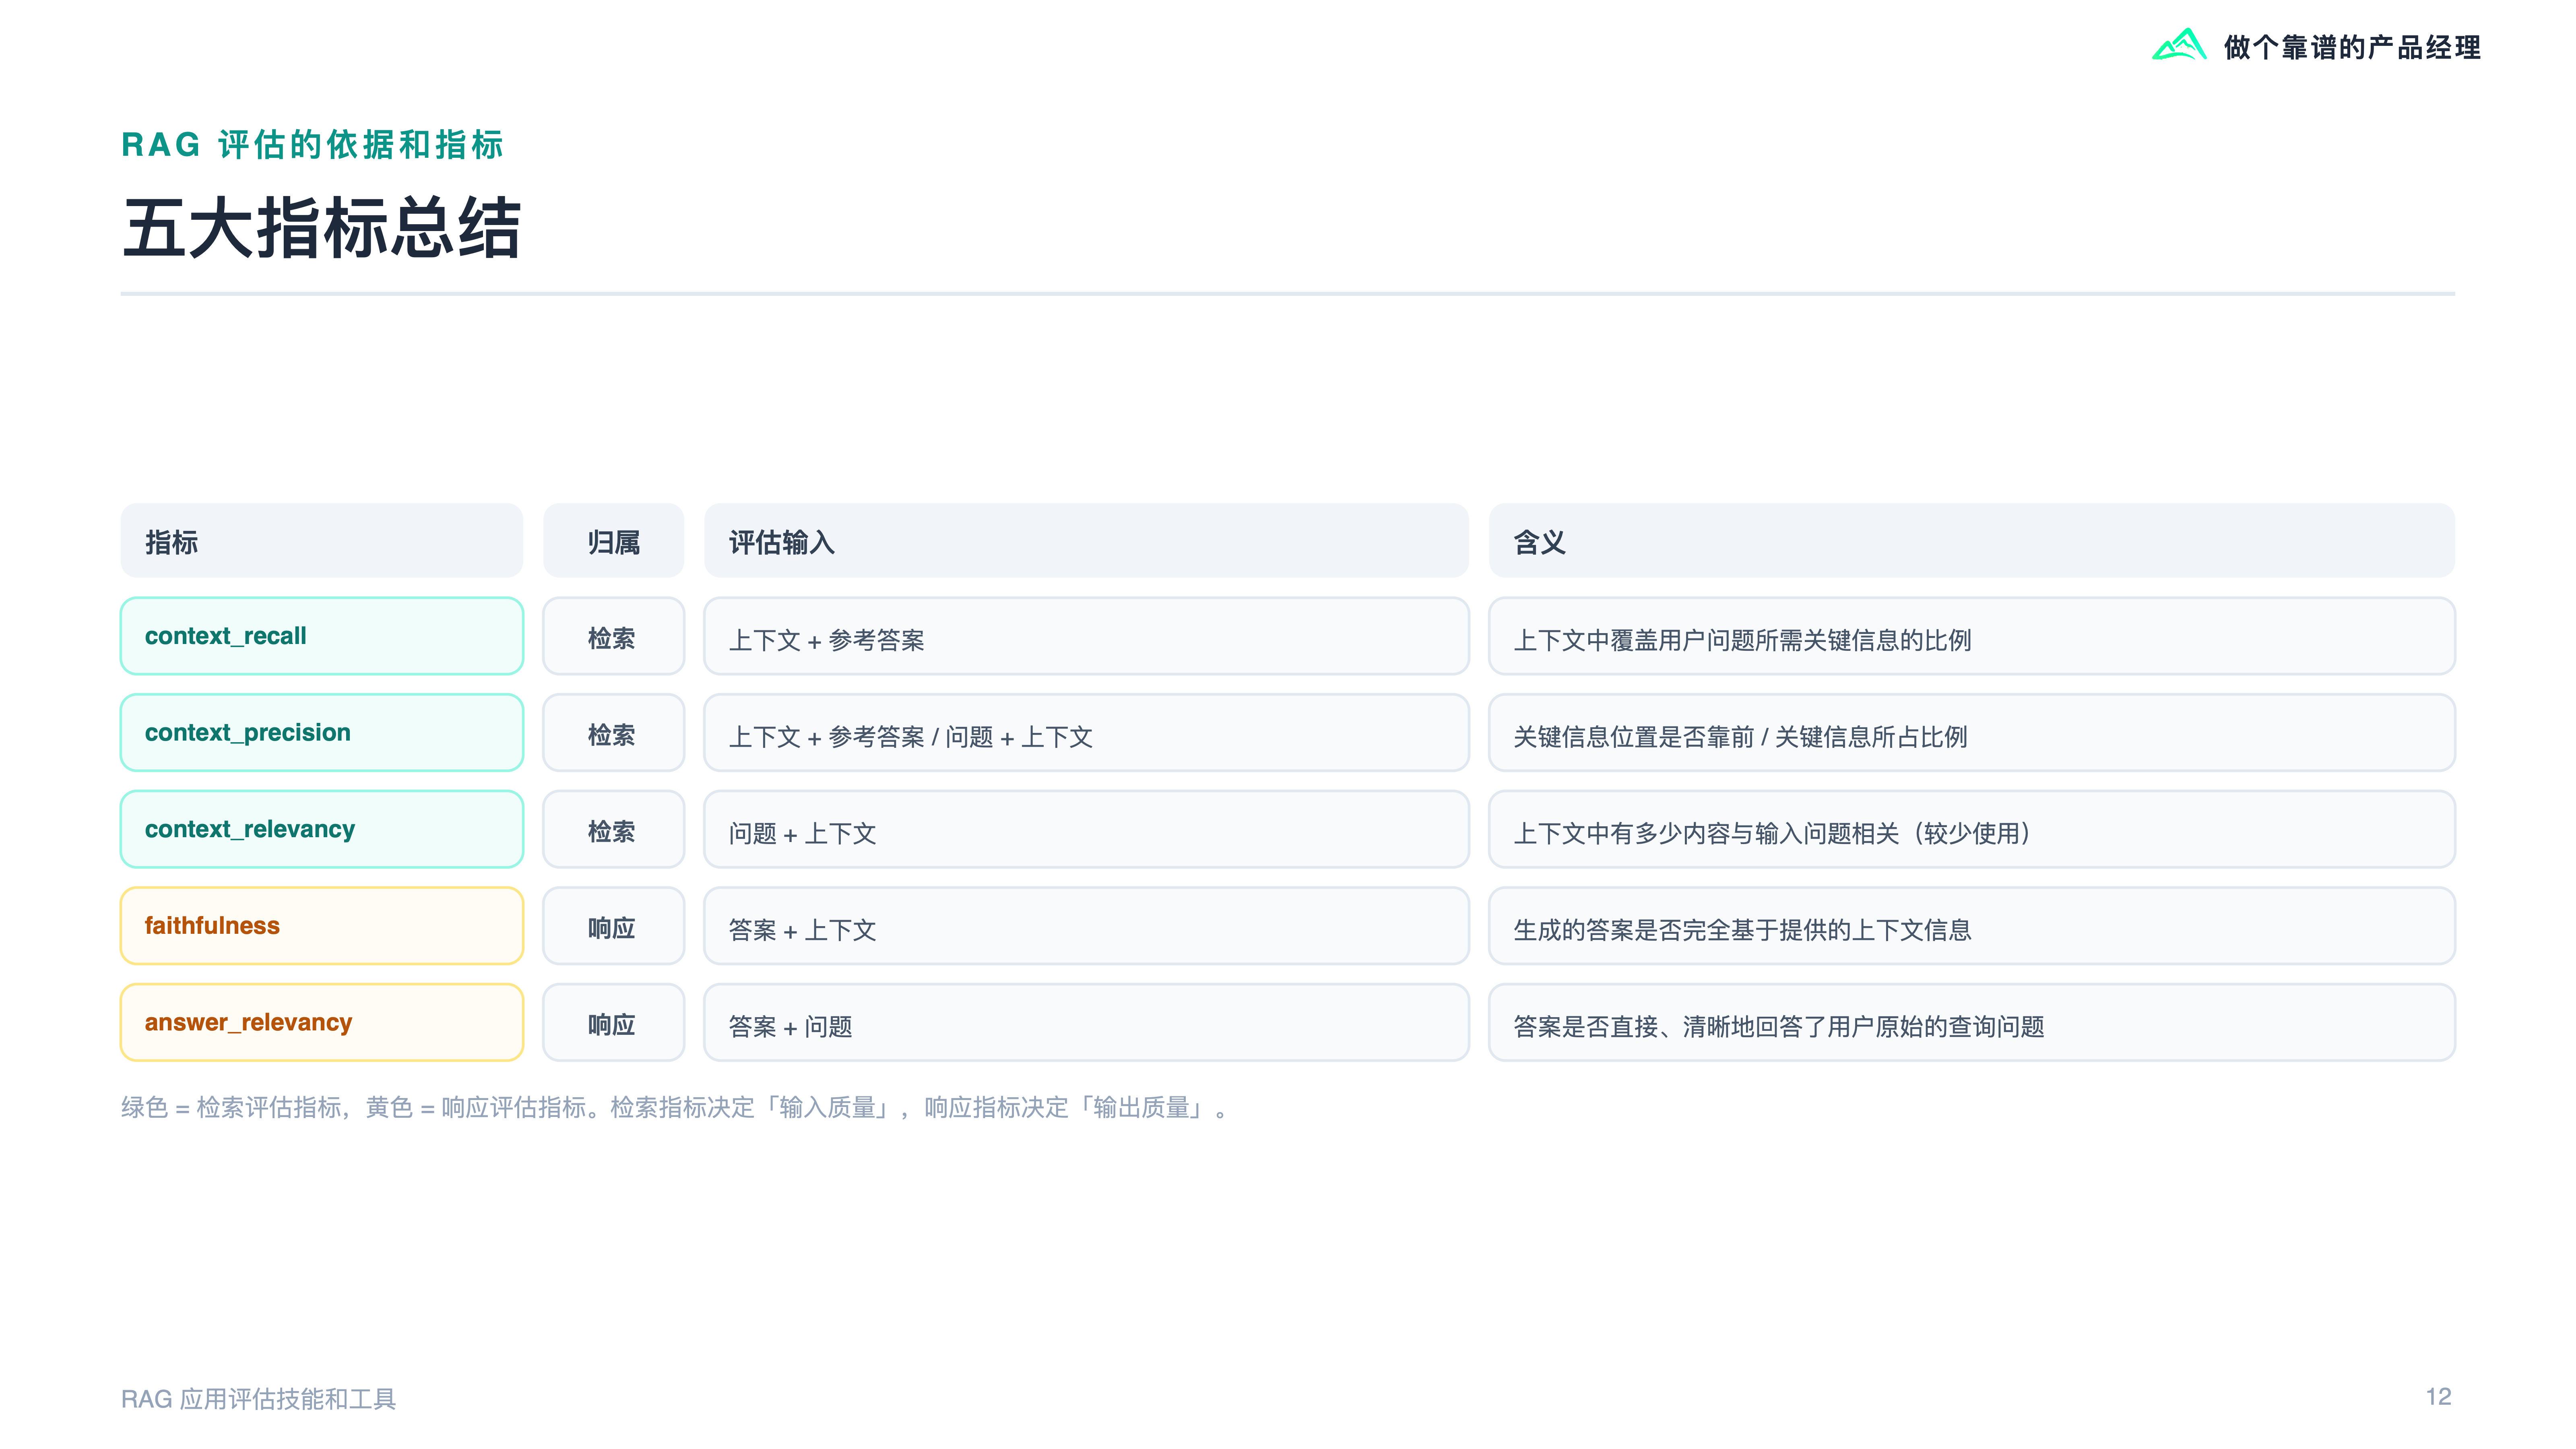
五大指标总结
2
常用的 RAG 评估工具
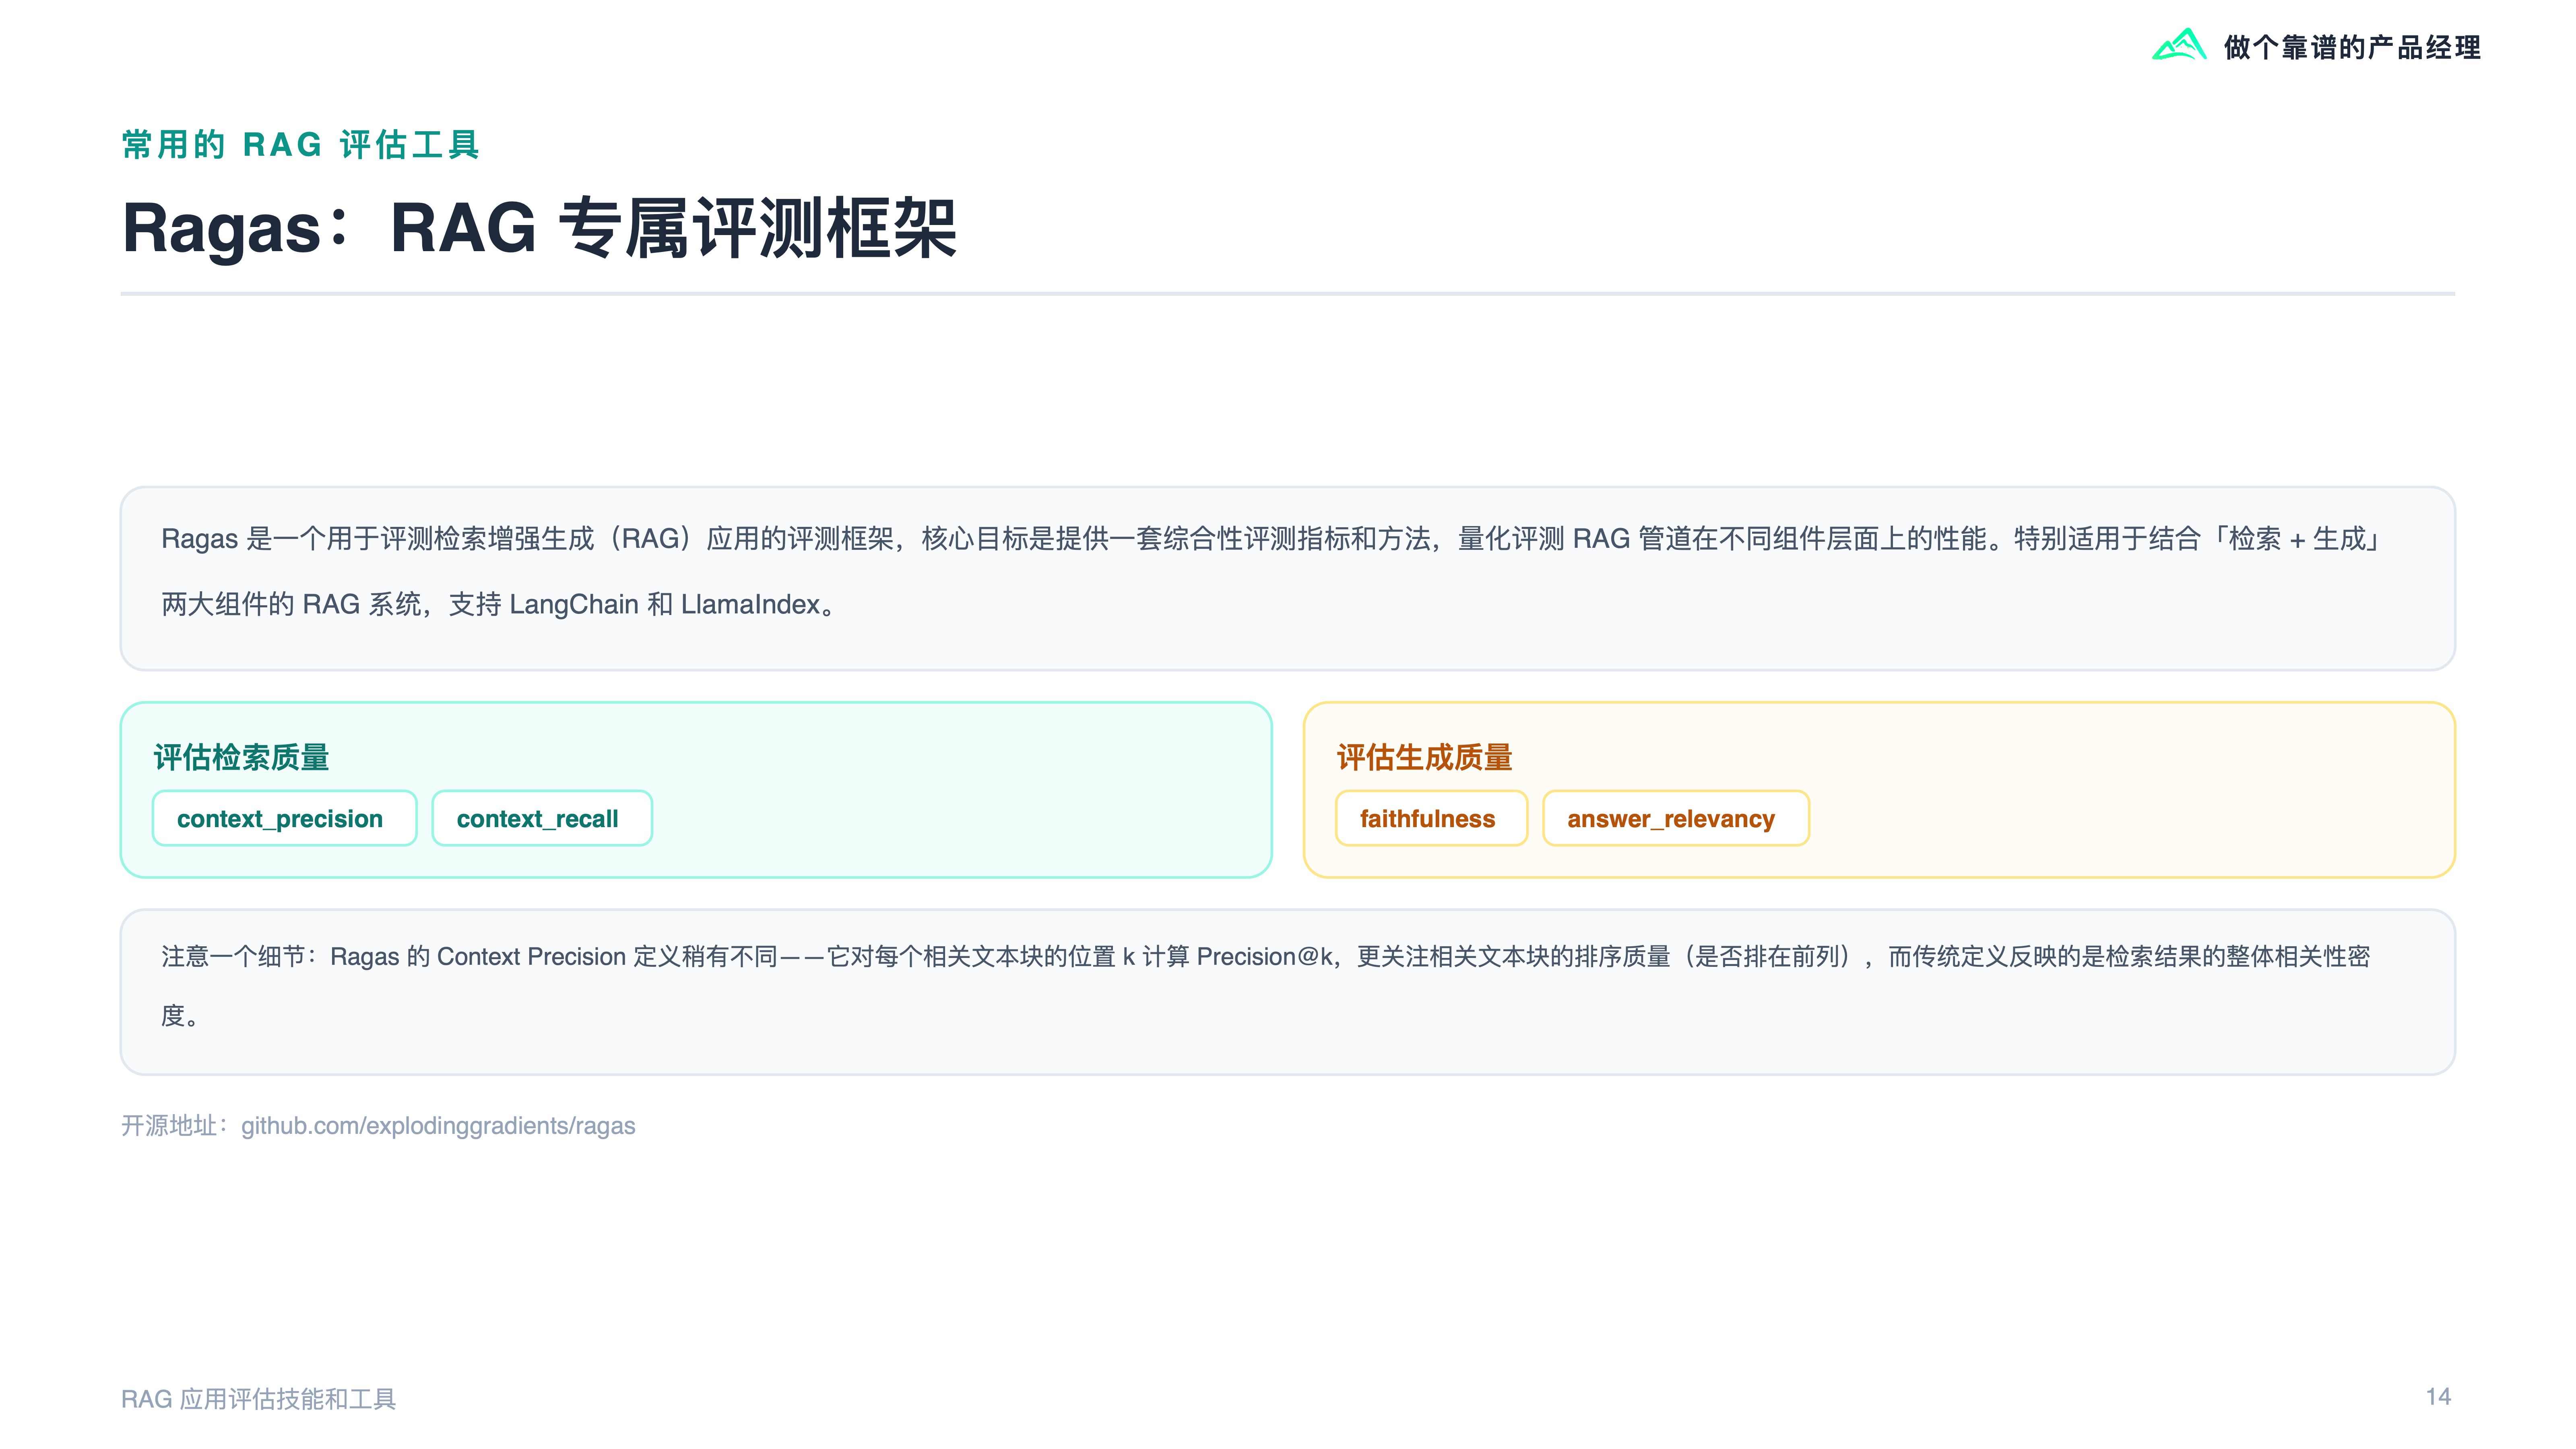
Ragas:RAG 专属评测框架
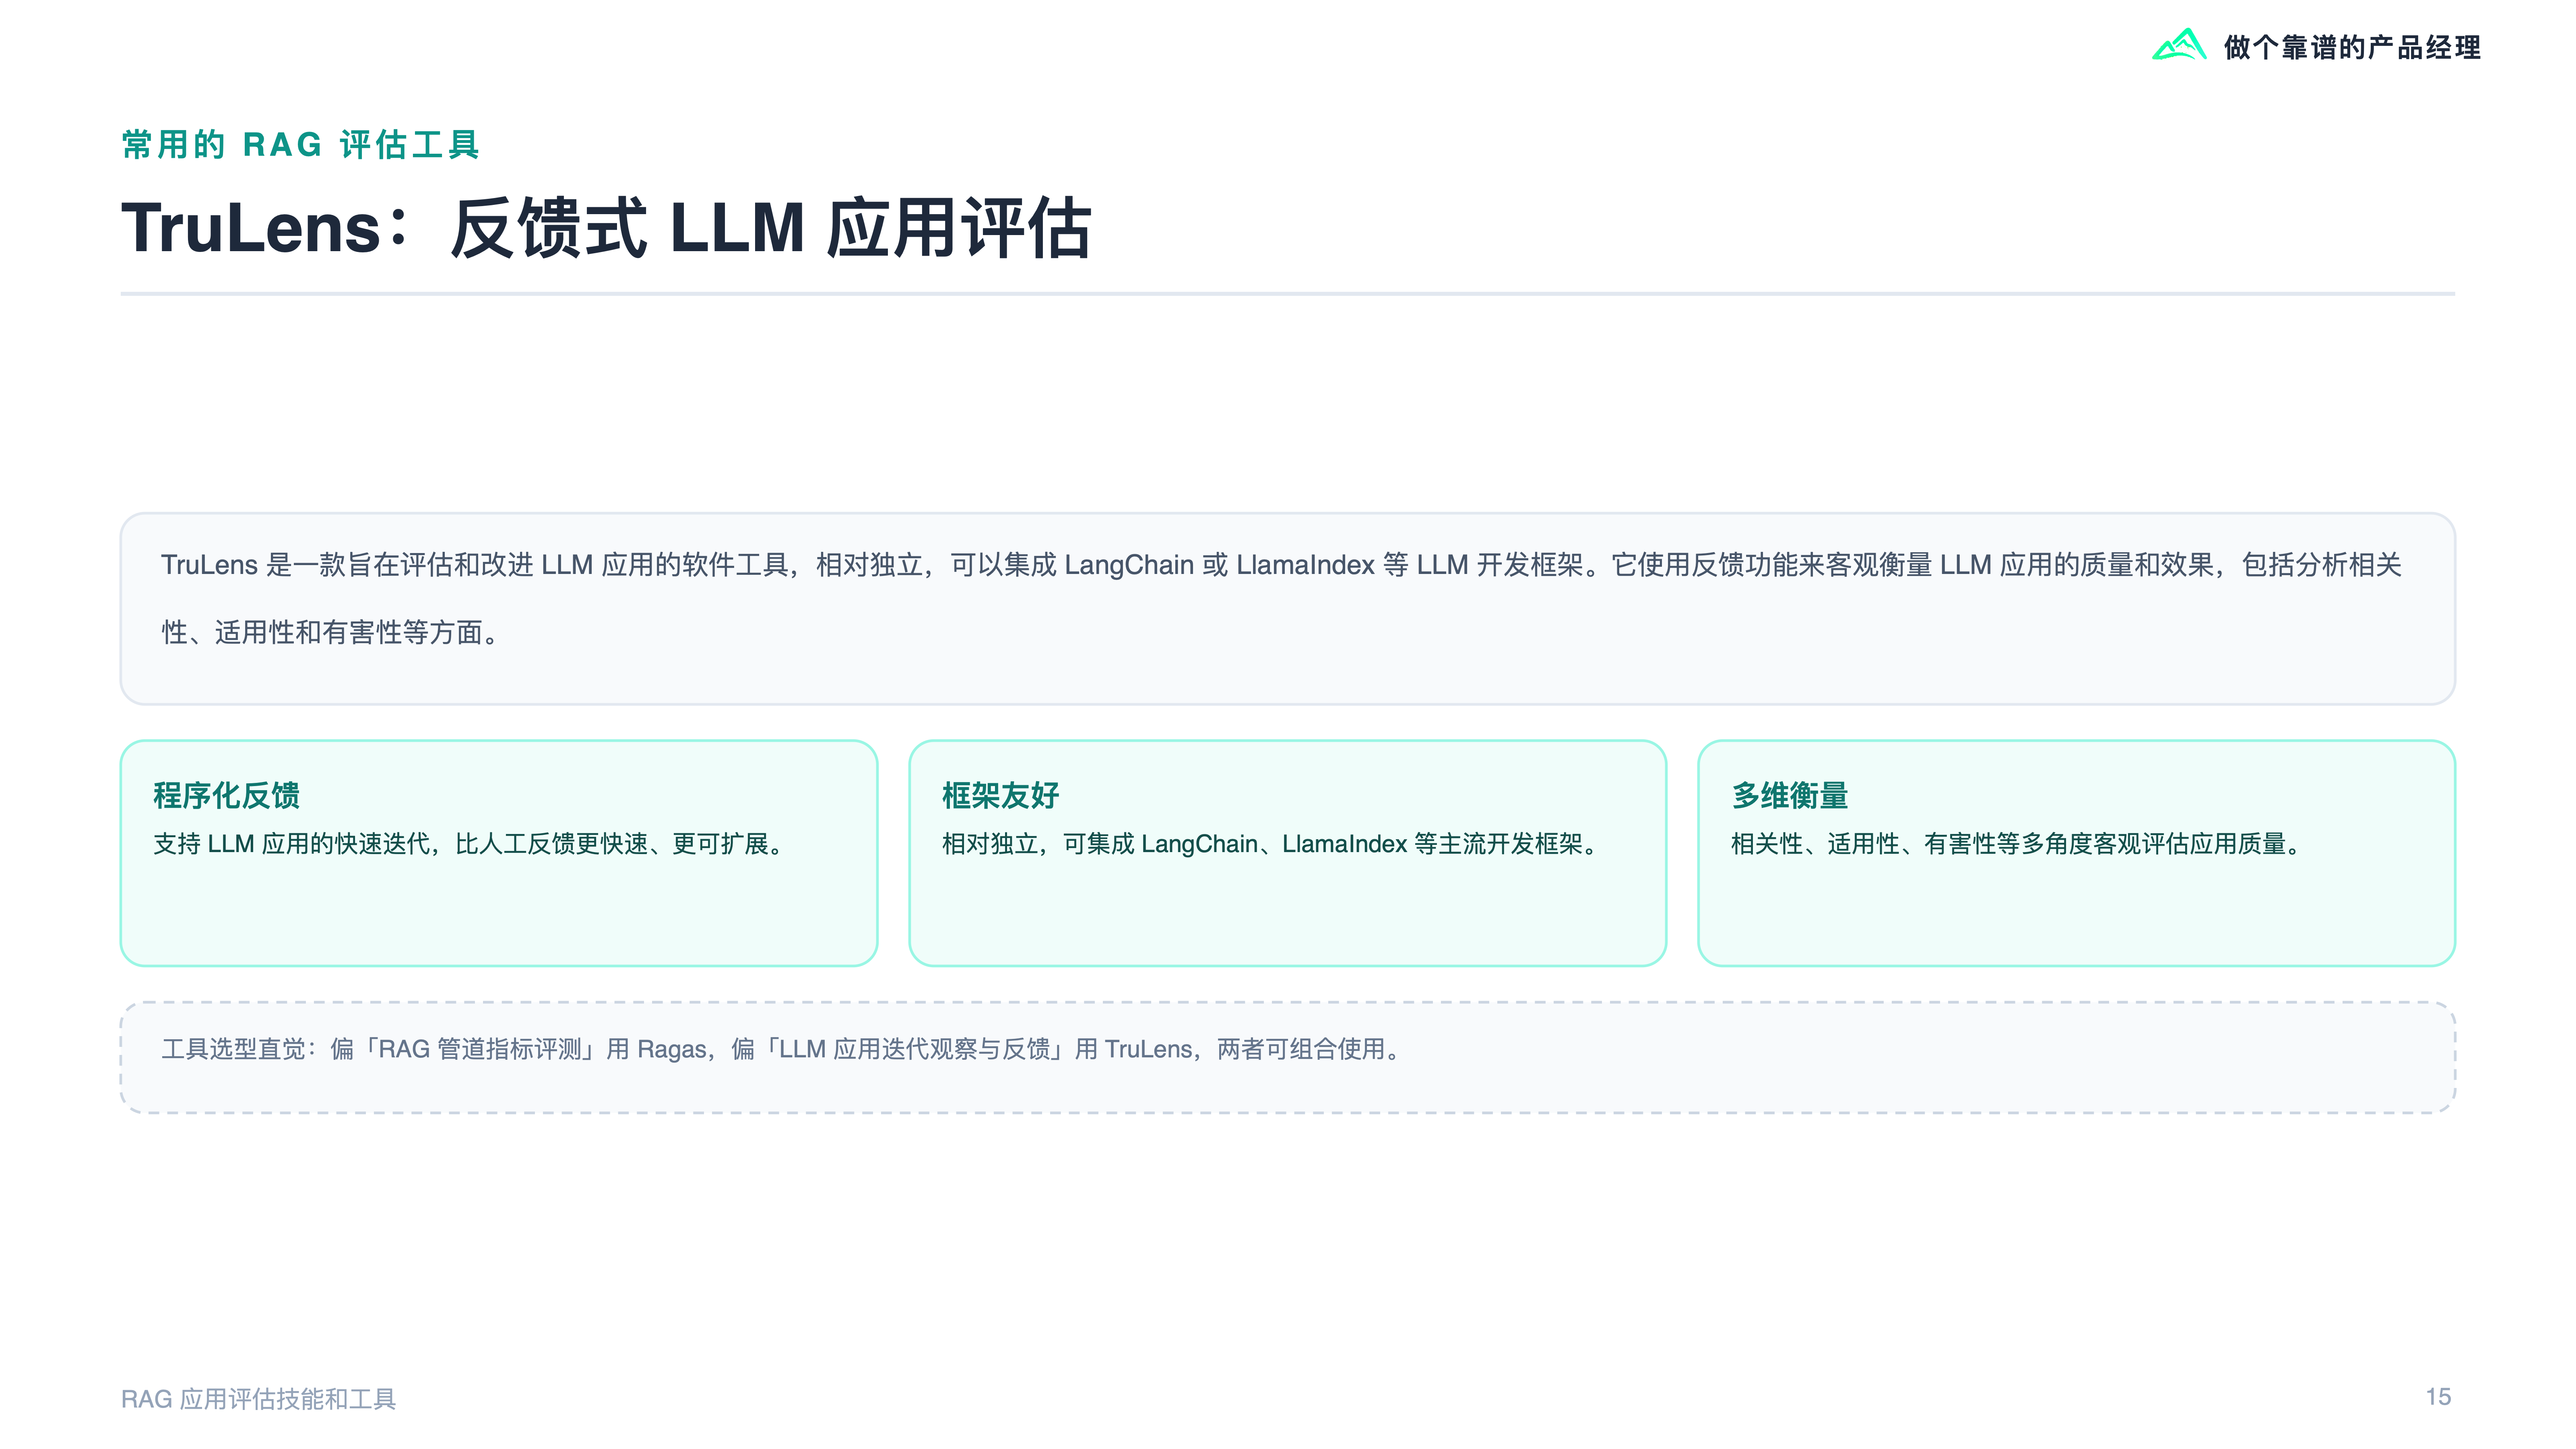
TruLens:反馈式 LLM 应用评估
3
医疗评估:深入理解指标与优化方向
用 RAGAS 拿到四个指标,然后呢?
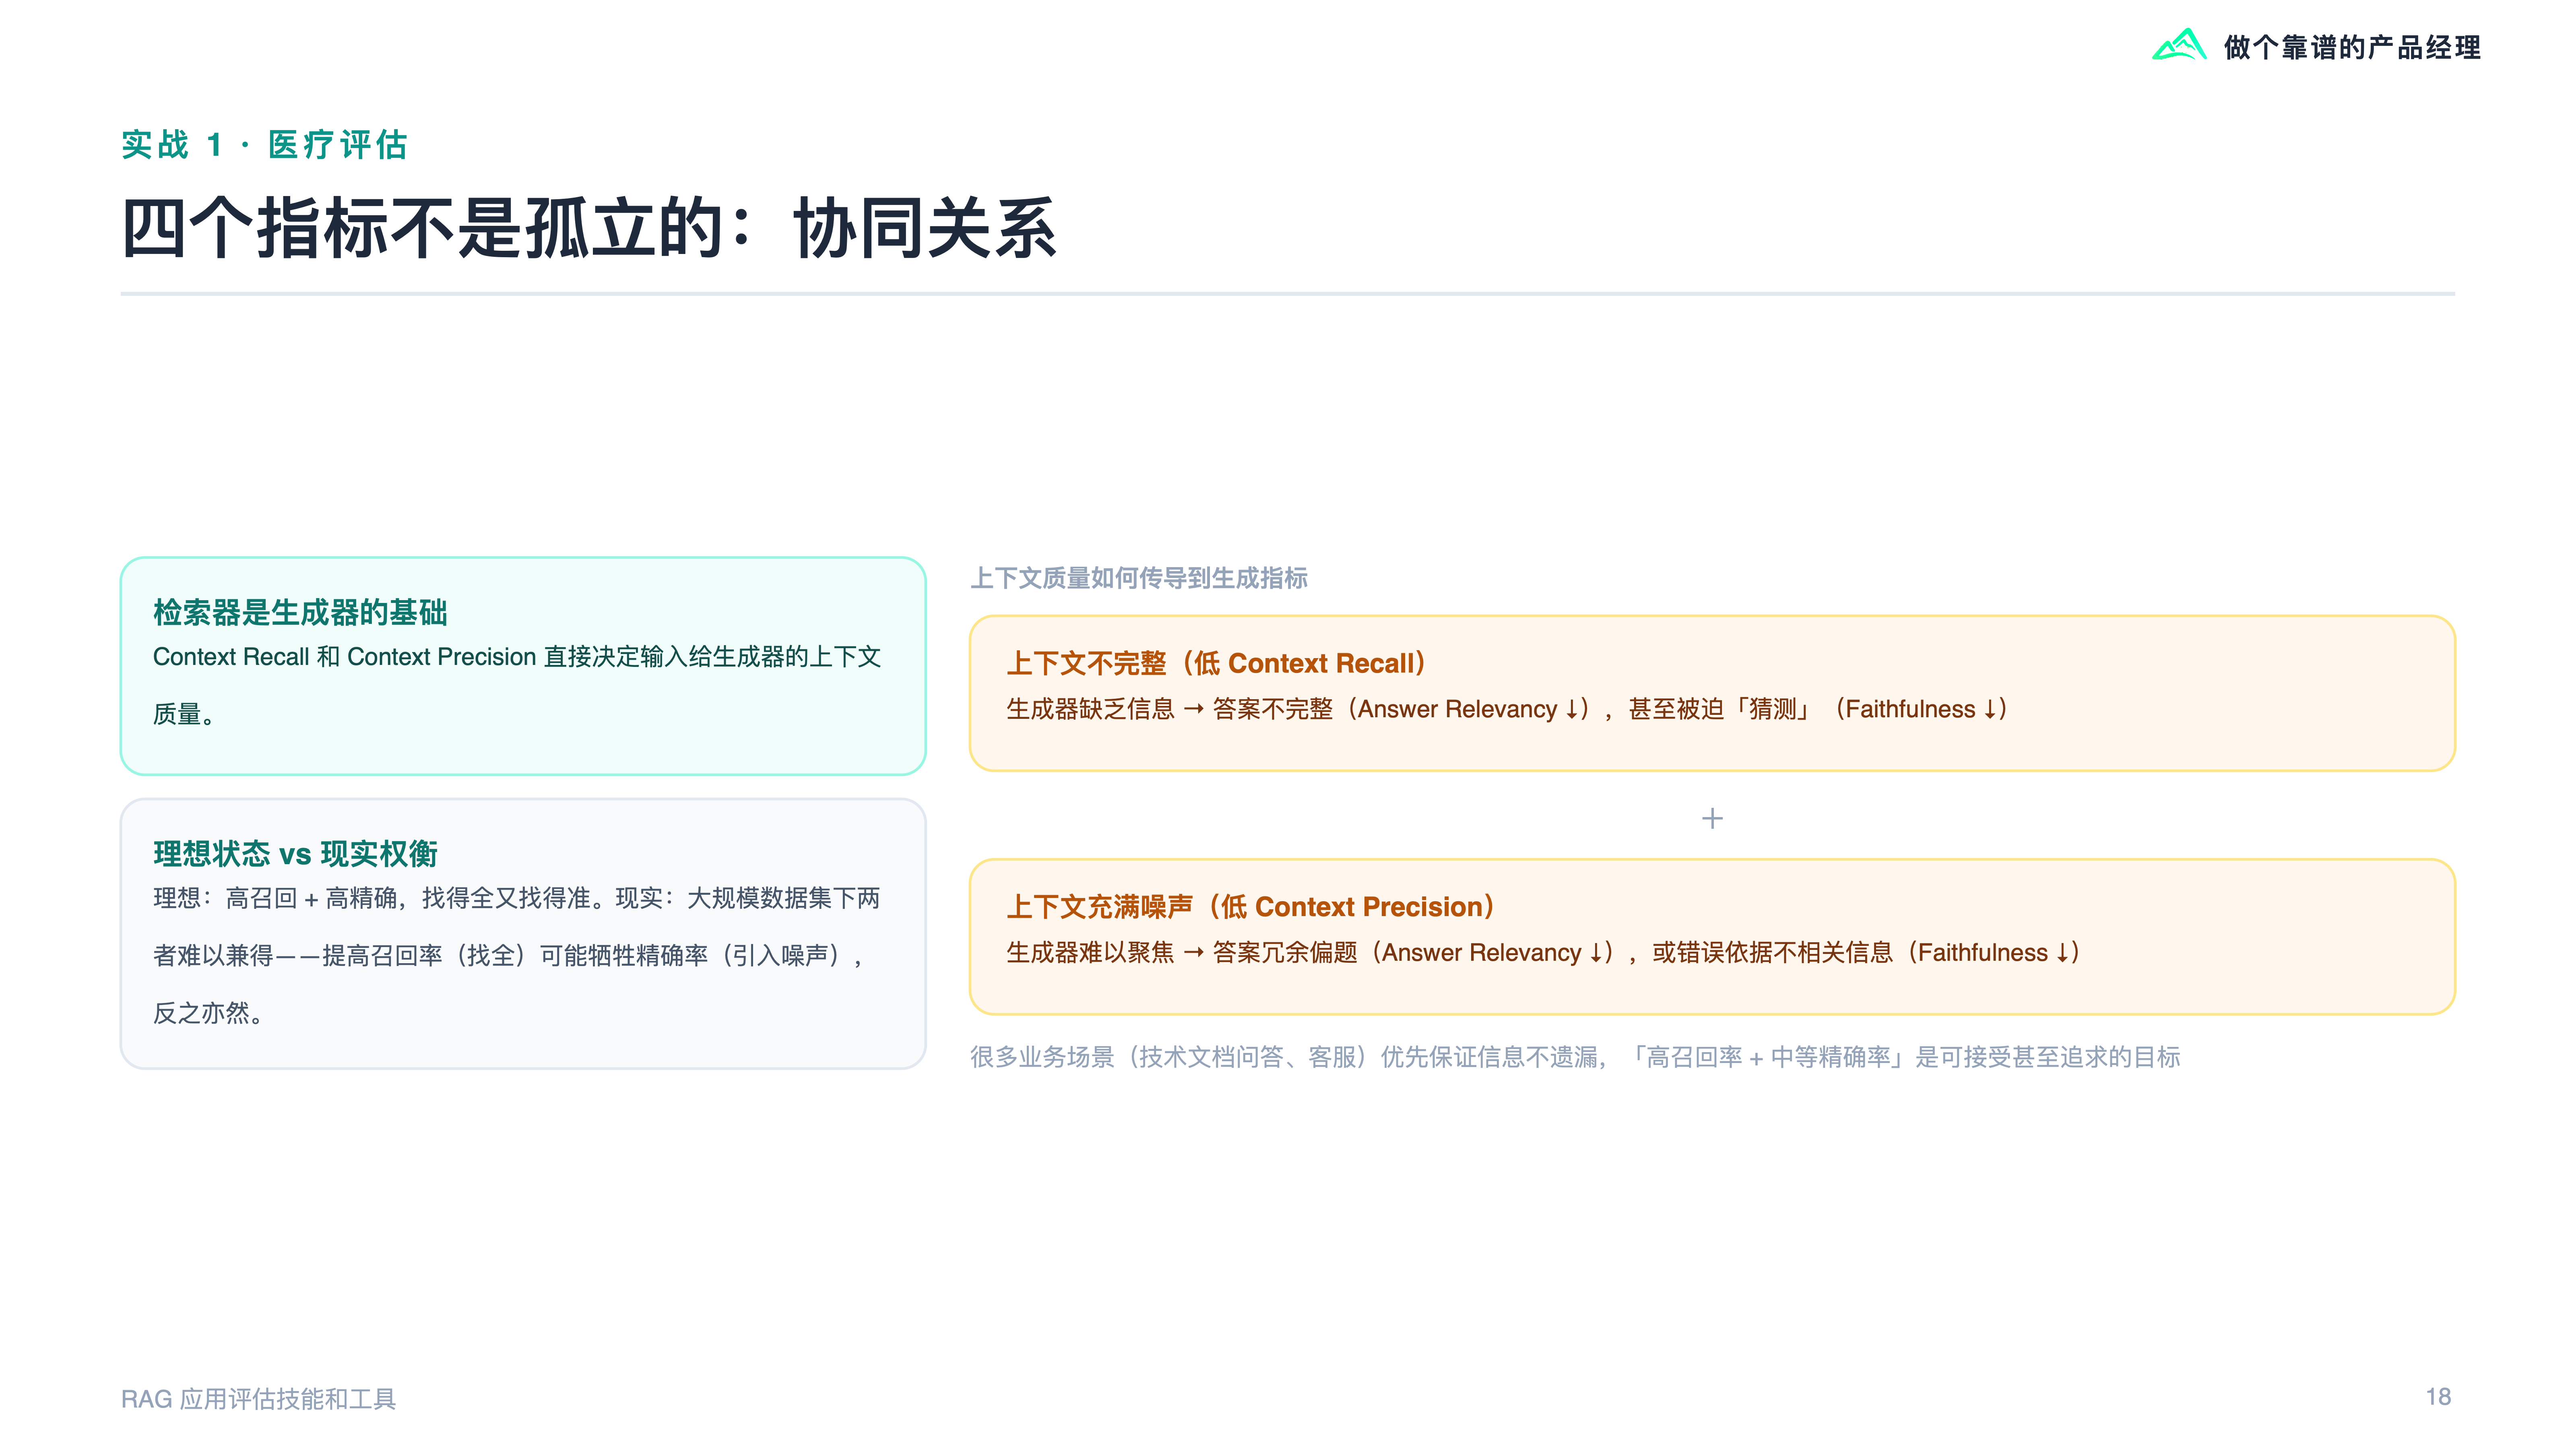
四个指标不是孤立的:协同关系
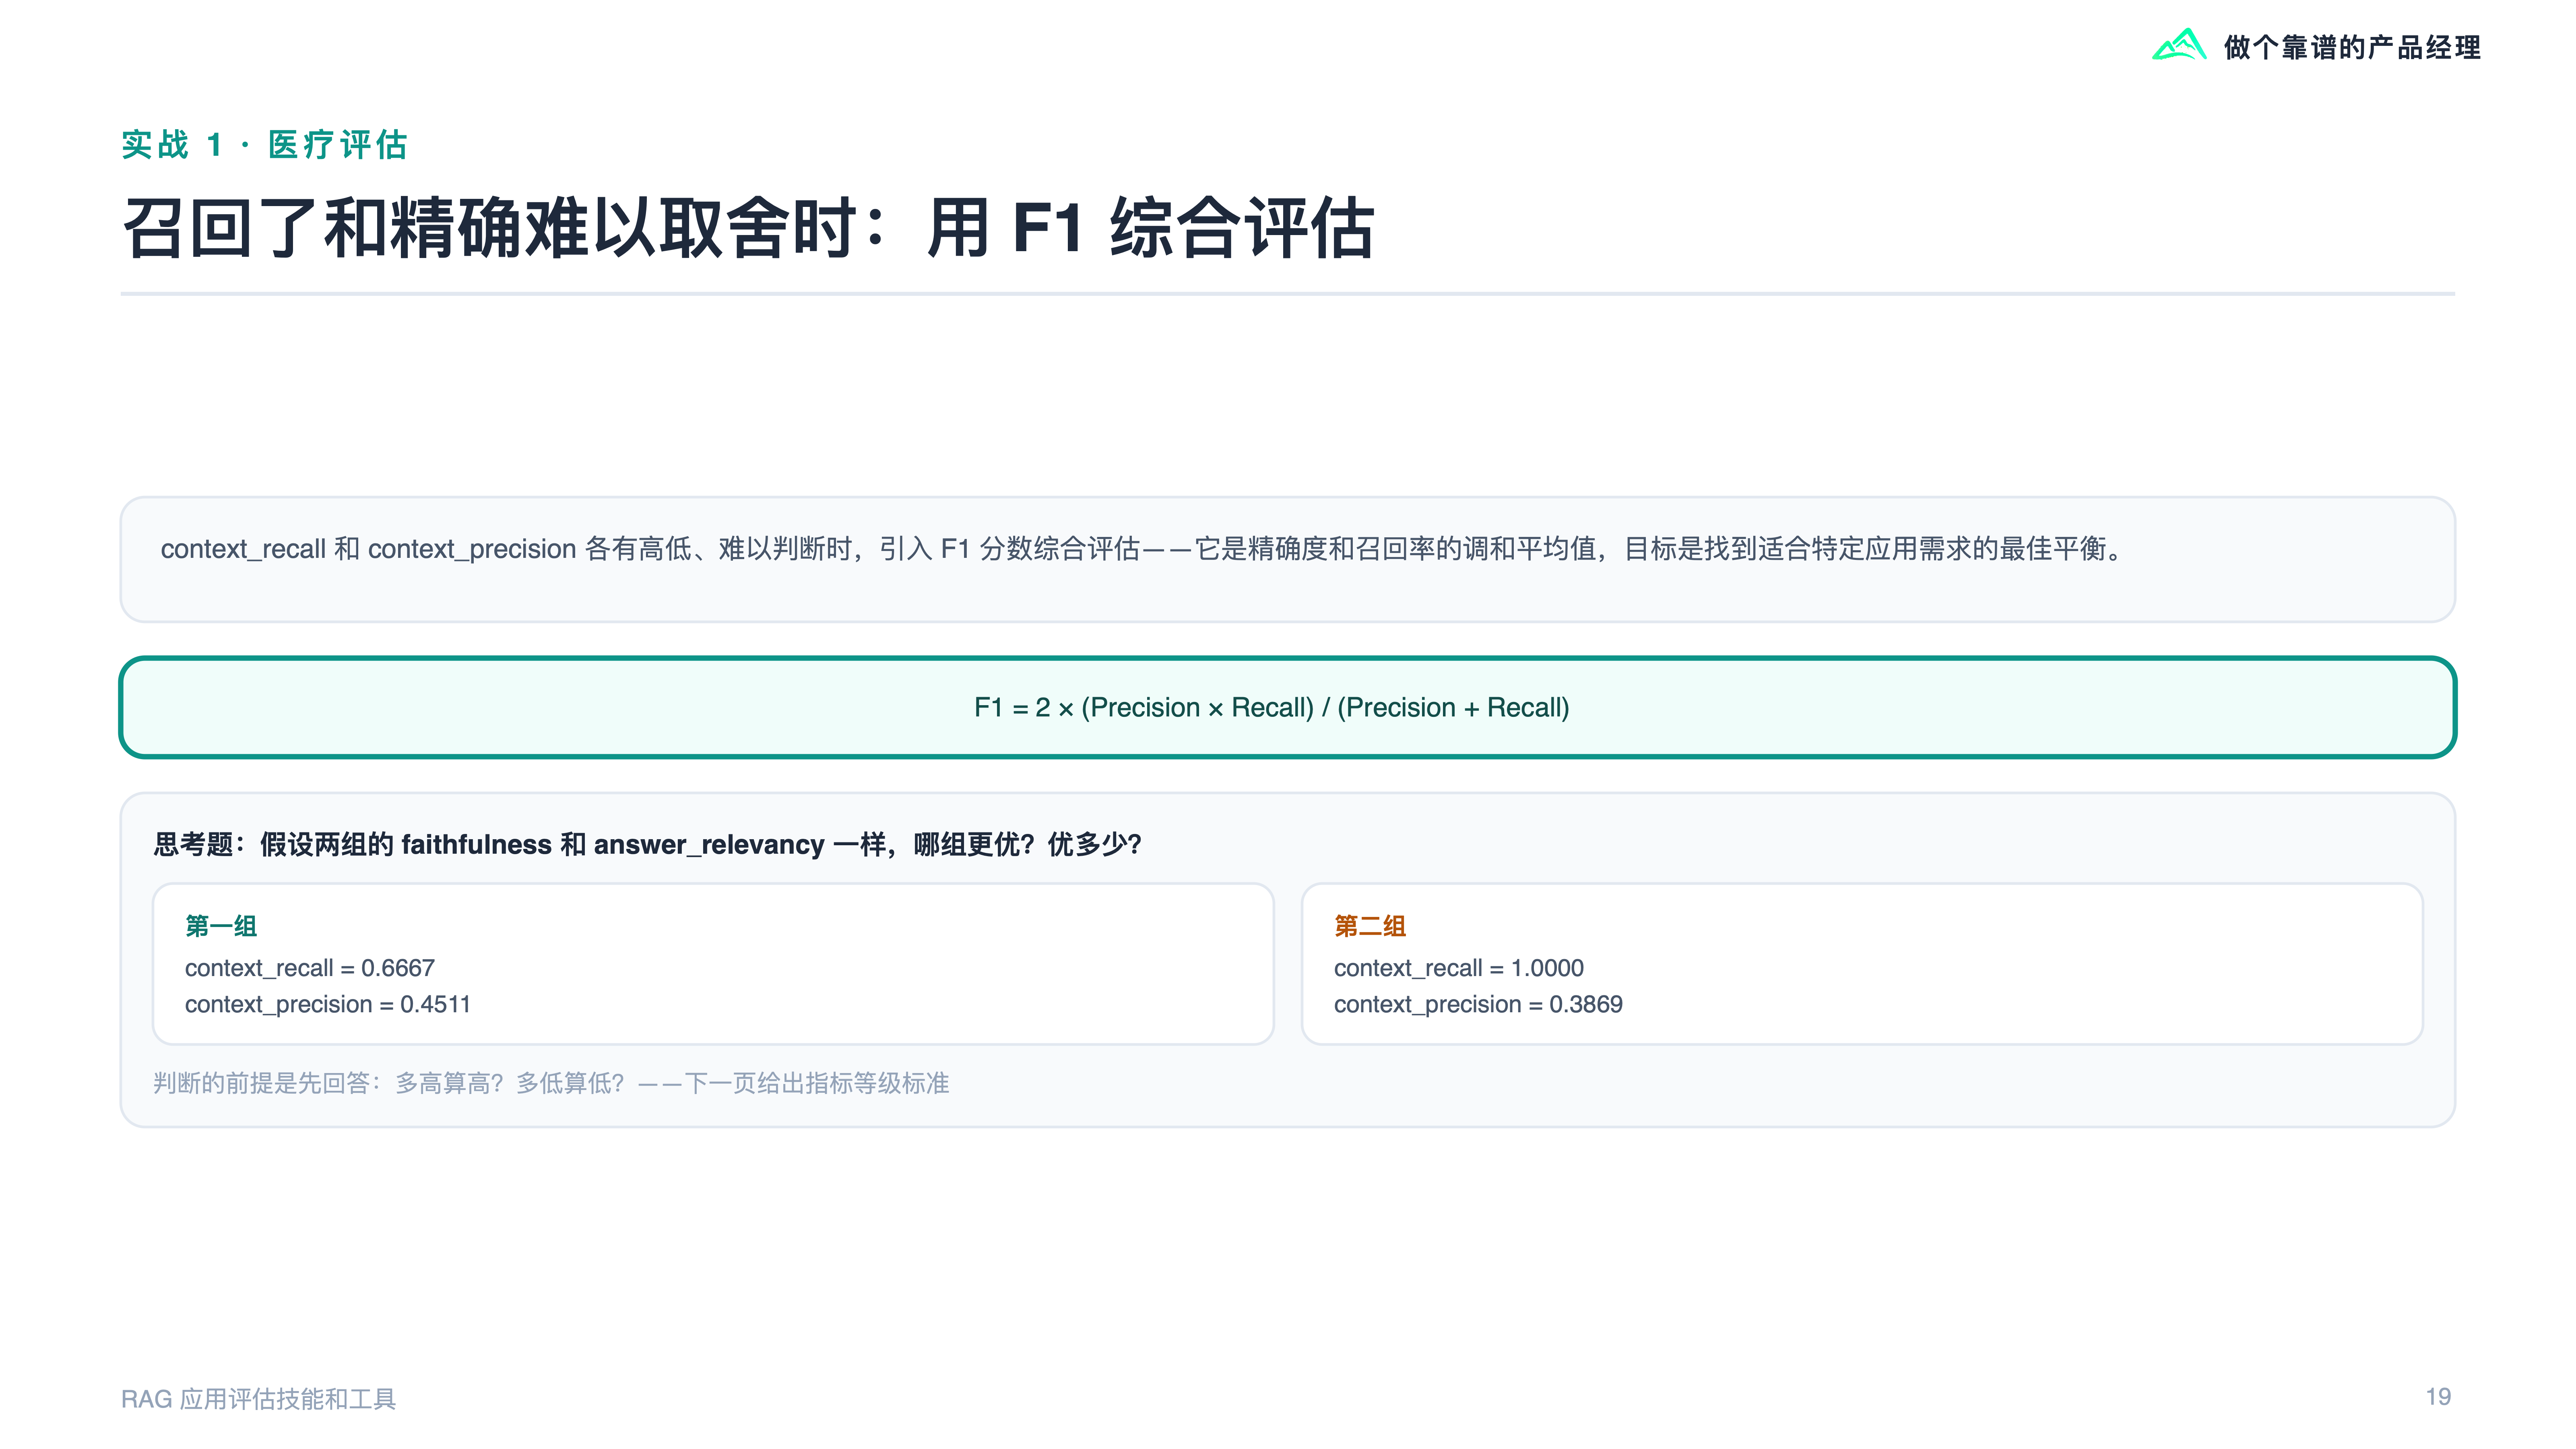
召回了和精确难以取舍时:用 F1 综合评估
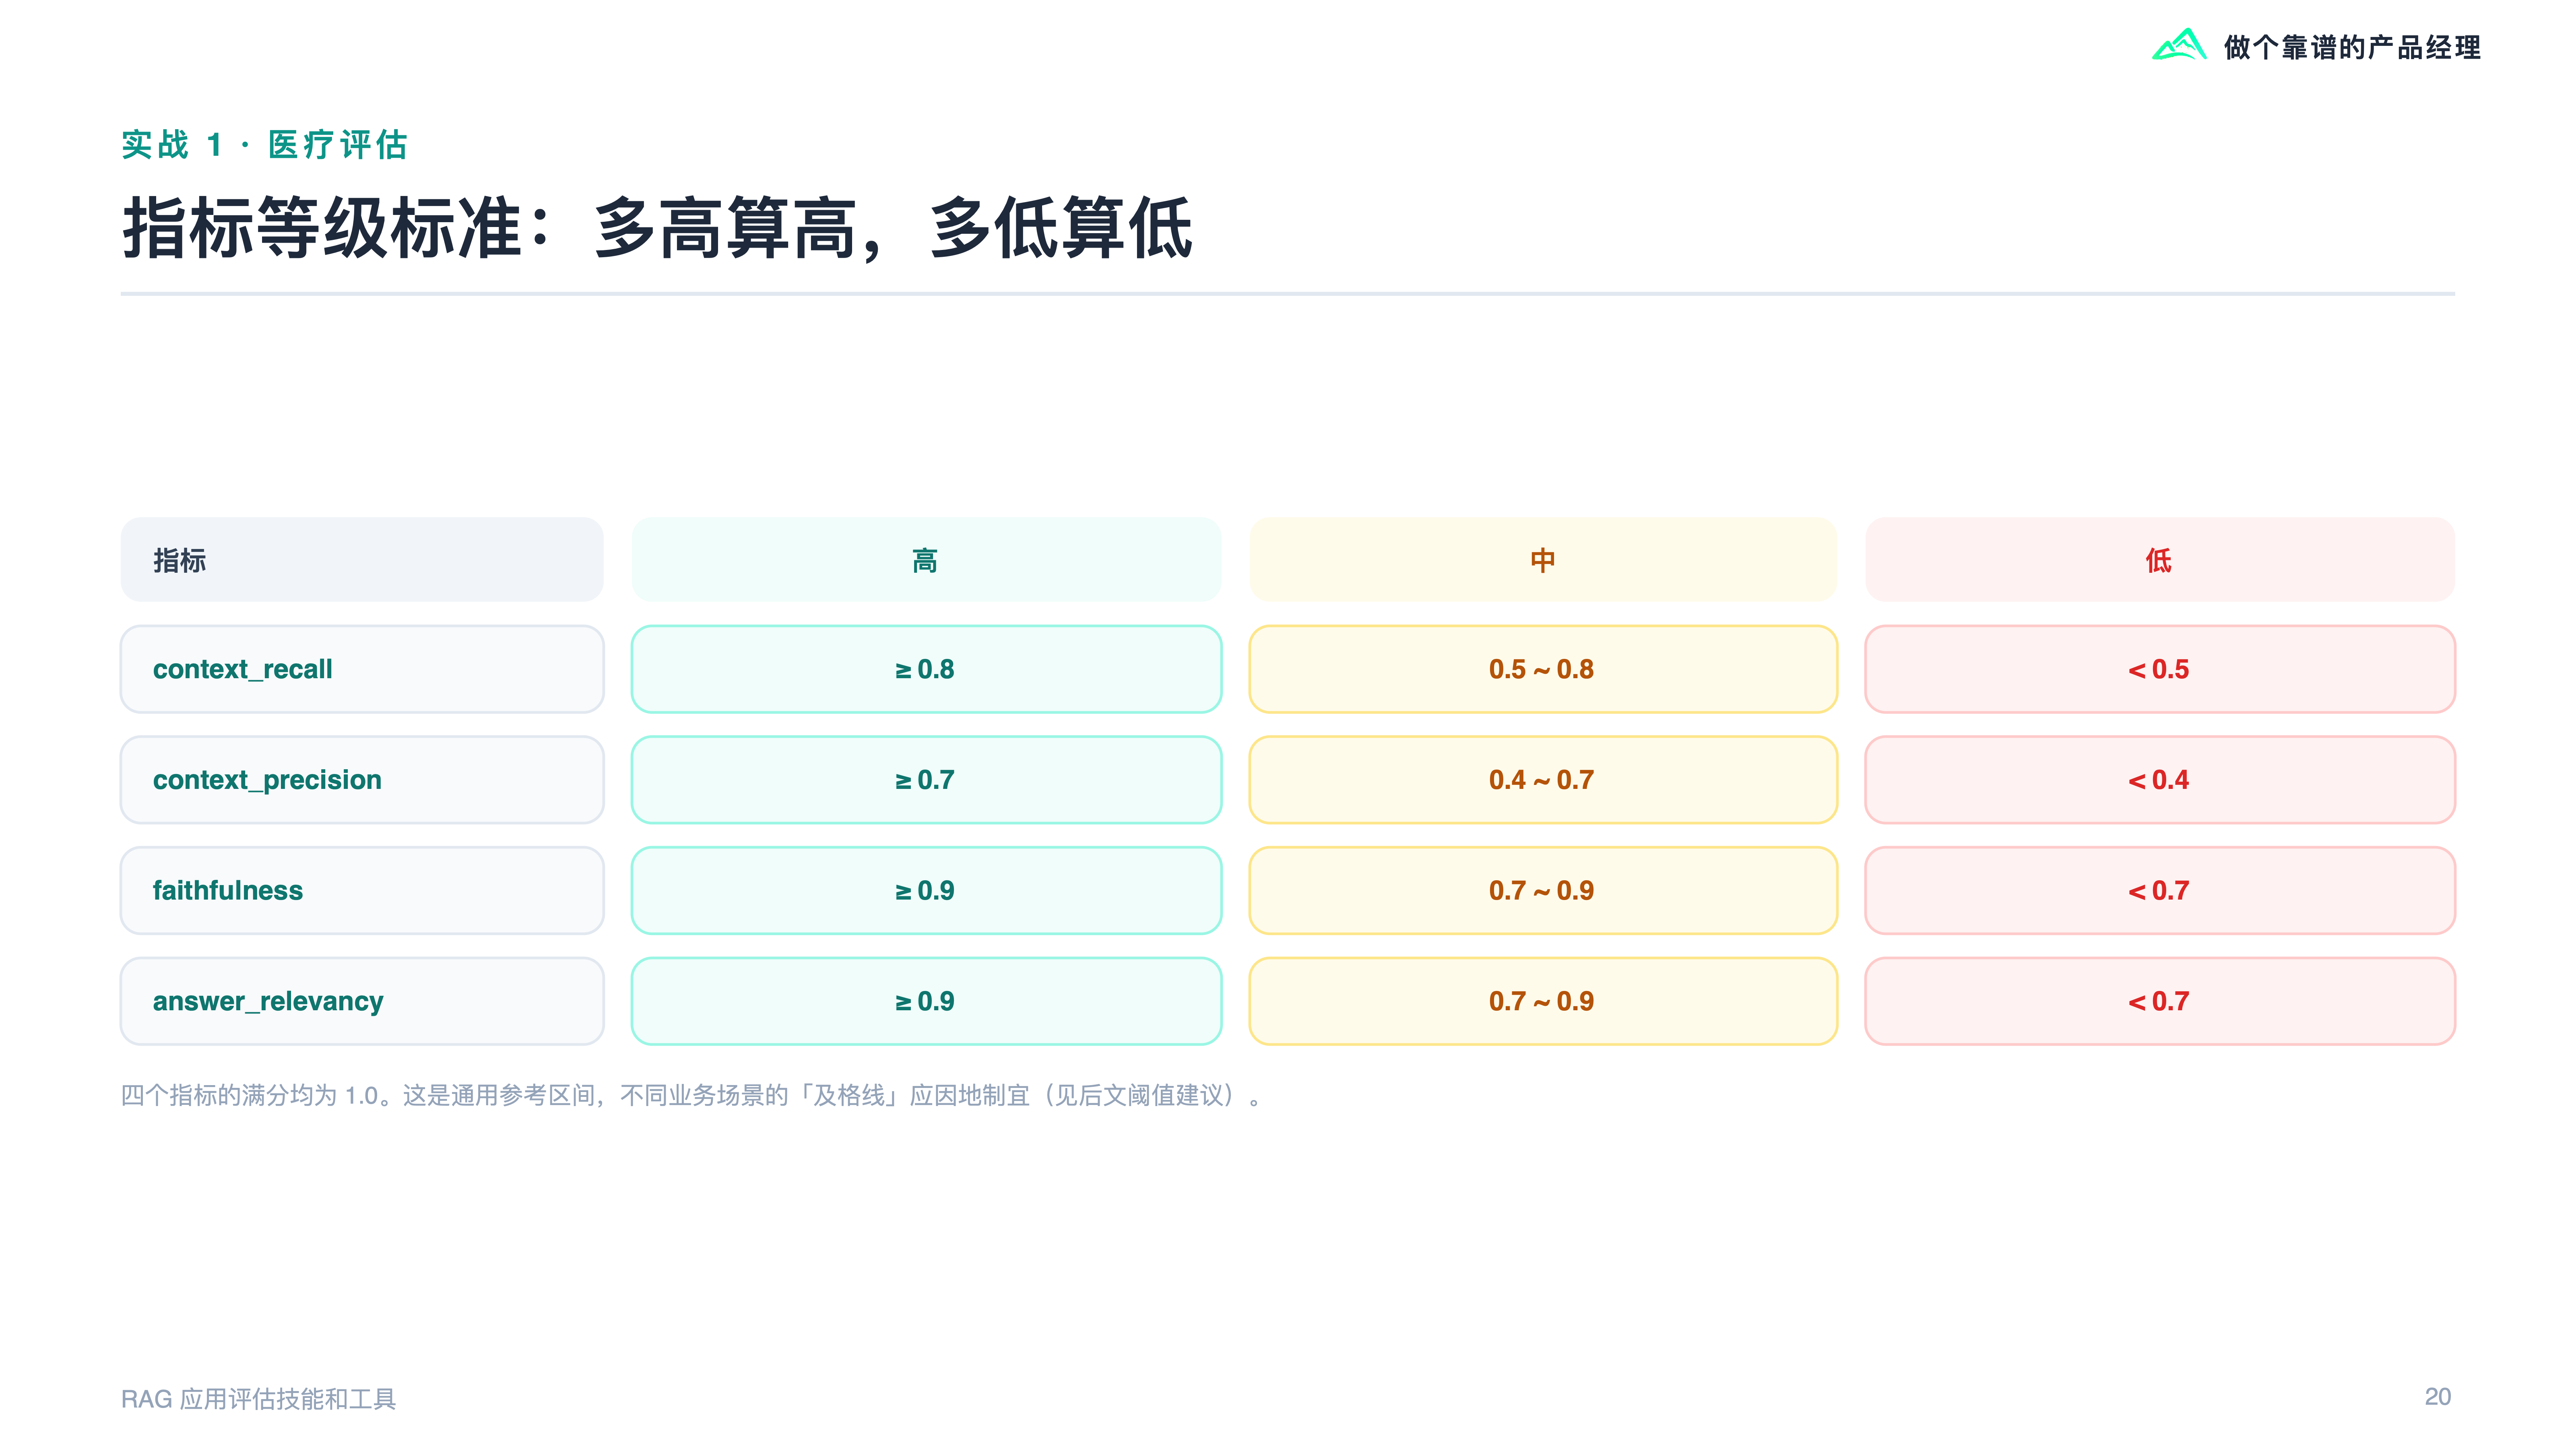
指标等级标准:多高算高,多低算低
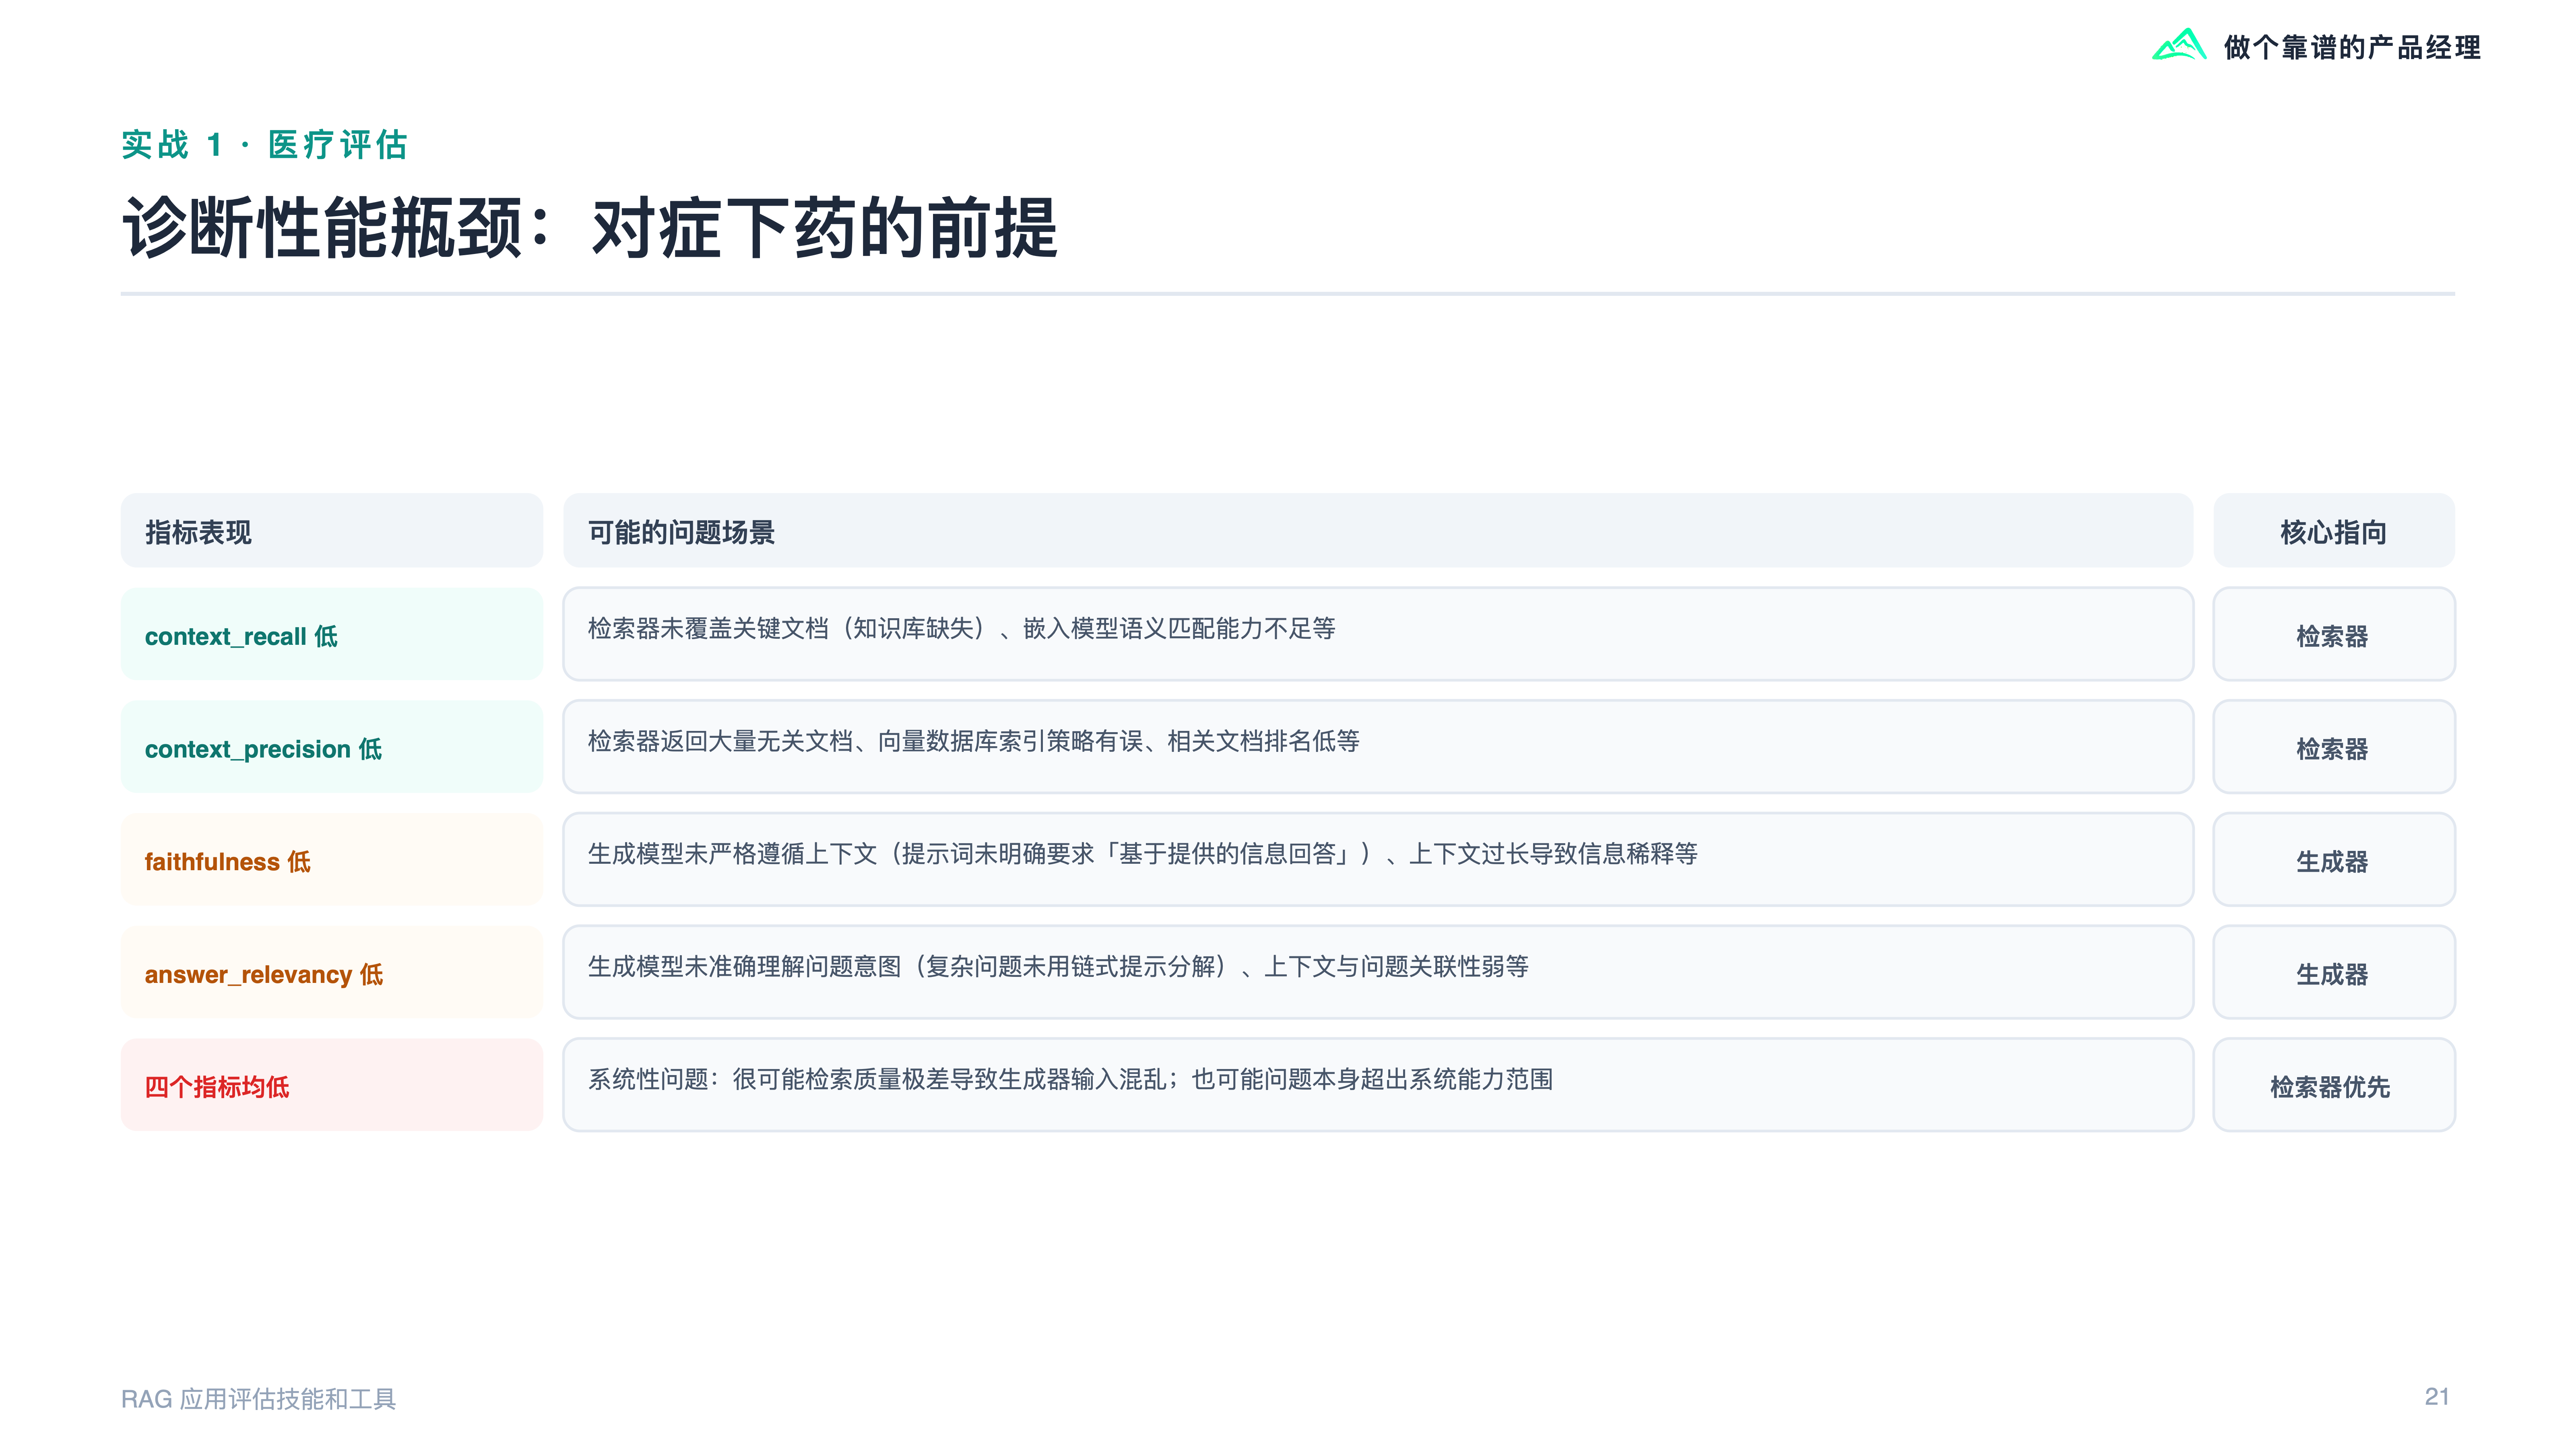
诊断性能瓶颈:对症下药的前提
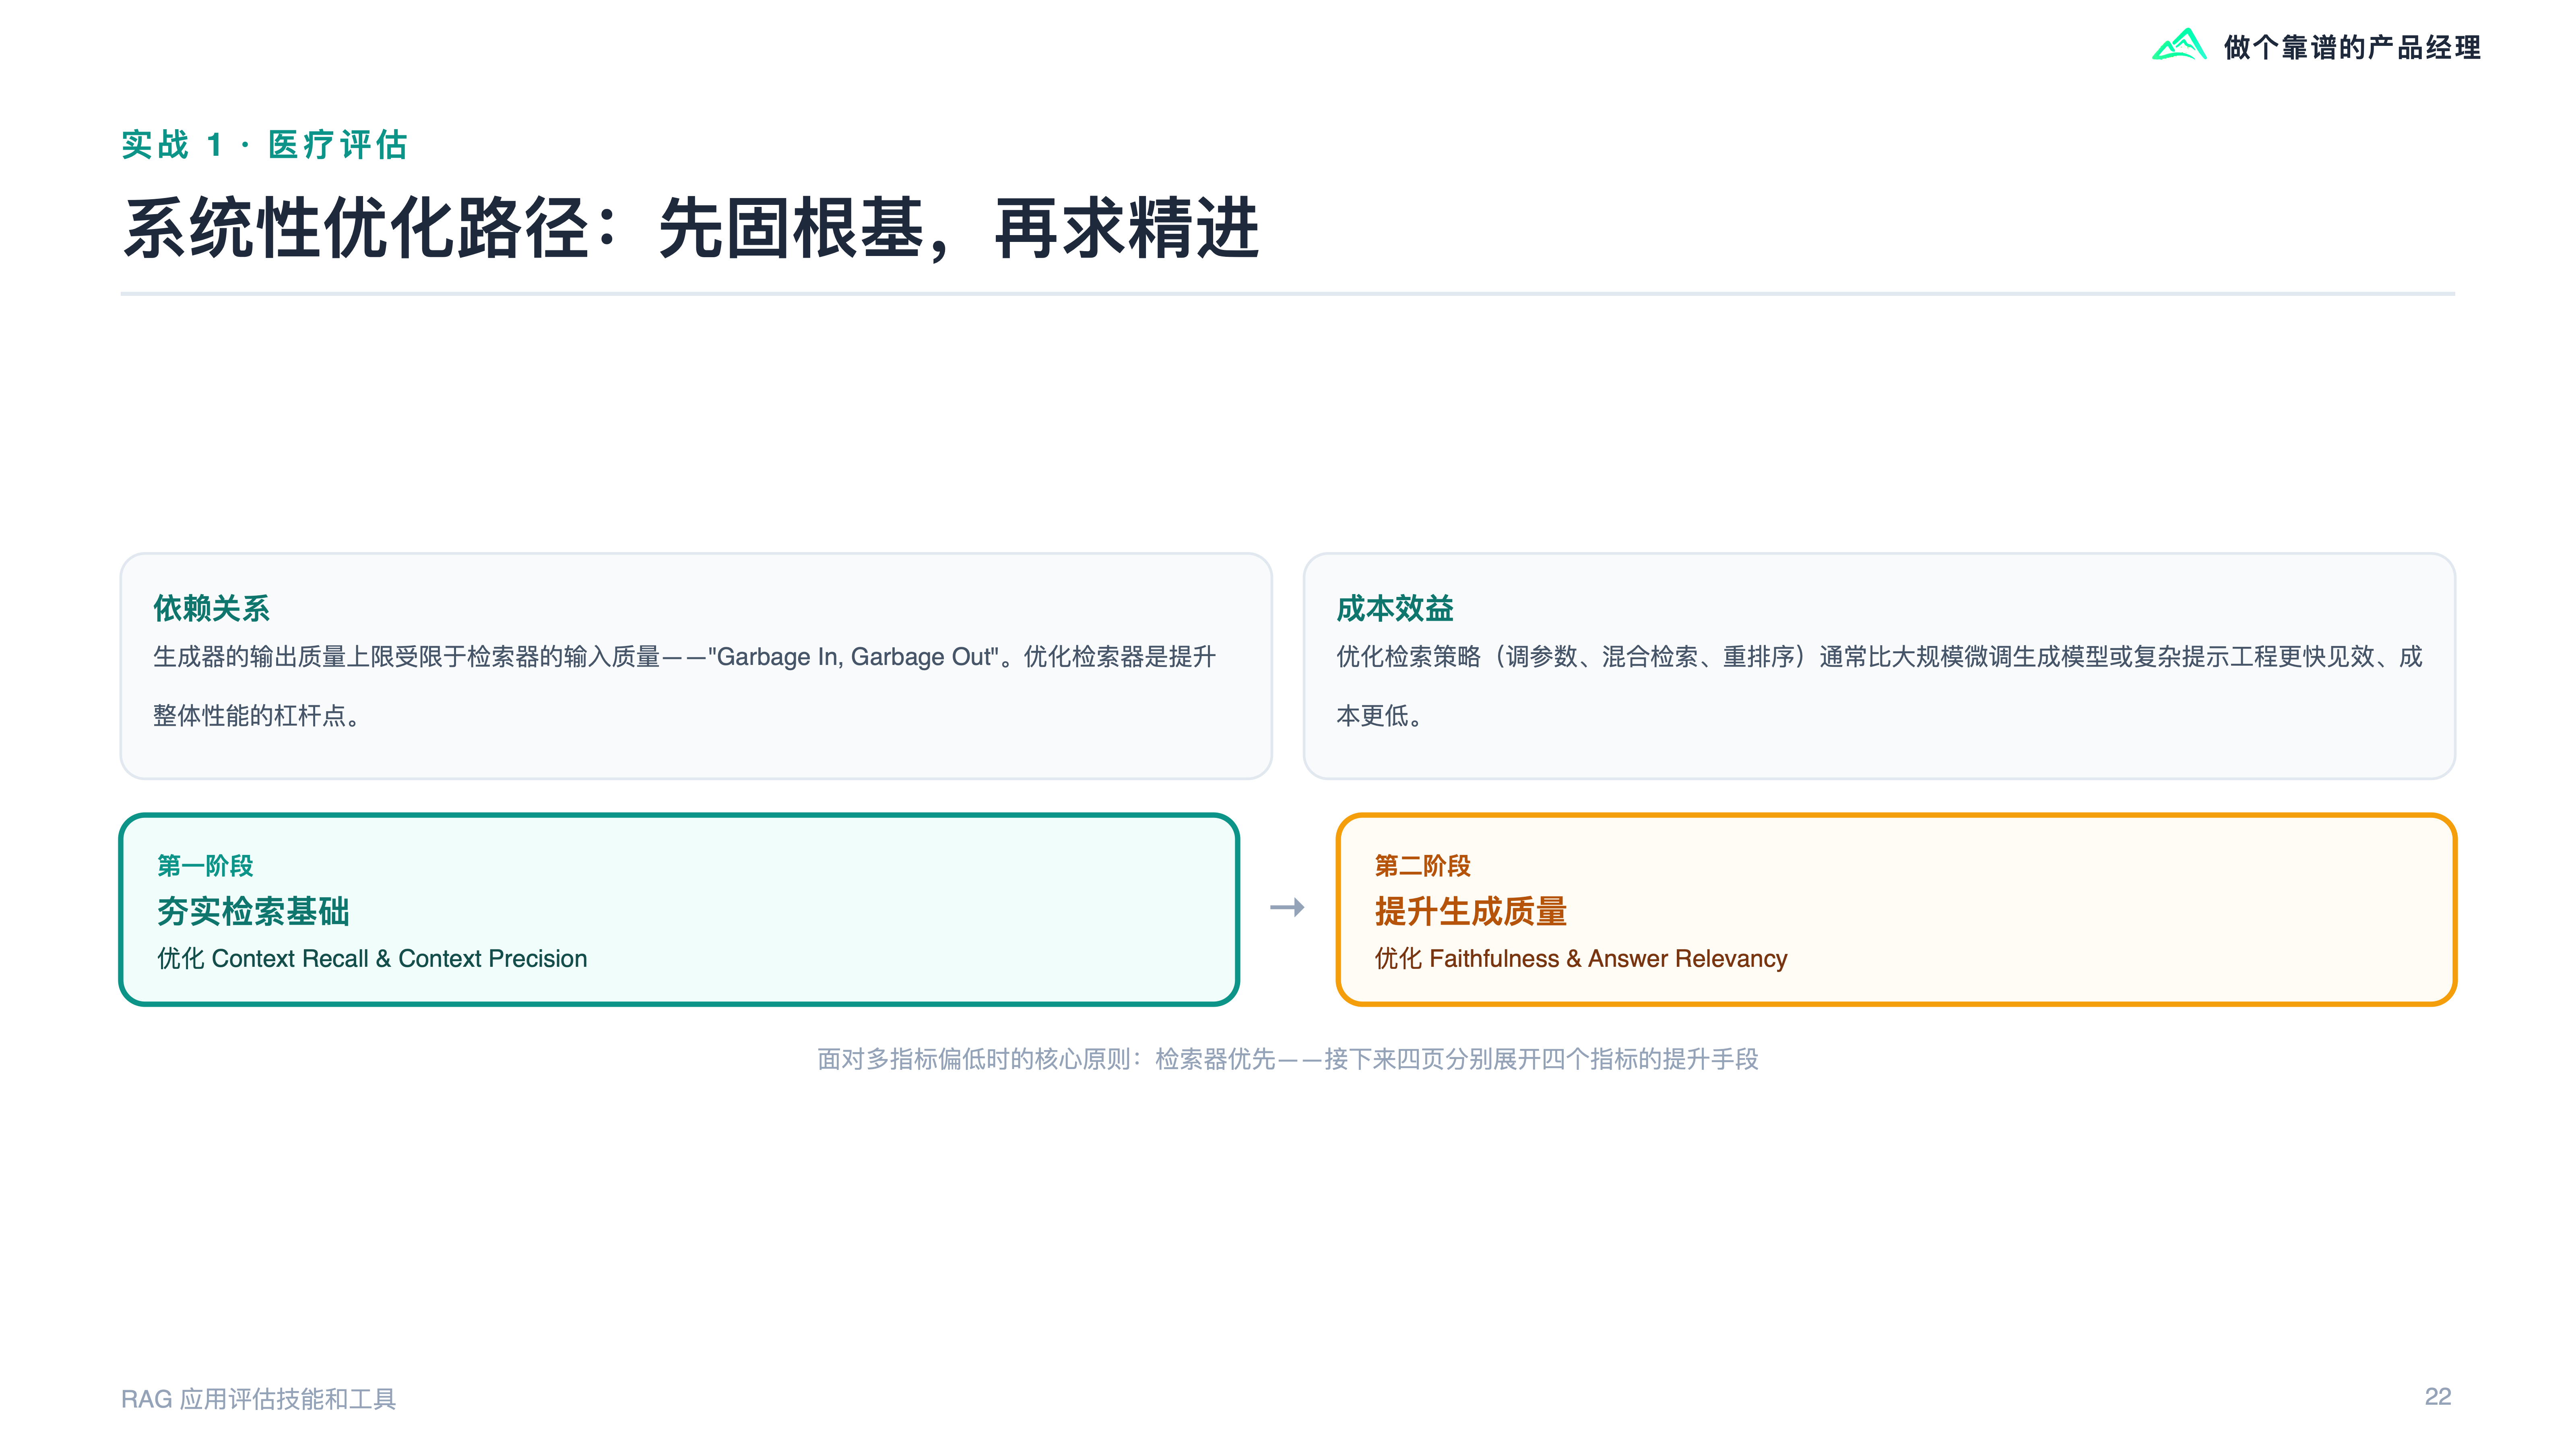
系统性优化路径:先固根基,再求精进
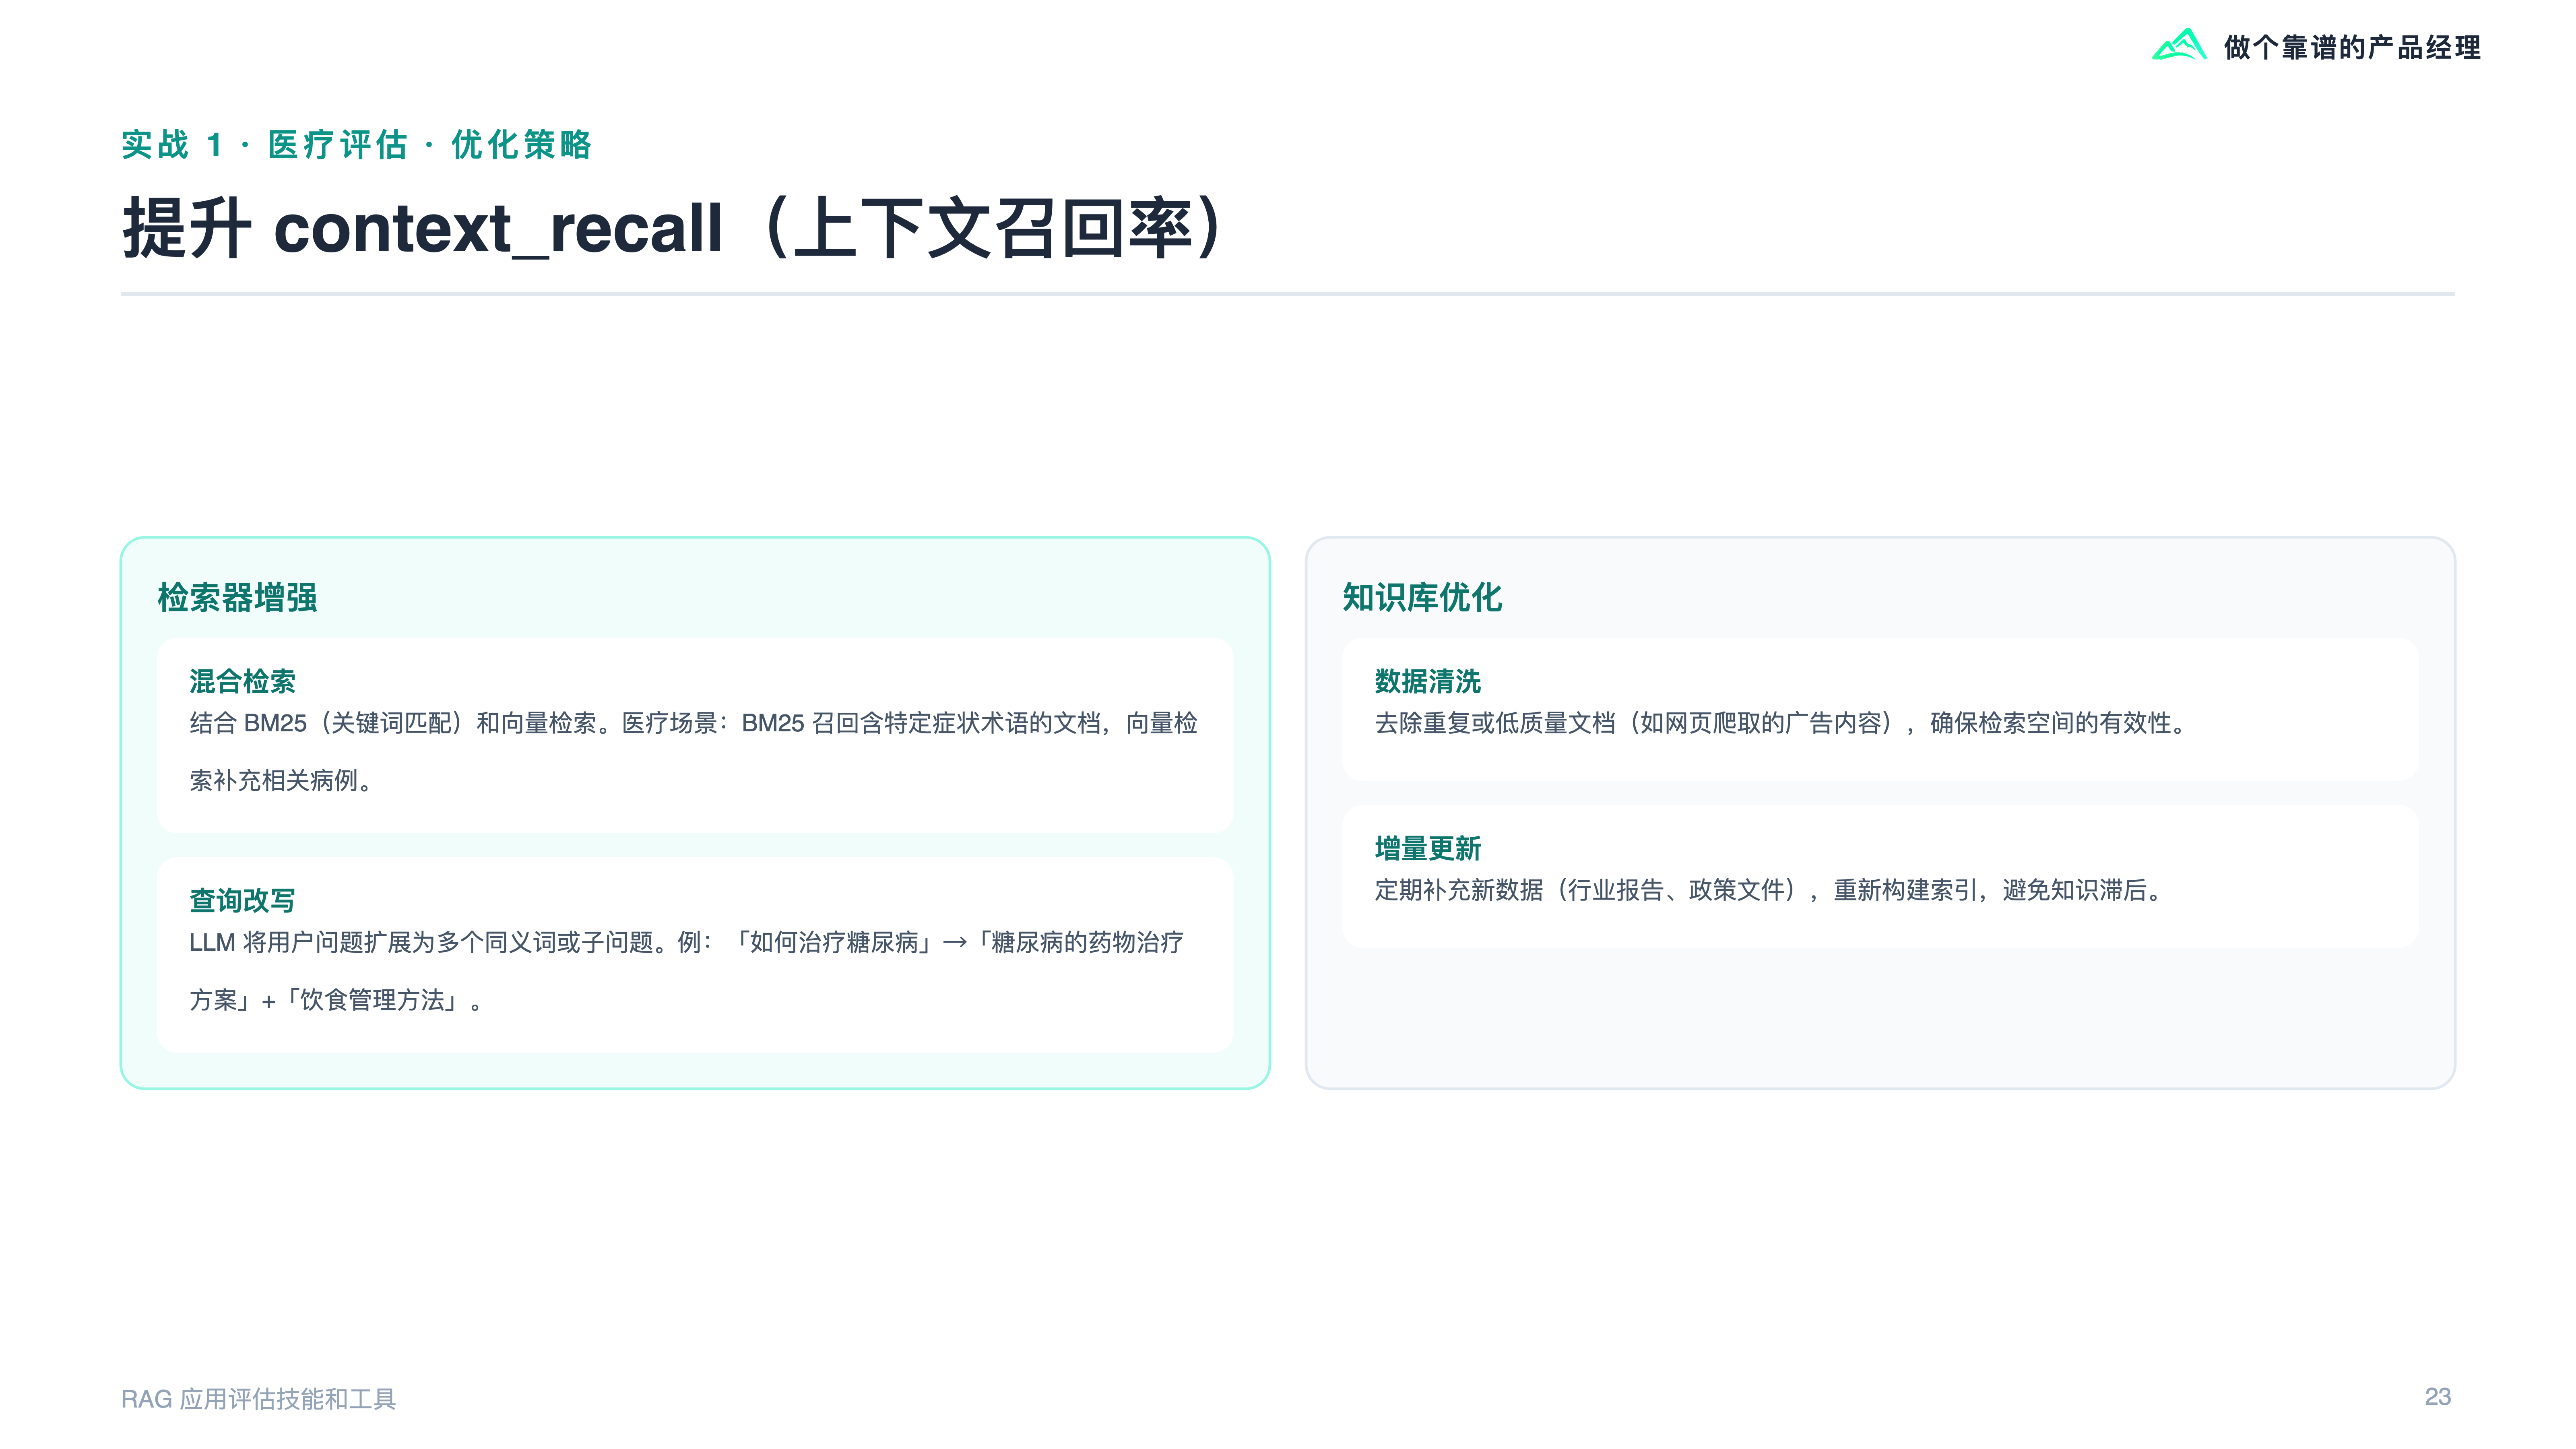
提升 context_recall(上下文召回率)
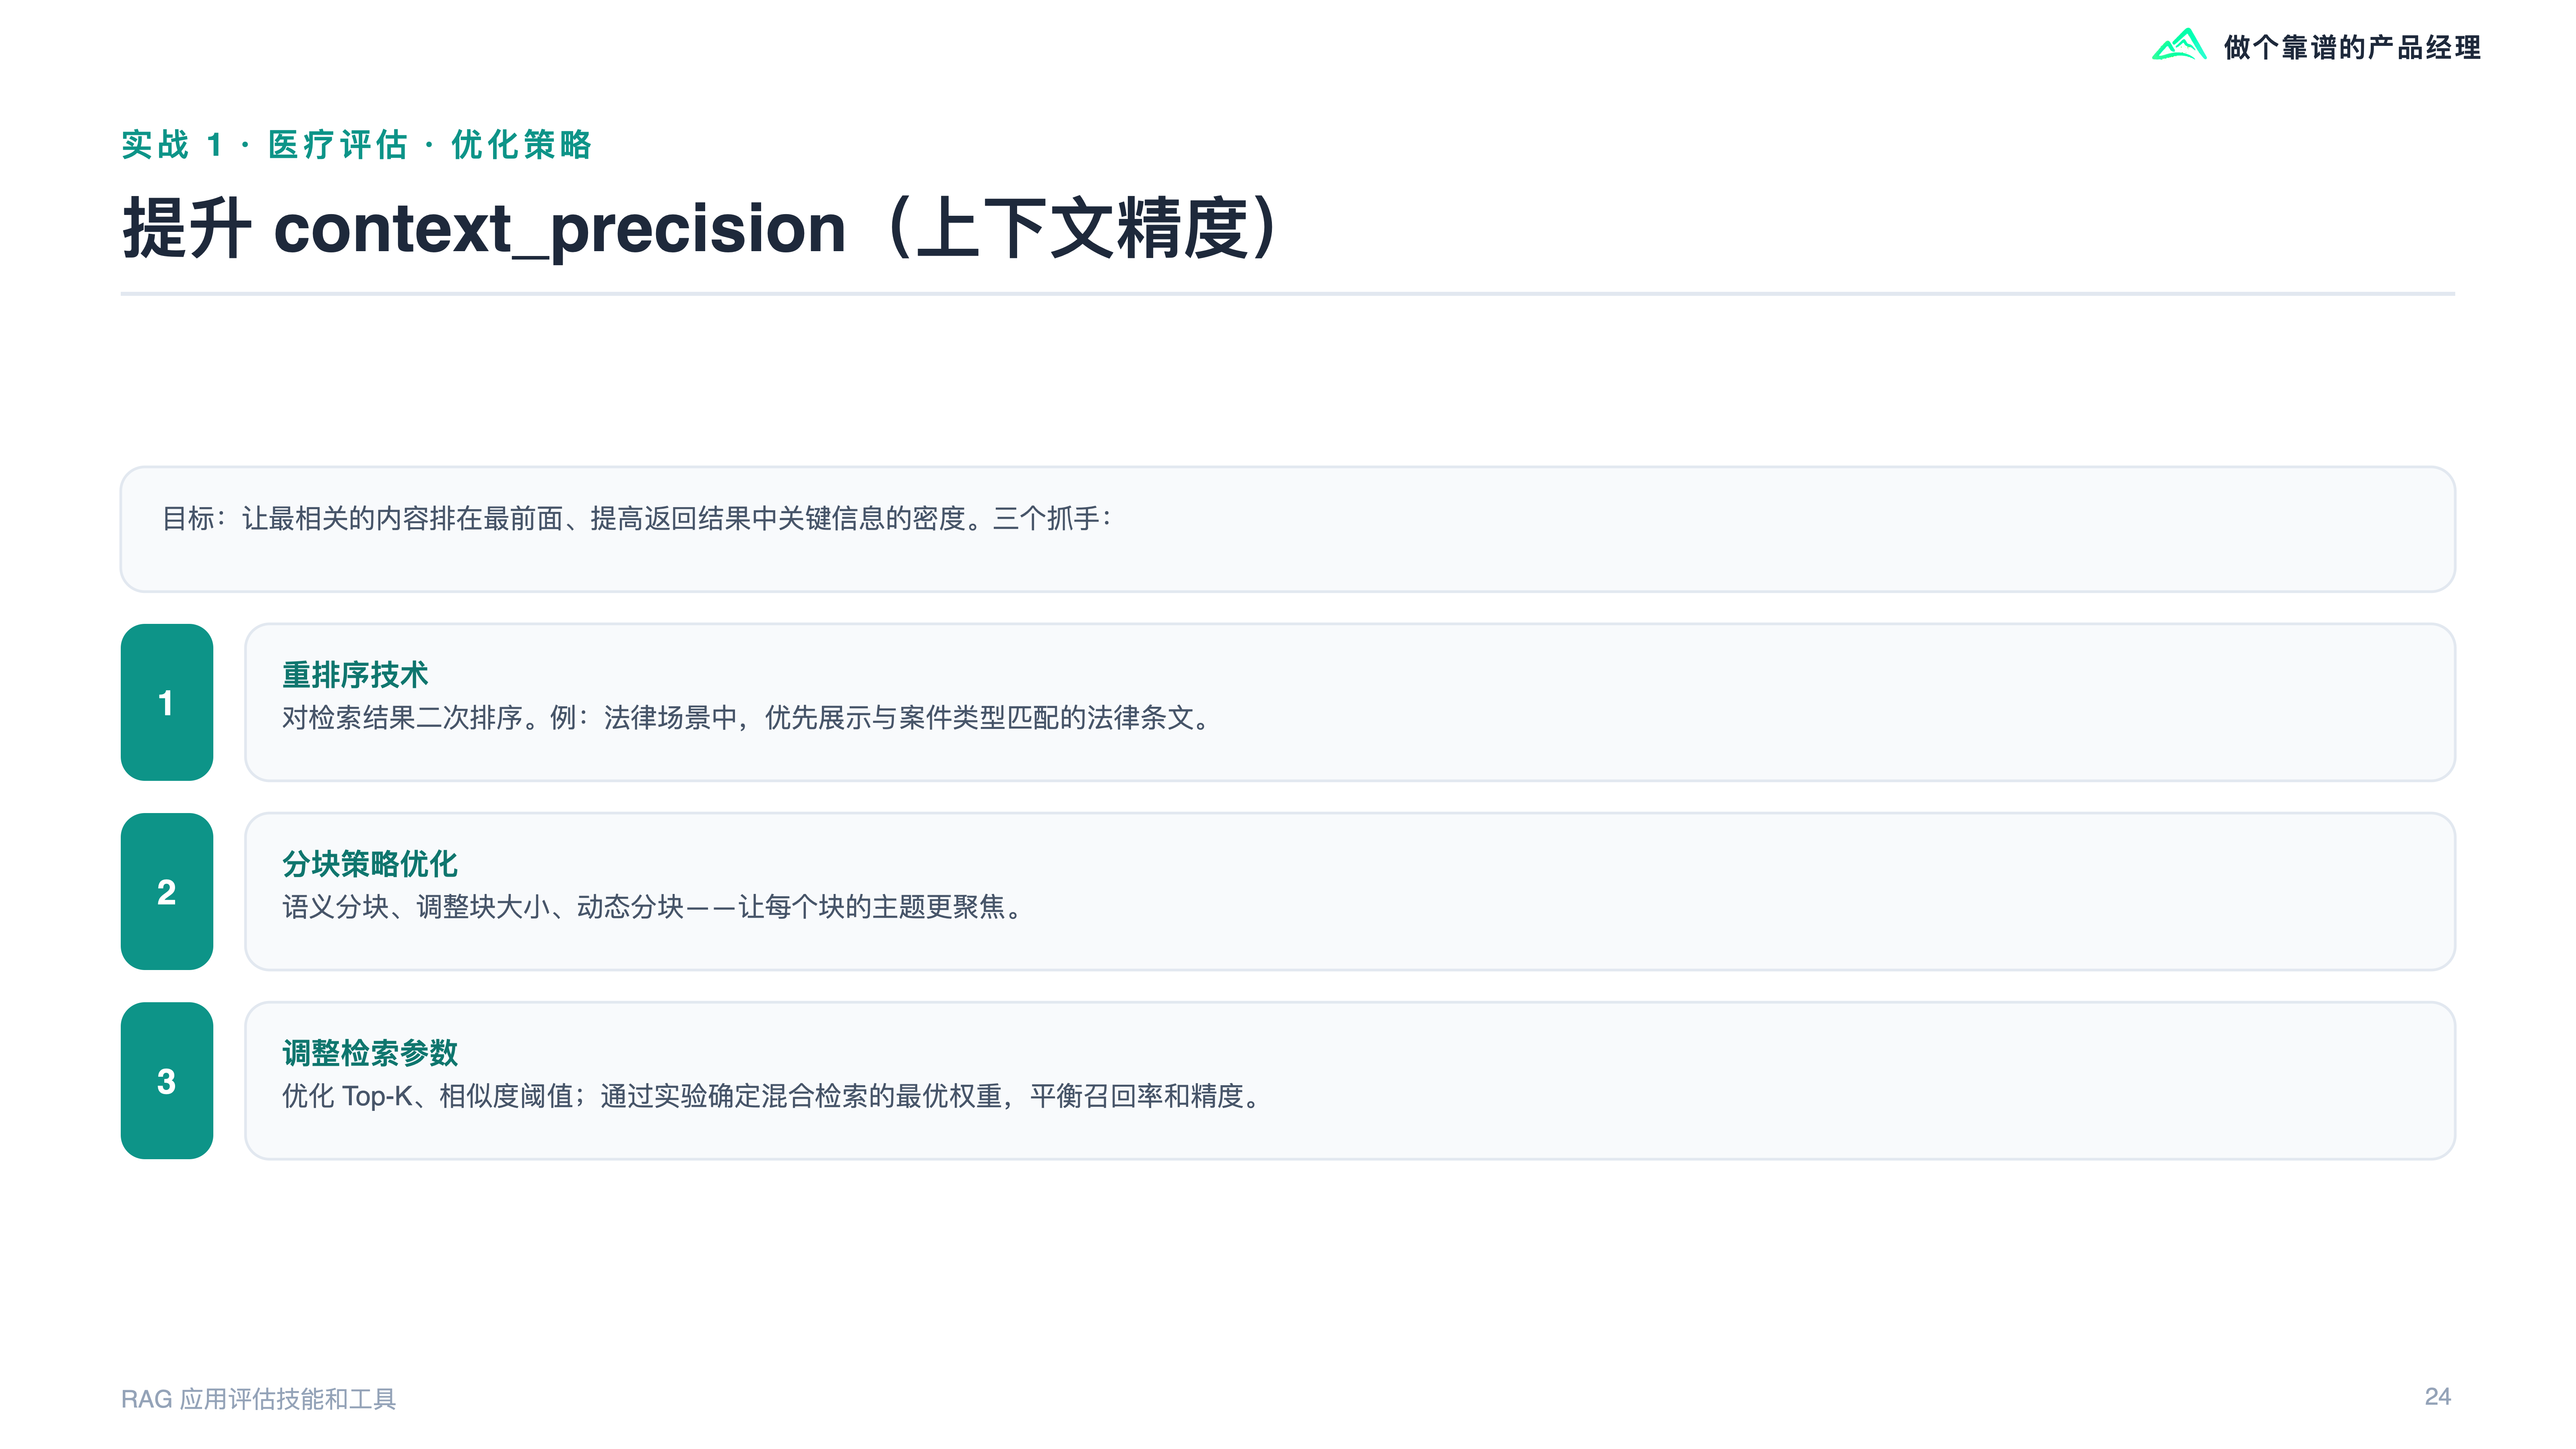
提升 context_precision(上下文精度)
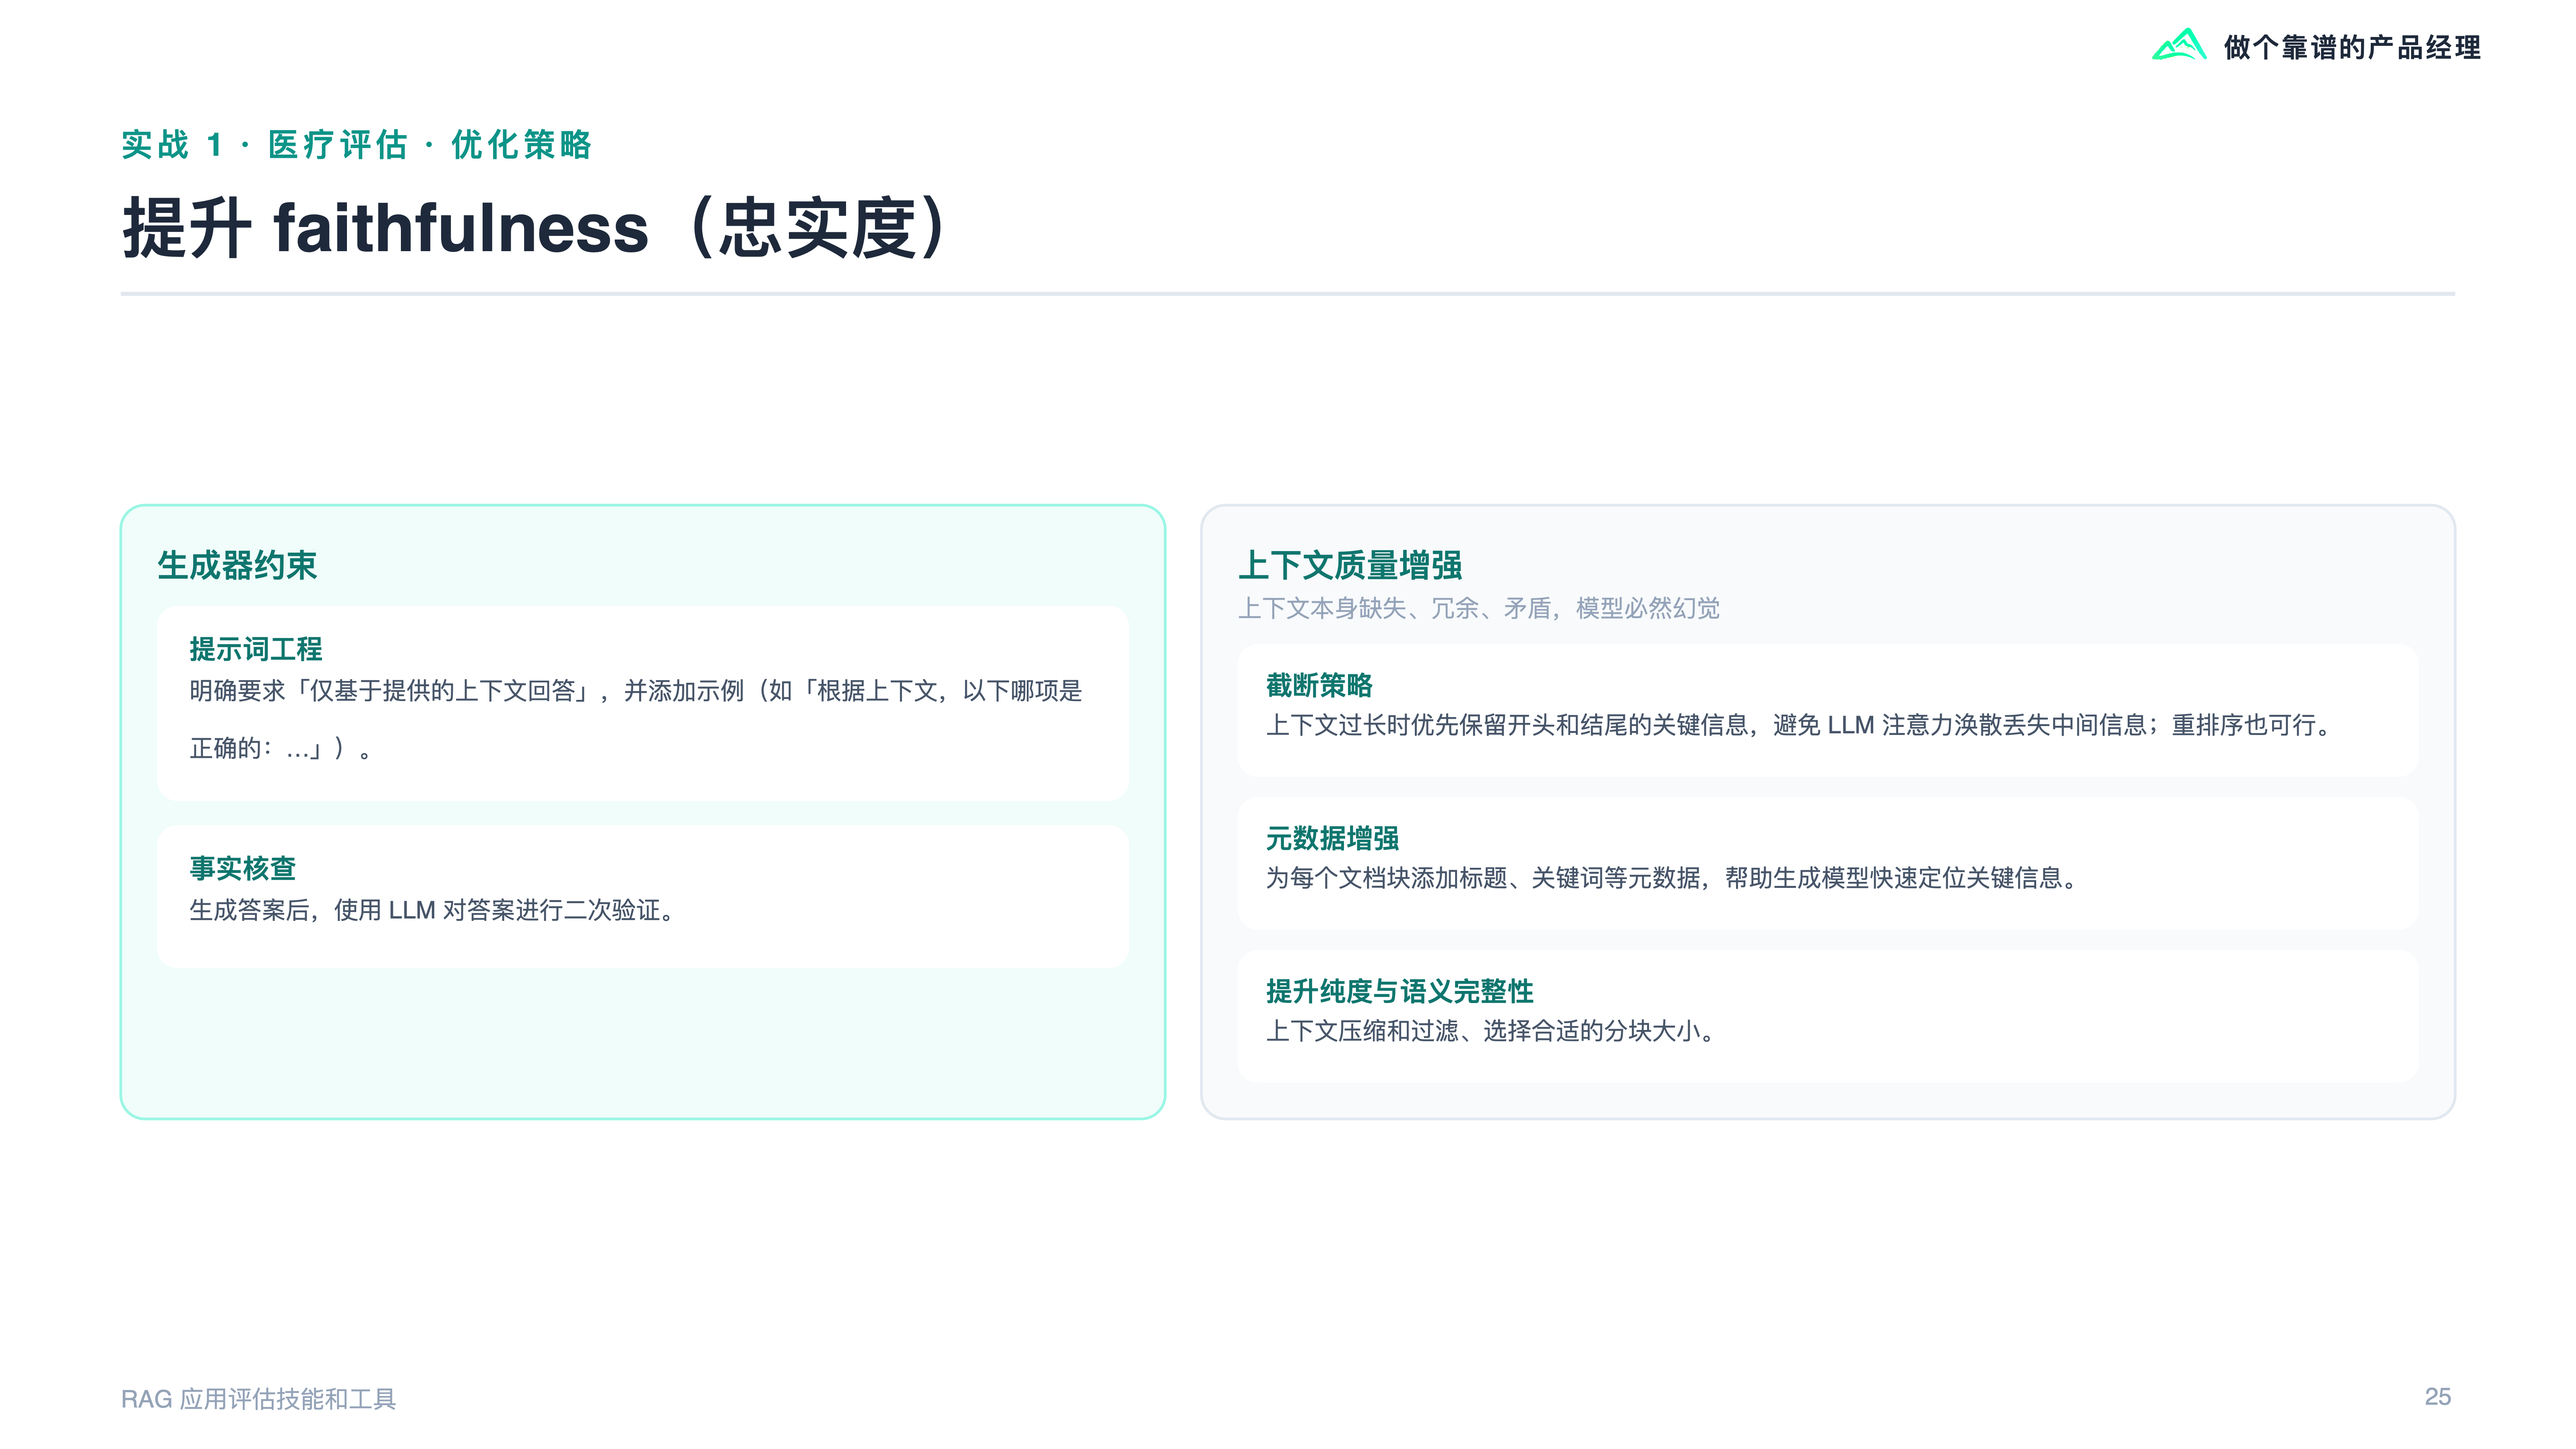
提升 faithfulness(忠实度)
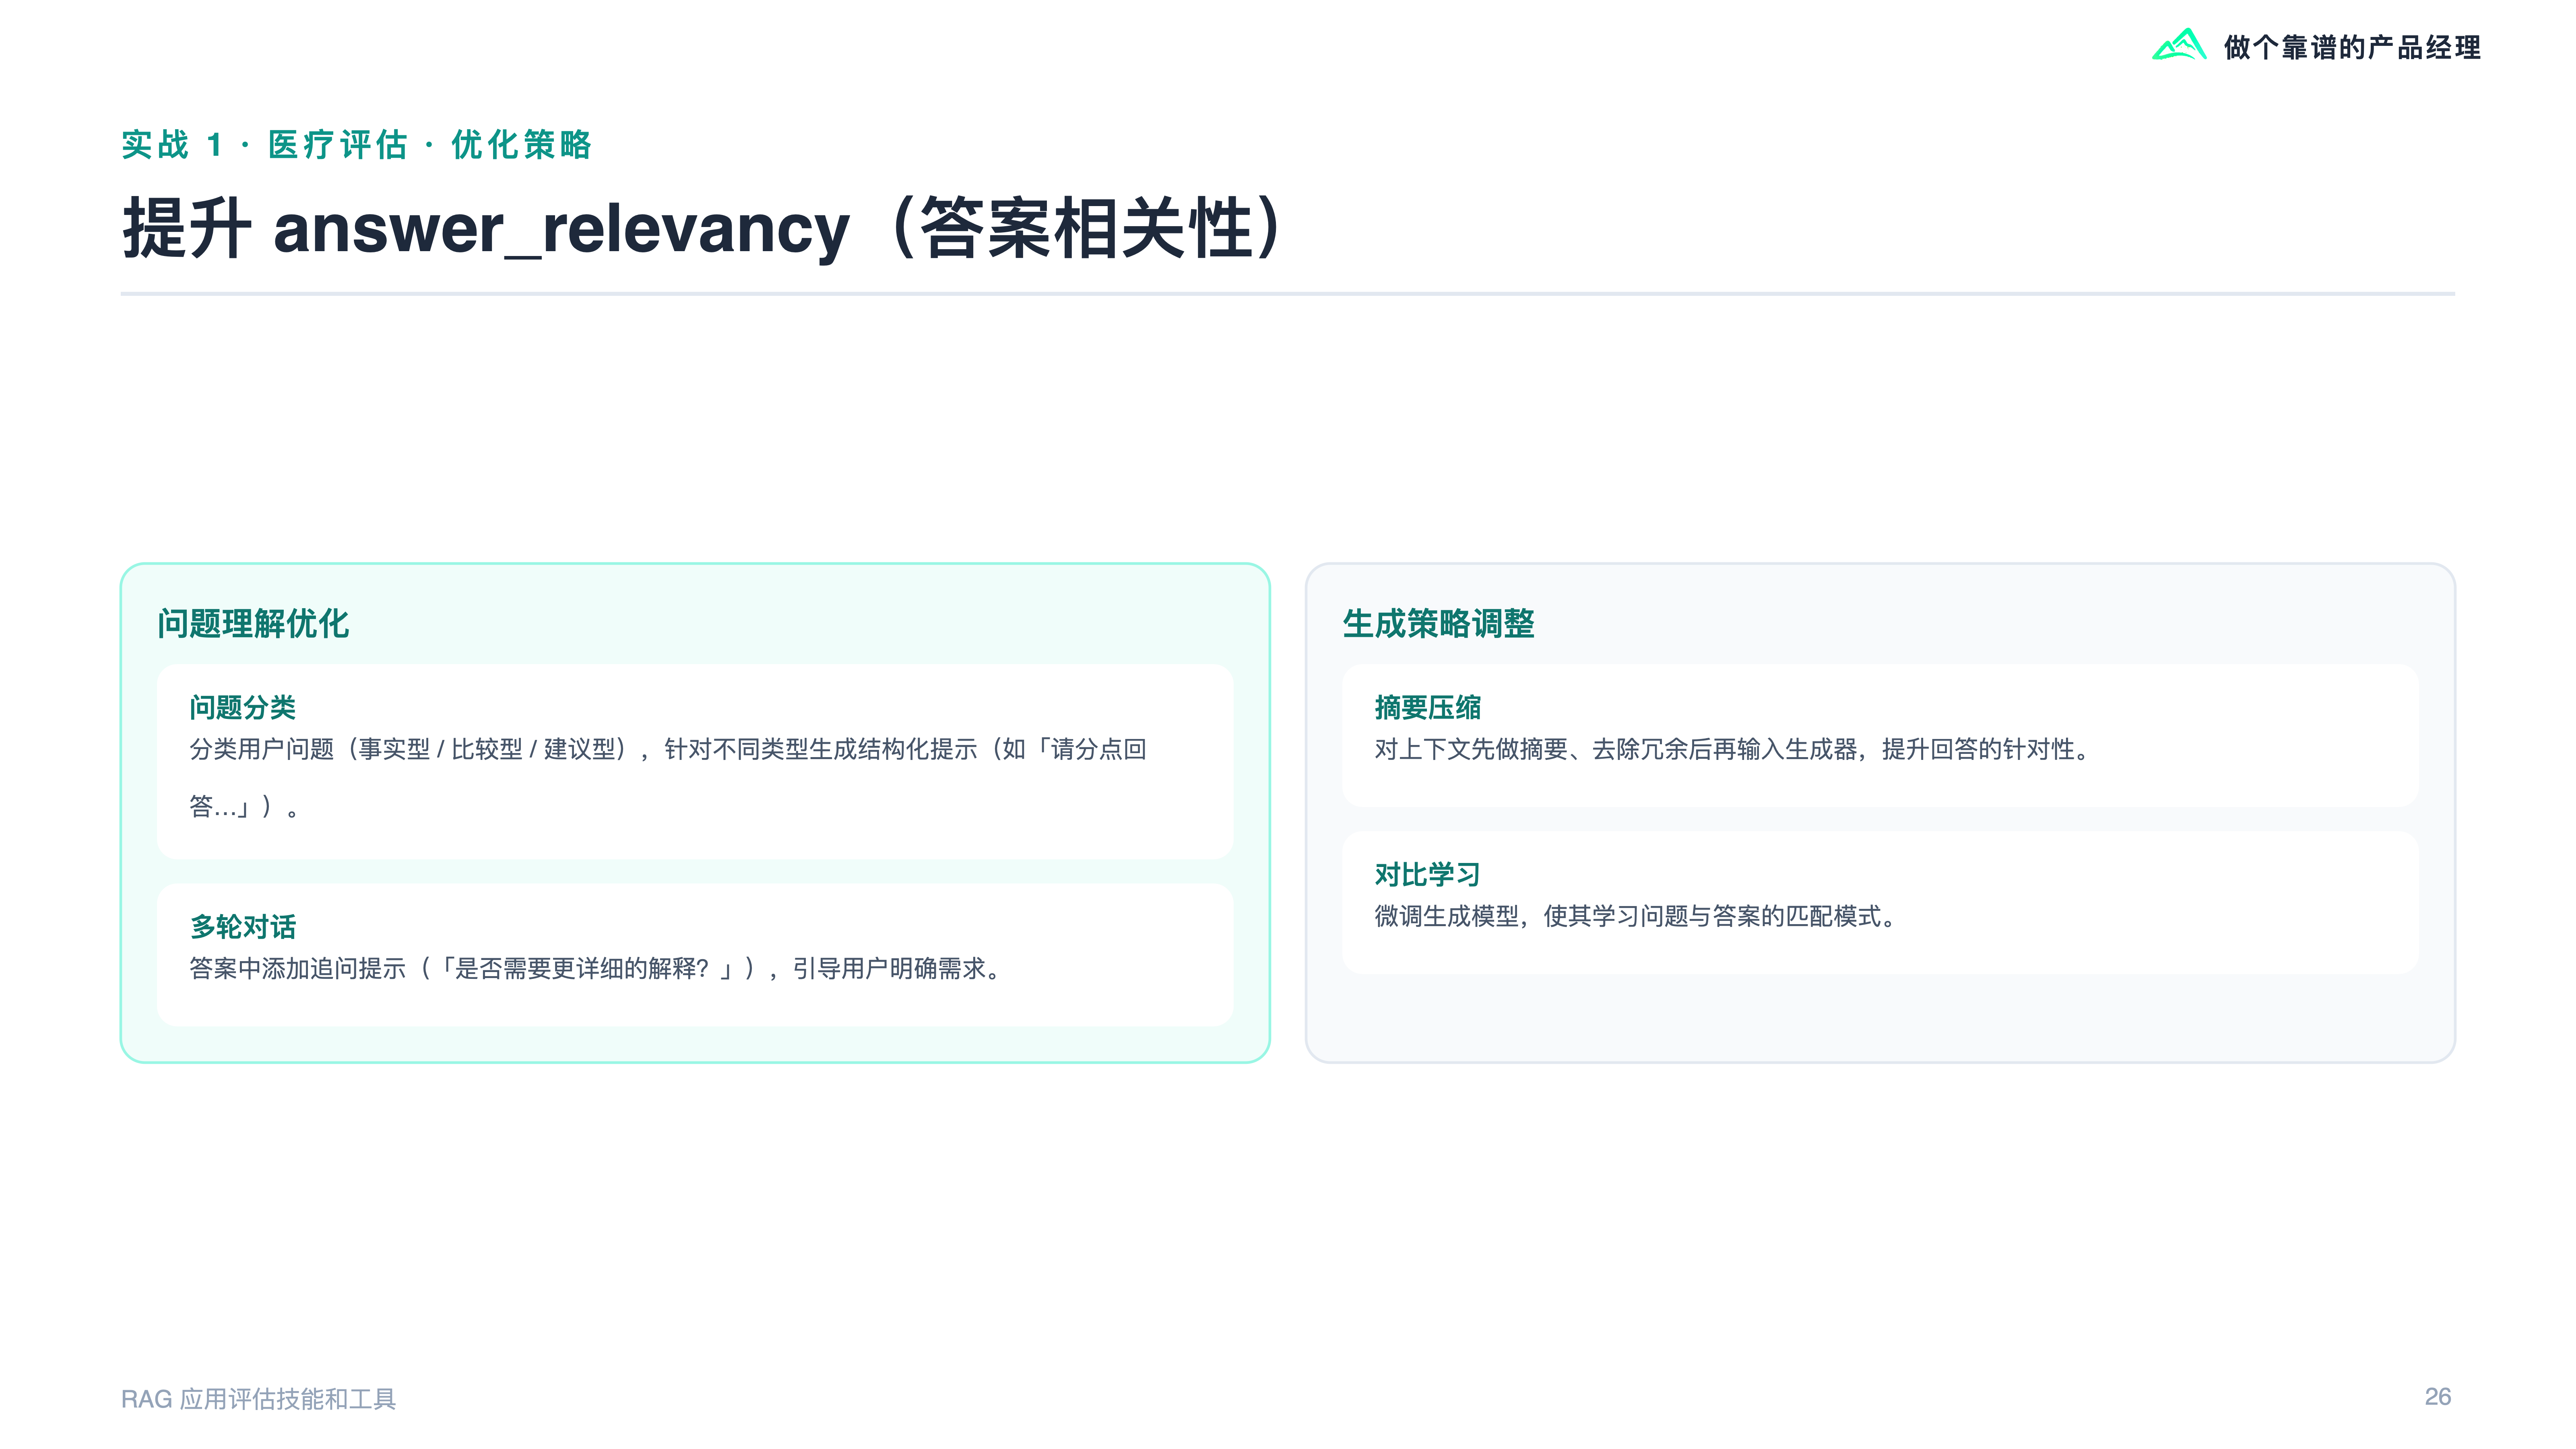
提升 answer_relevancy(答案相关性)
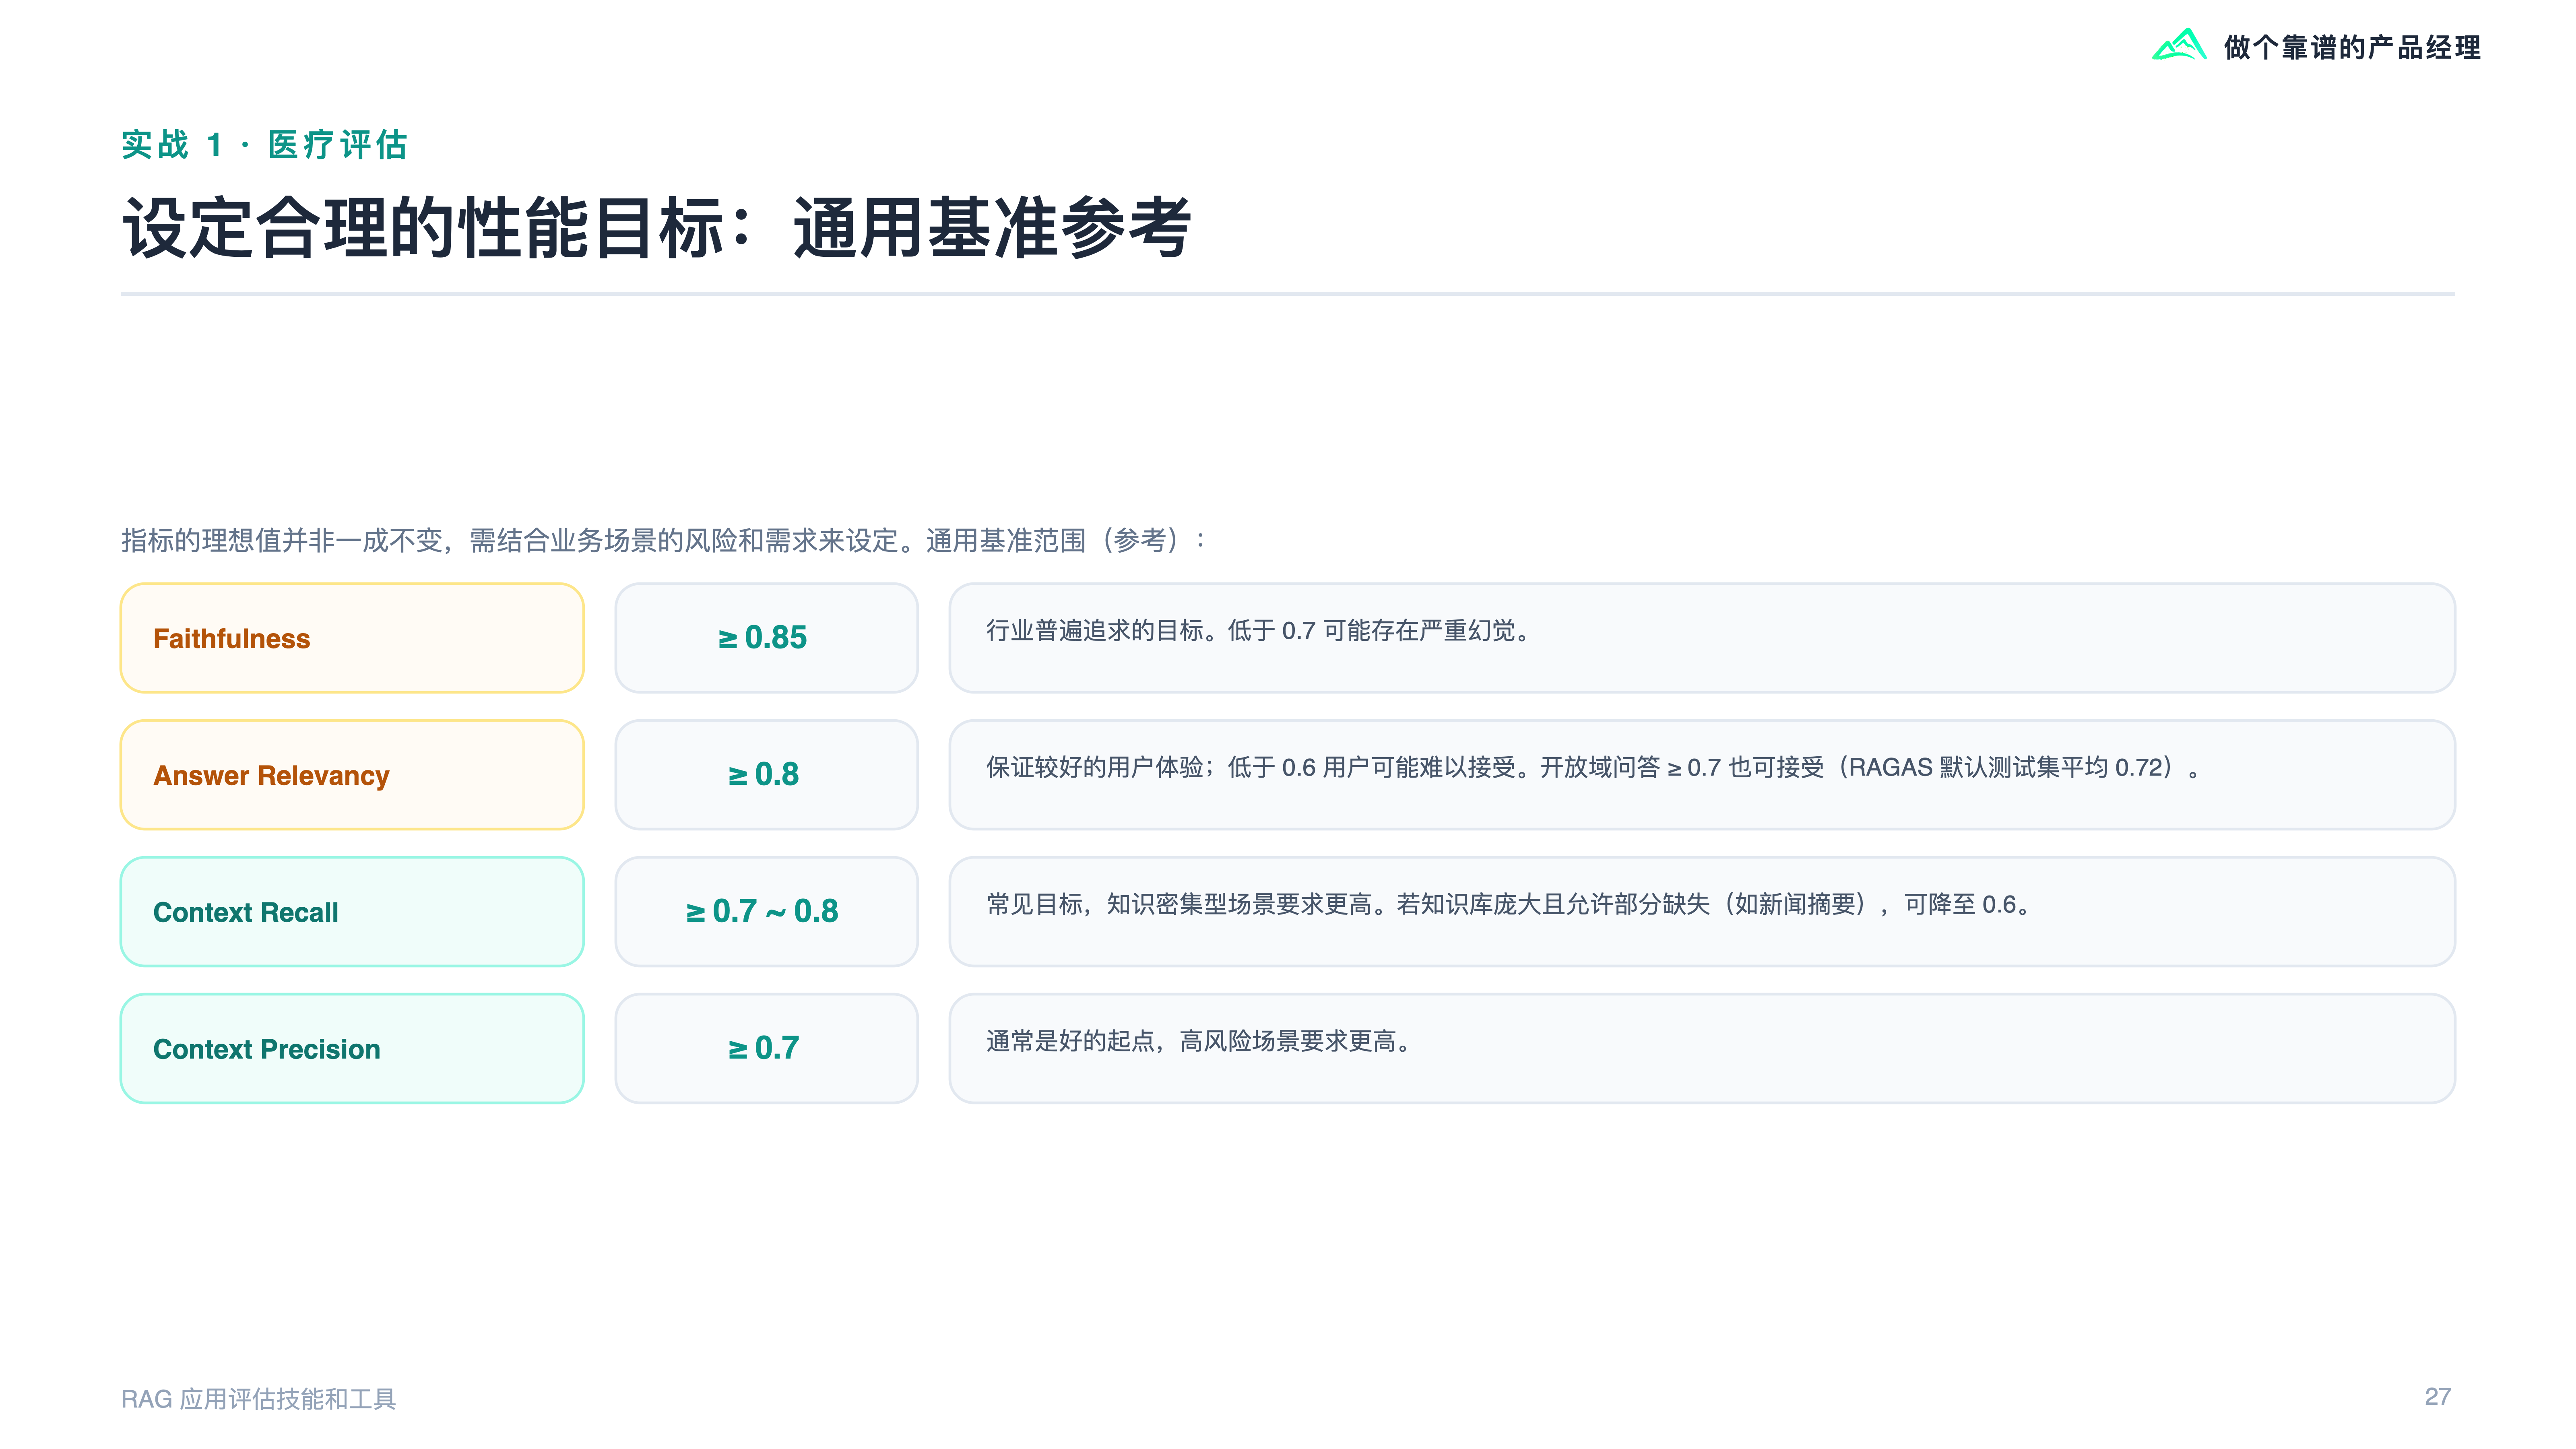
设定合理的性能目标:通用基准参考
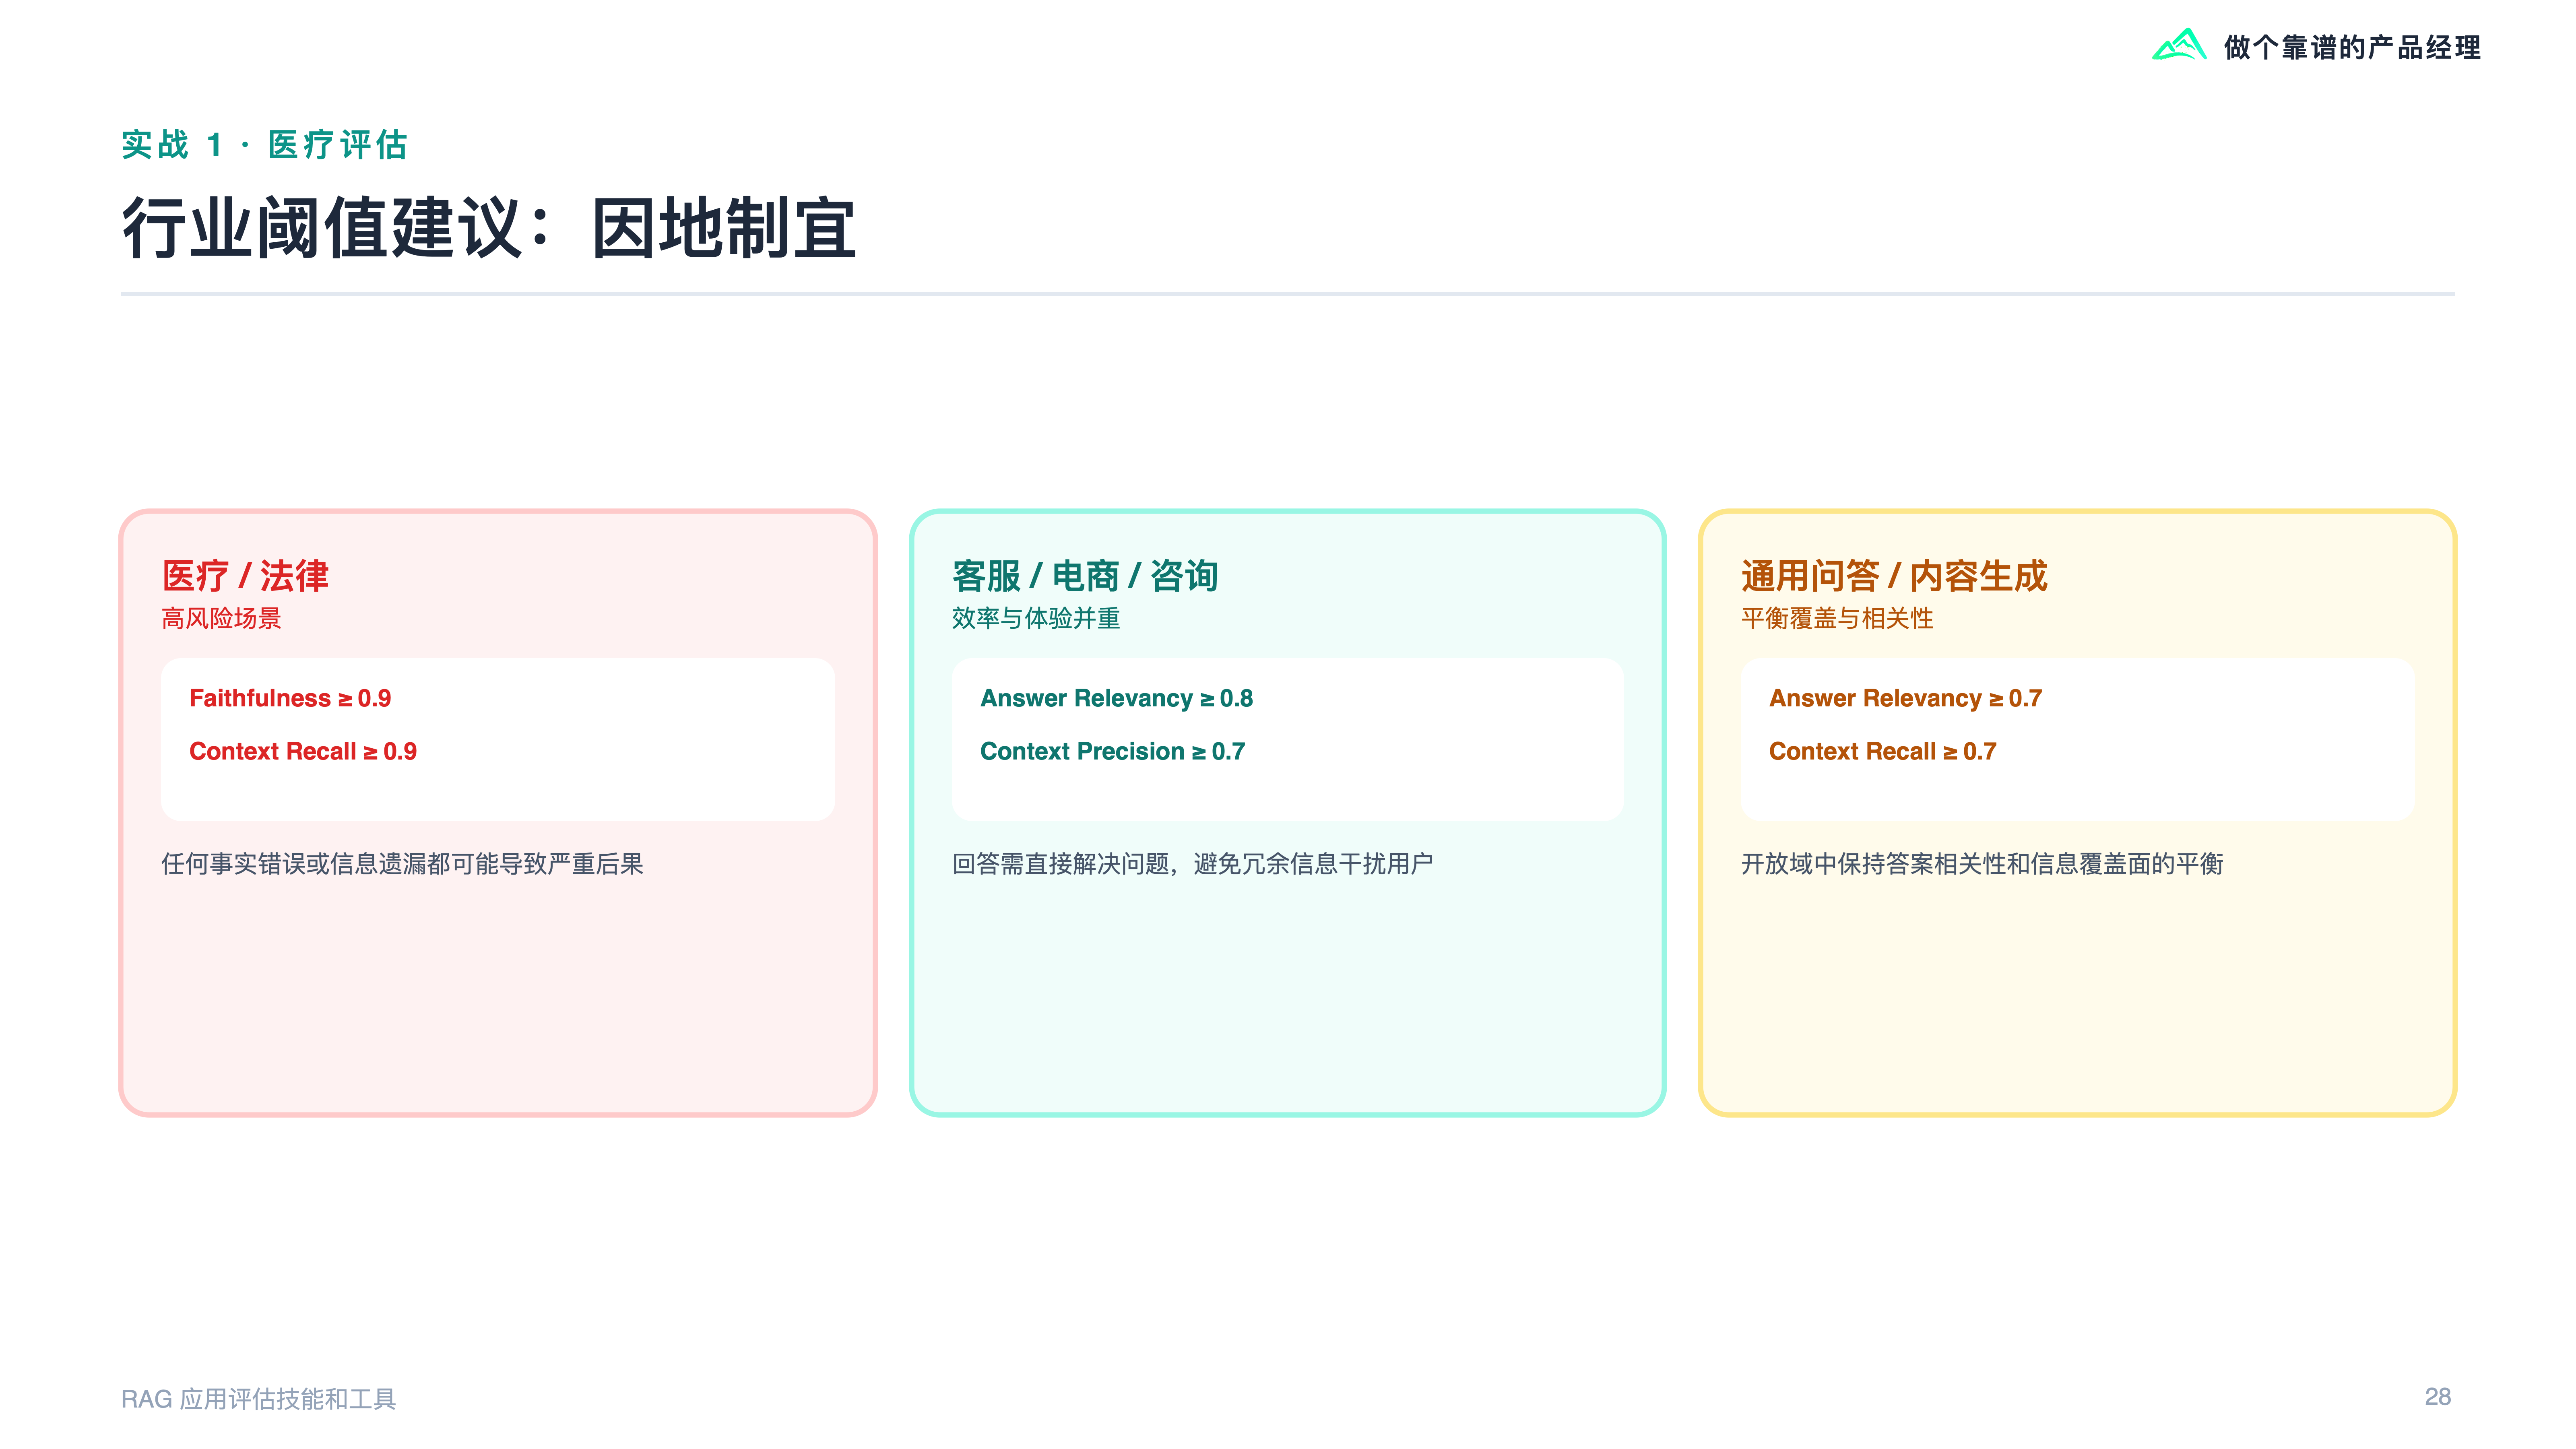
行业阈值建议:因地制宜
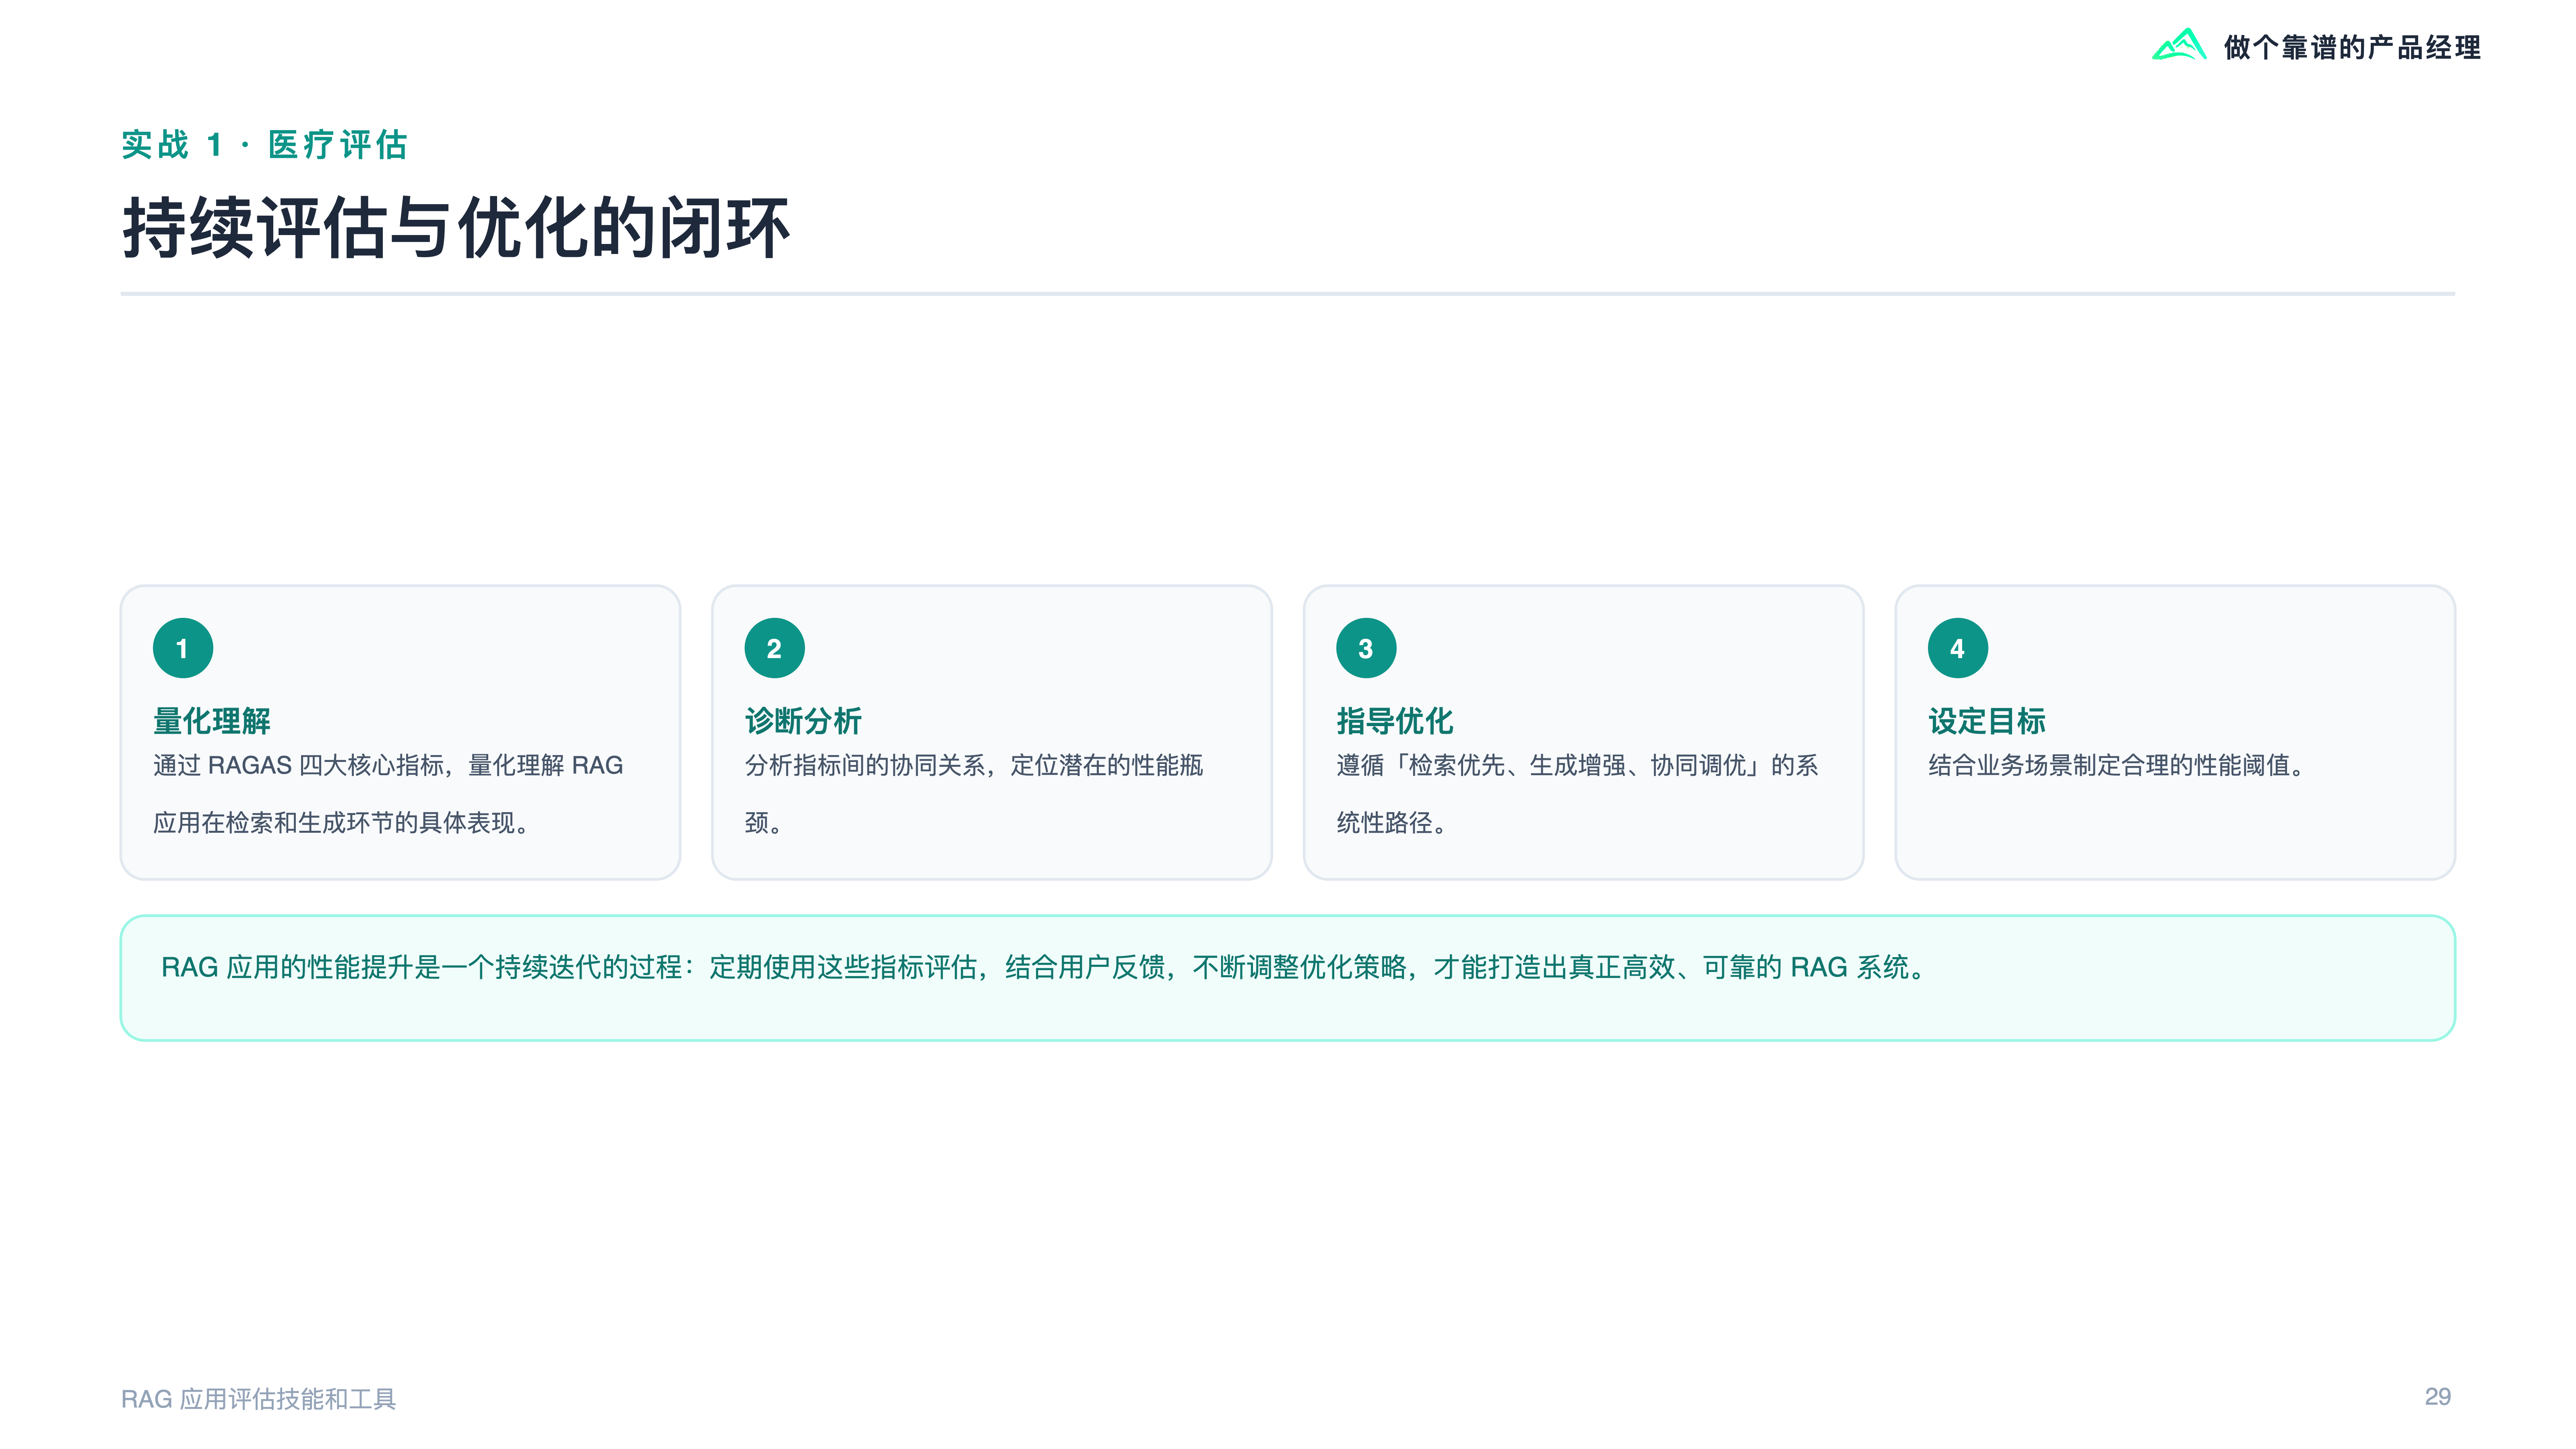
持续评估与优化的闭环
4
评估选择合适的知识块大小
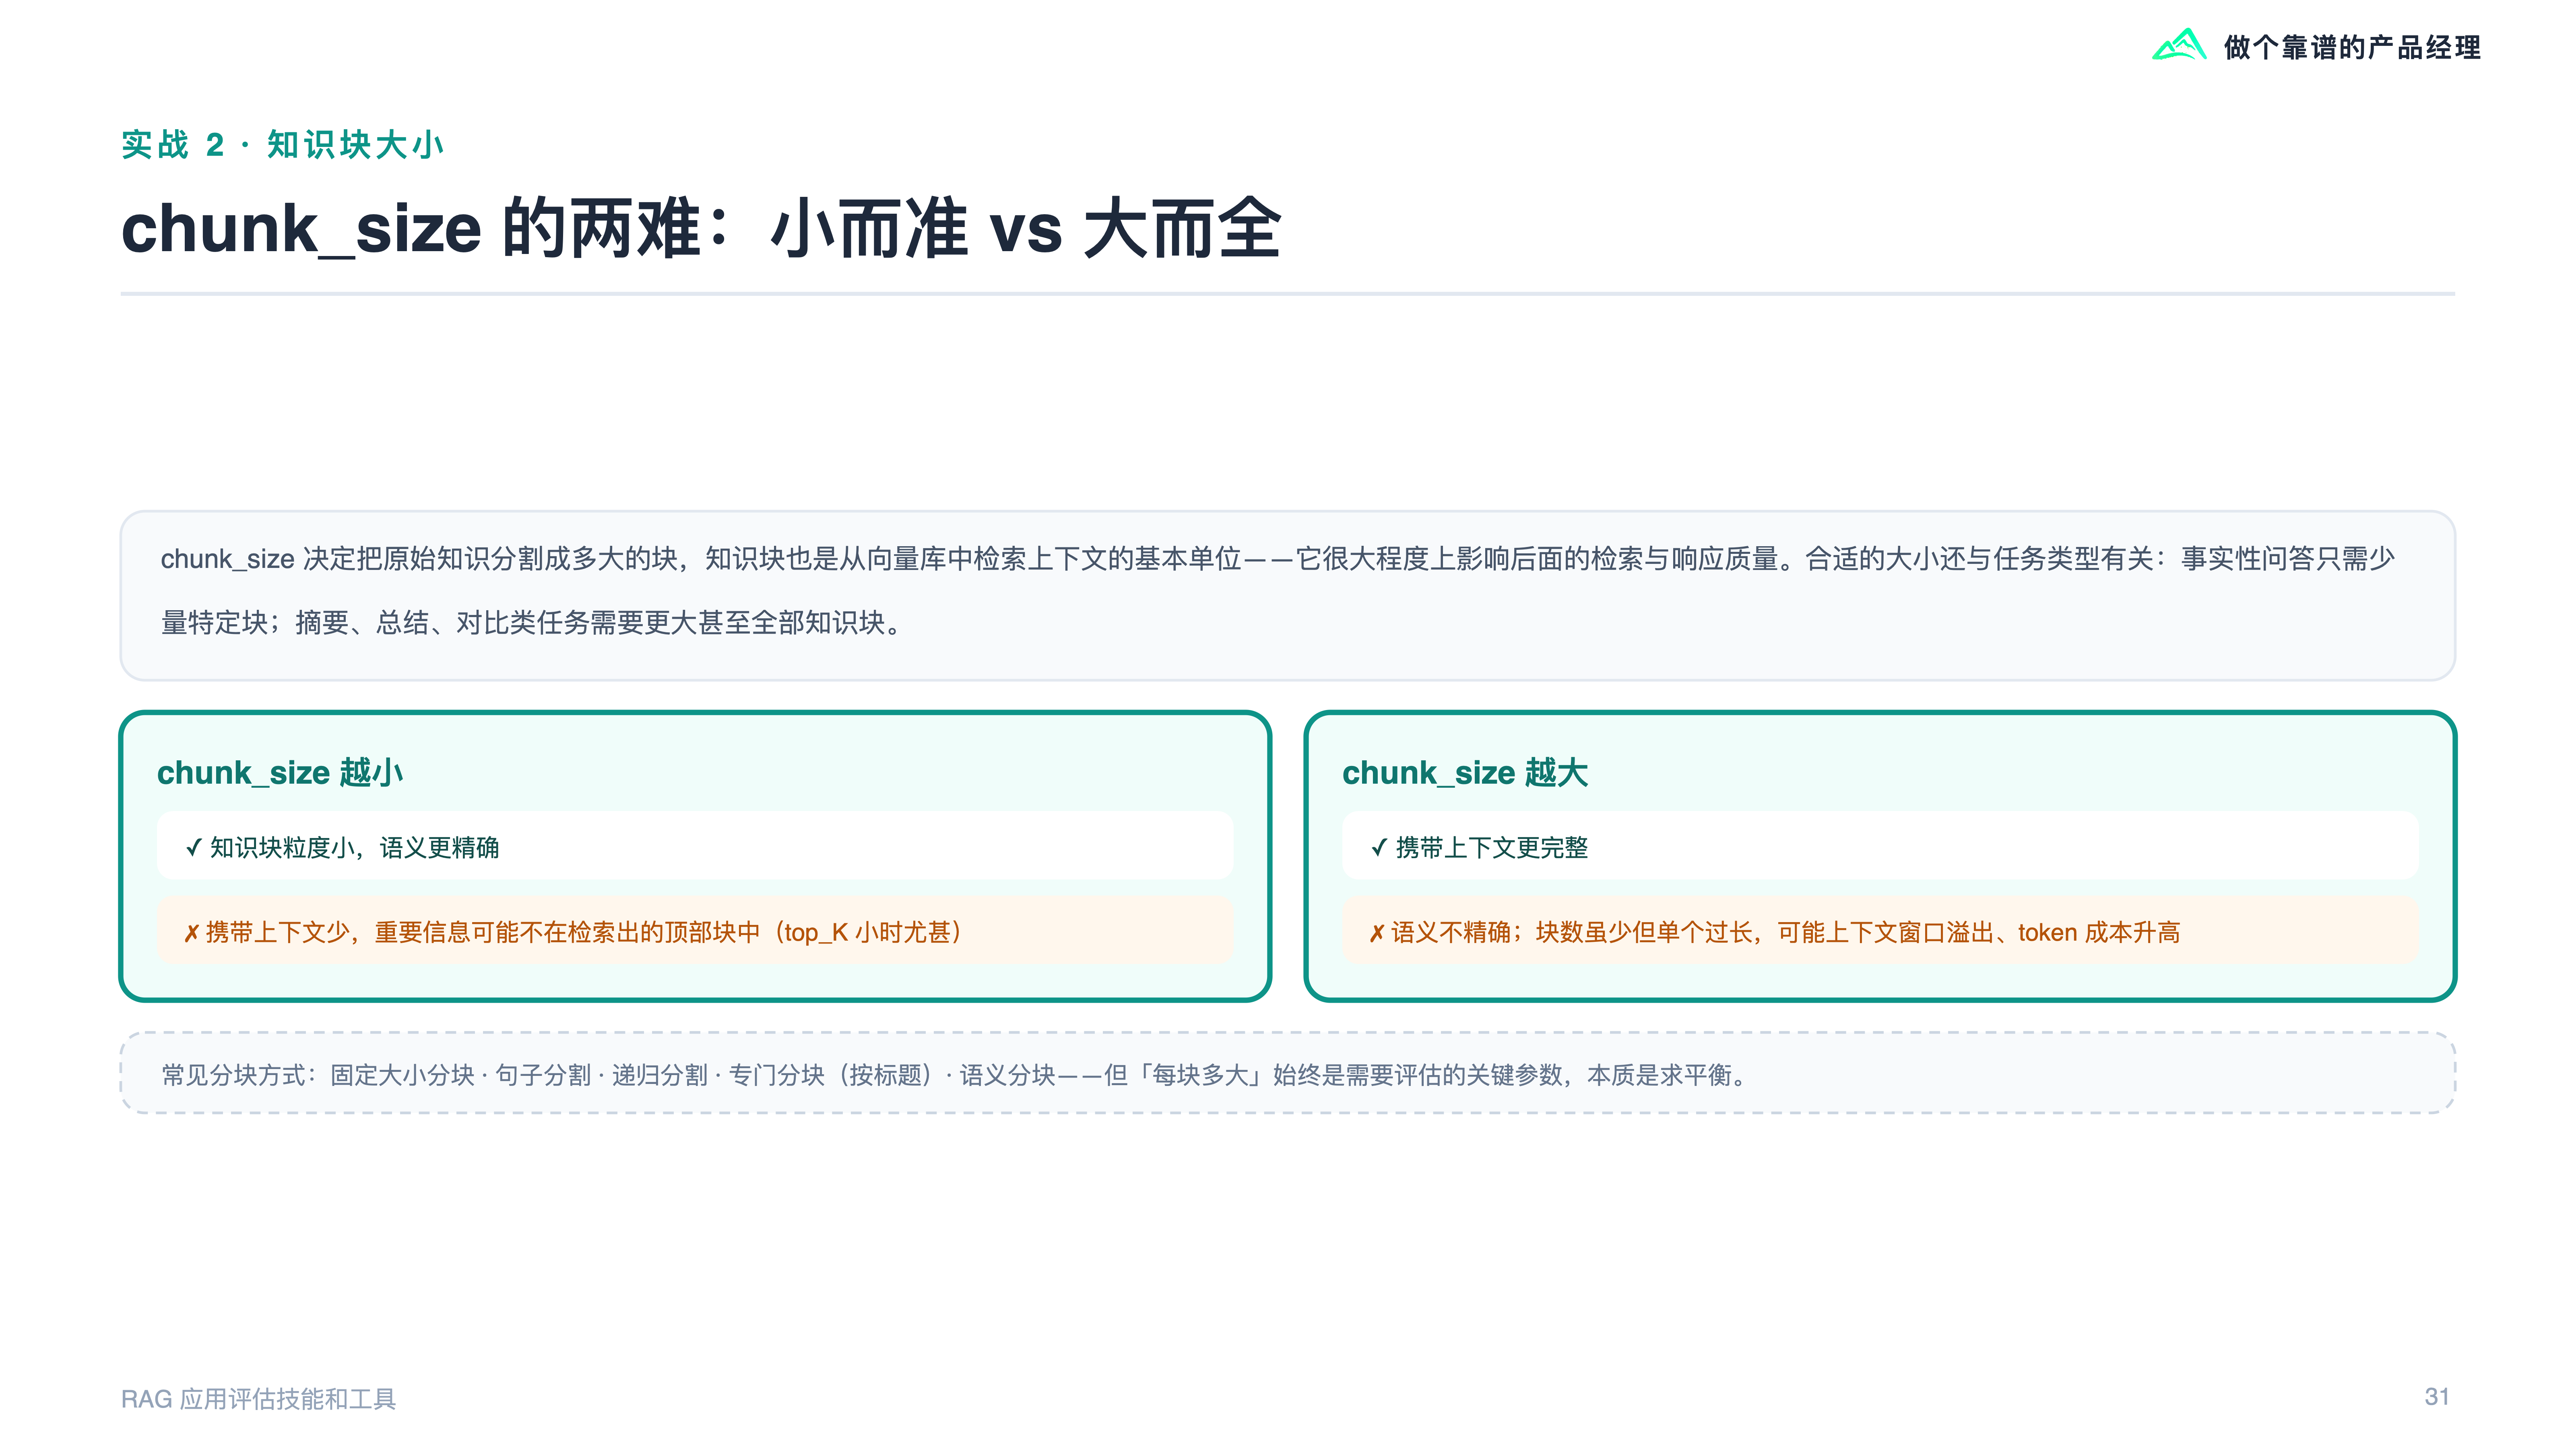
chunk_size 的两难:小而准 vs 大而全
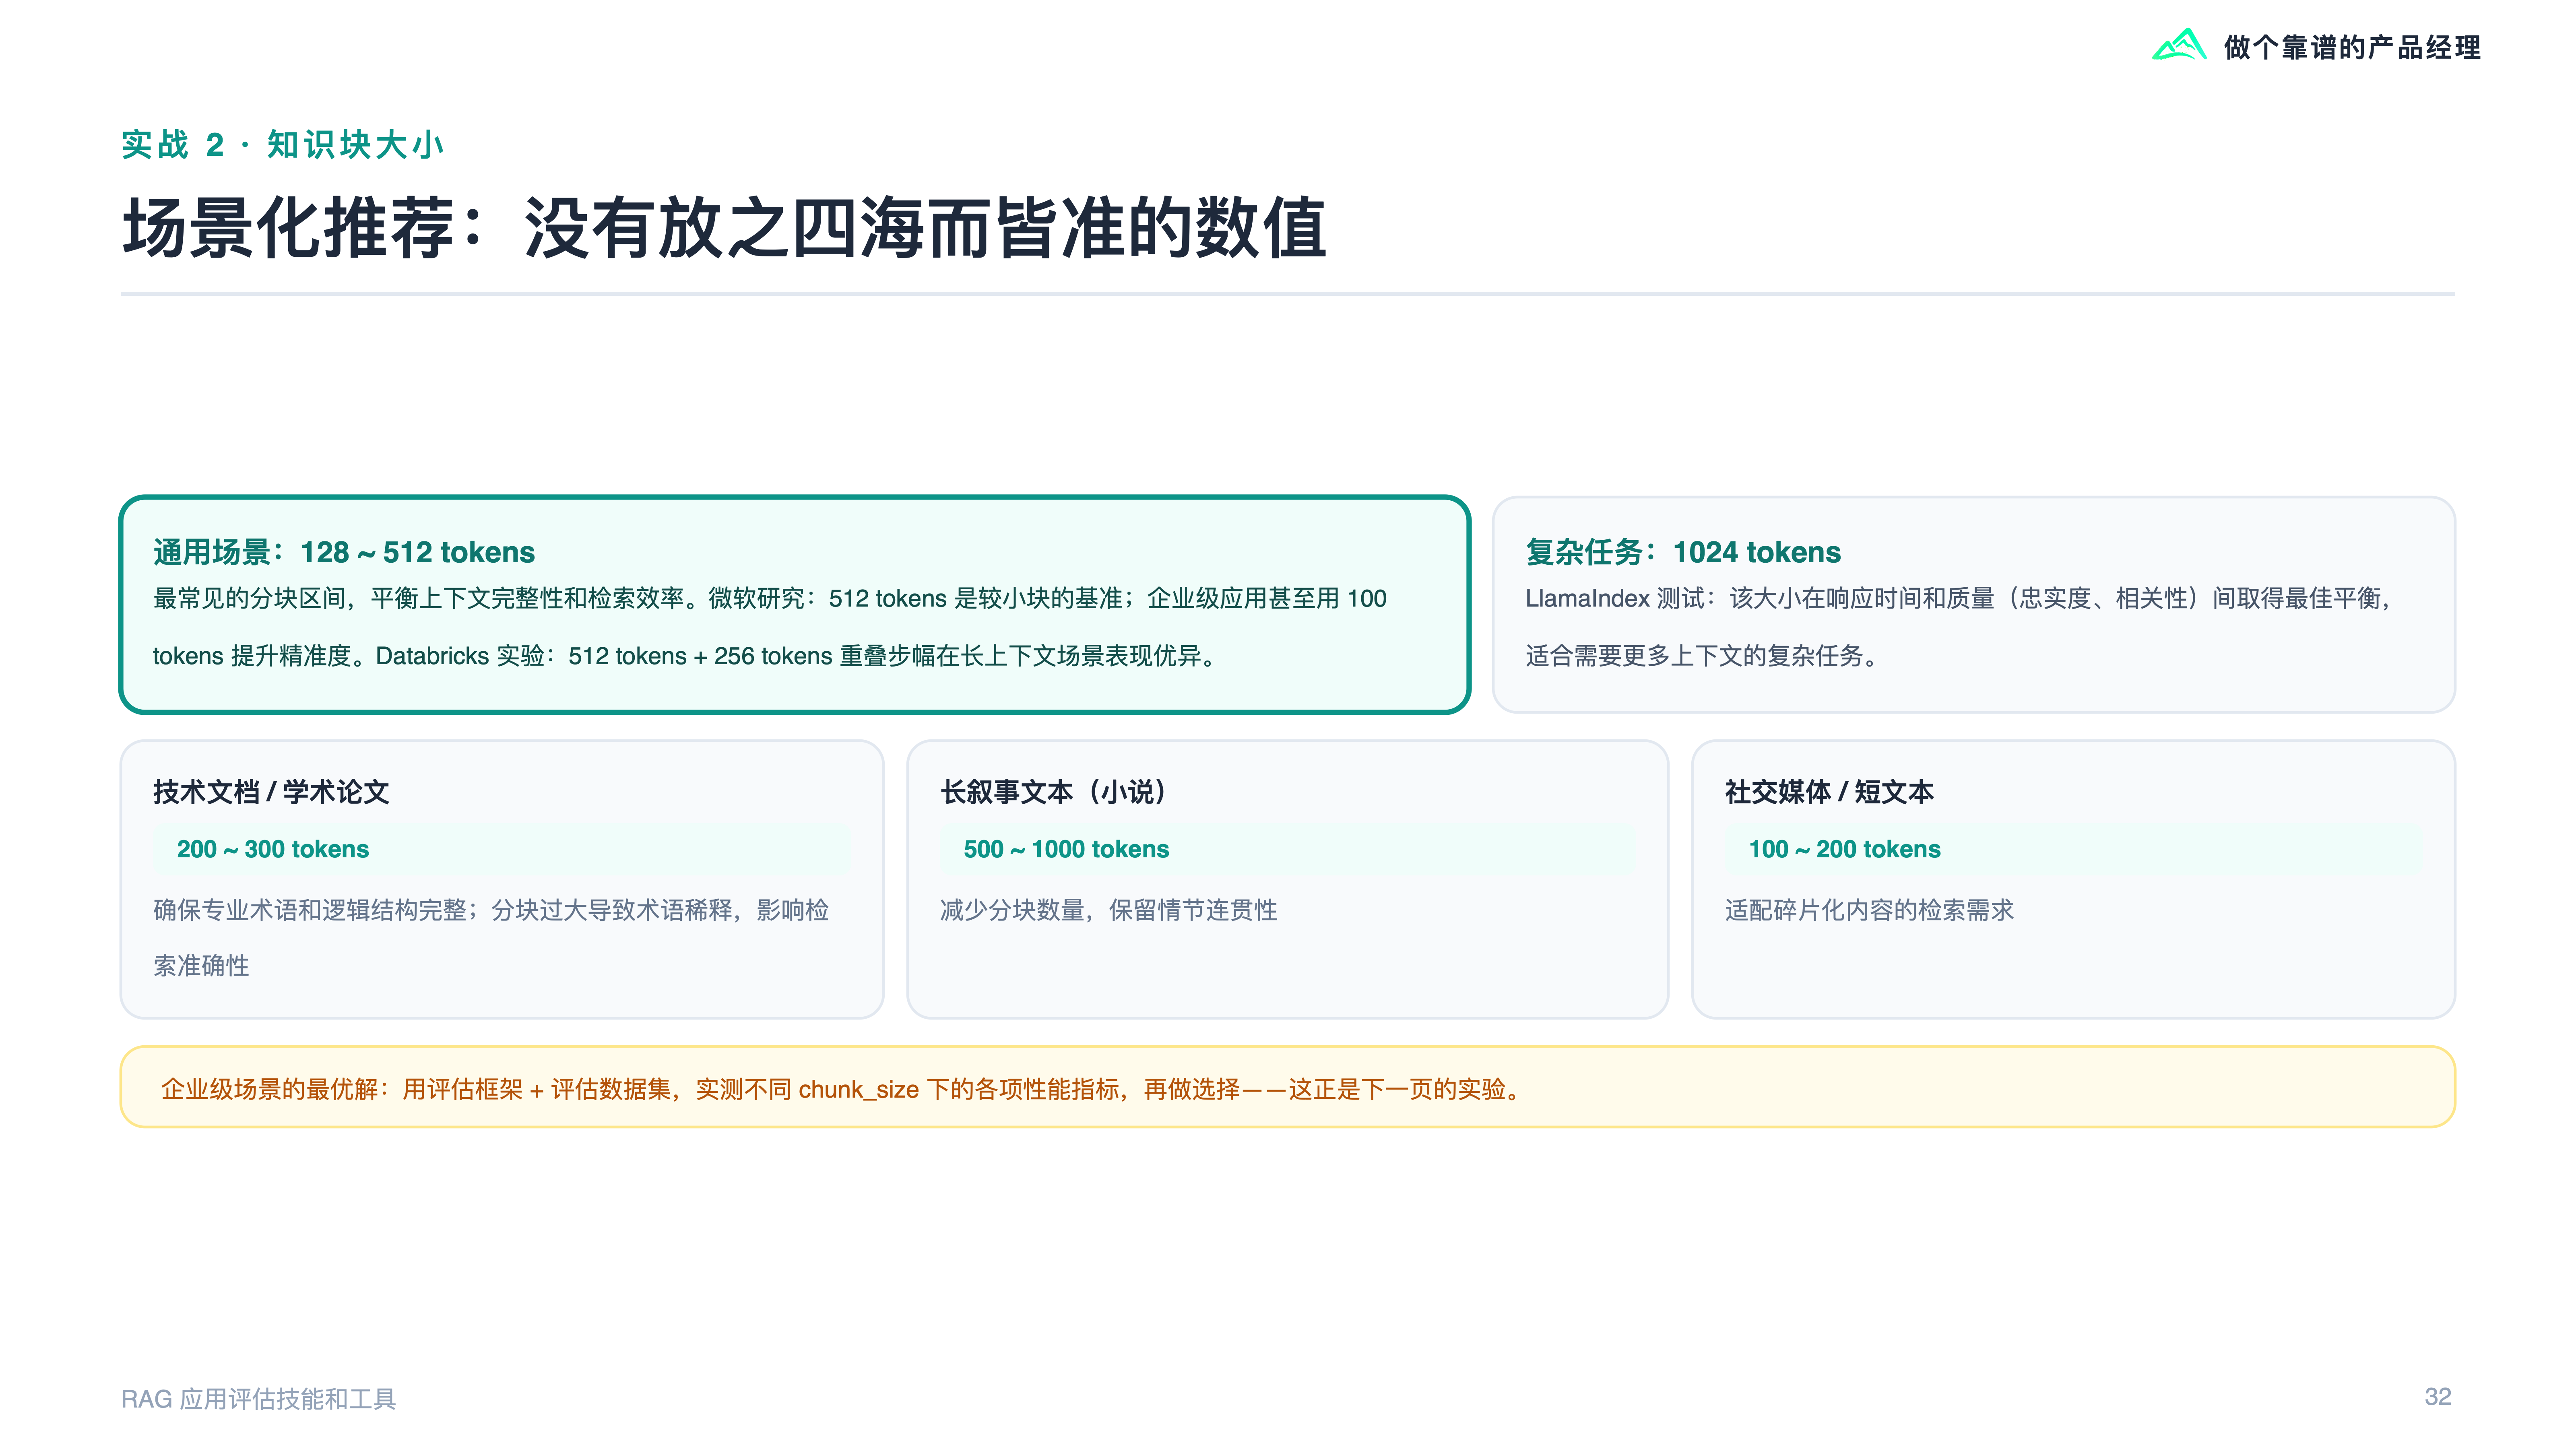
场景化推荐:没有放之四海而皆准的数值
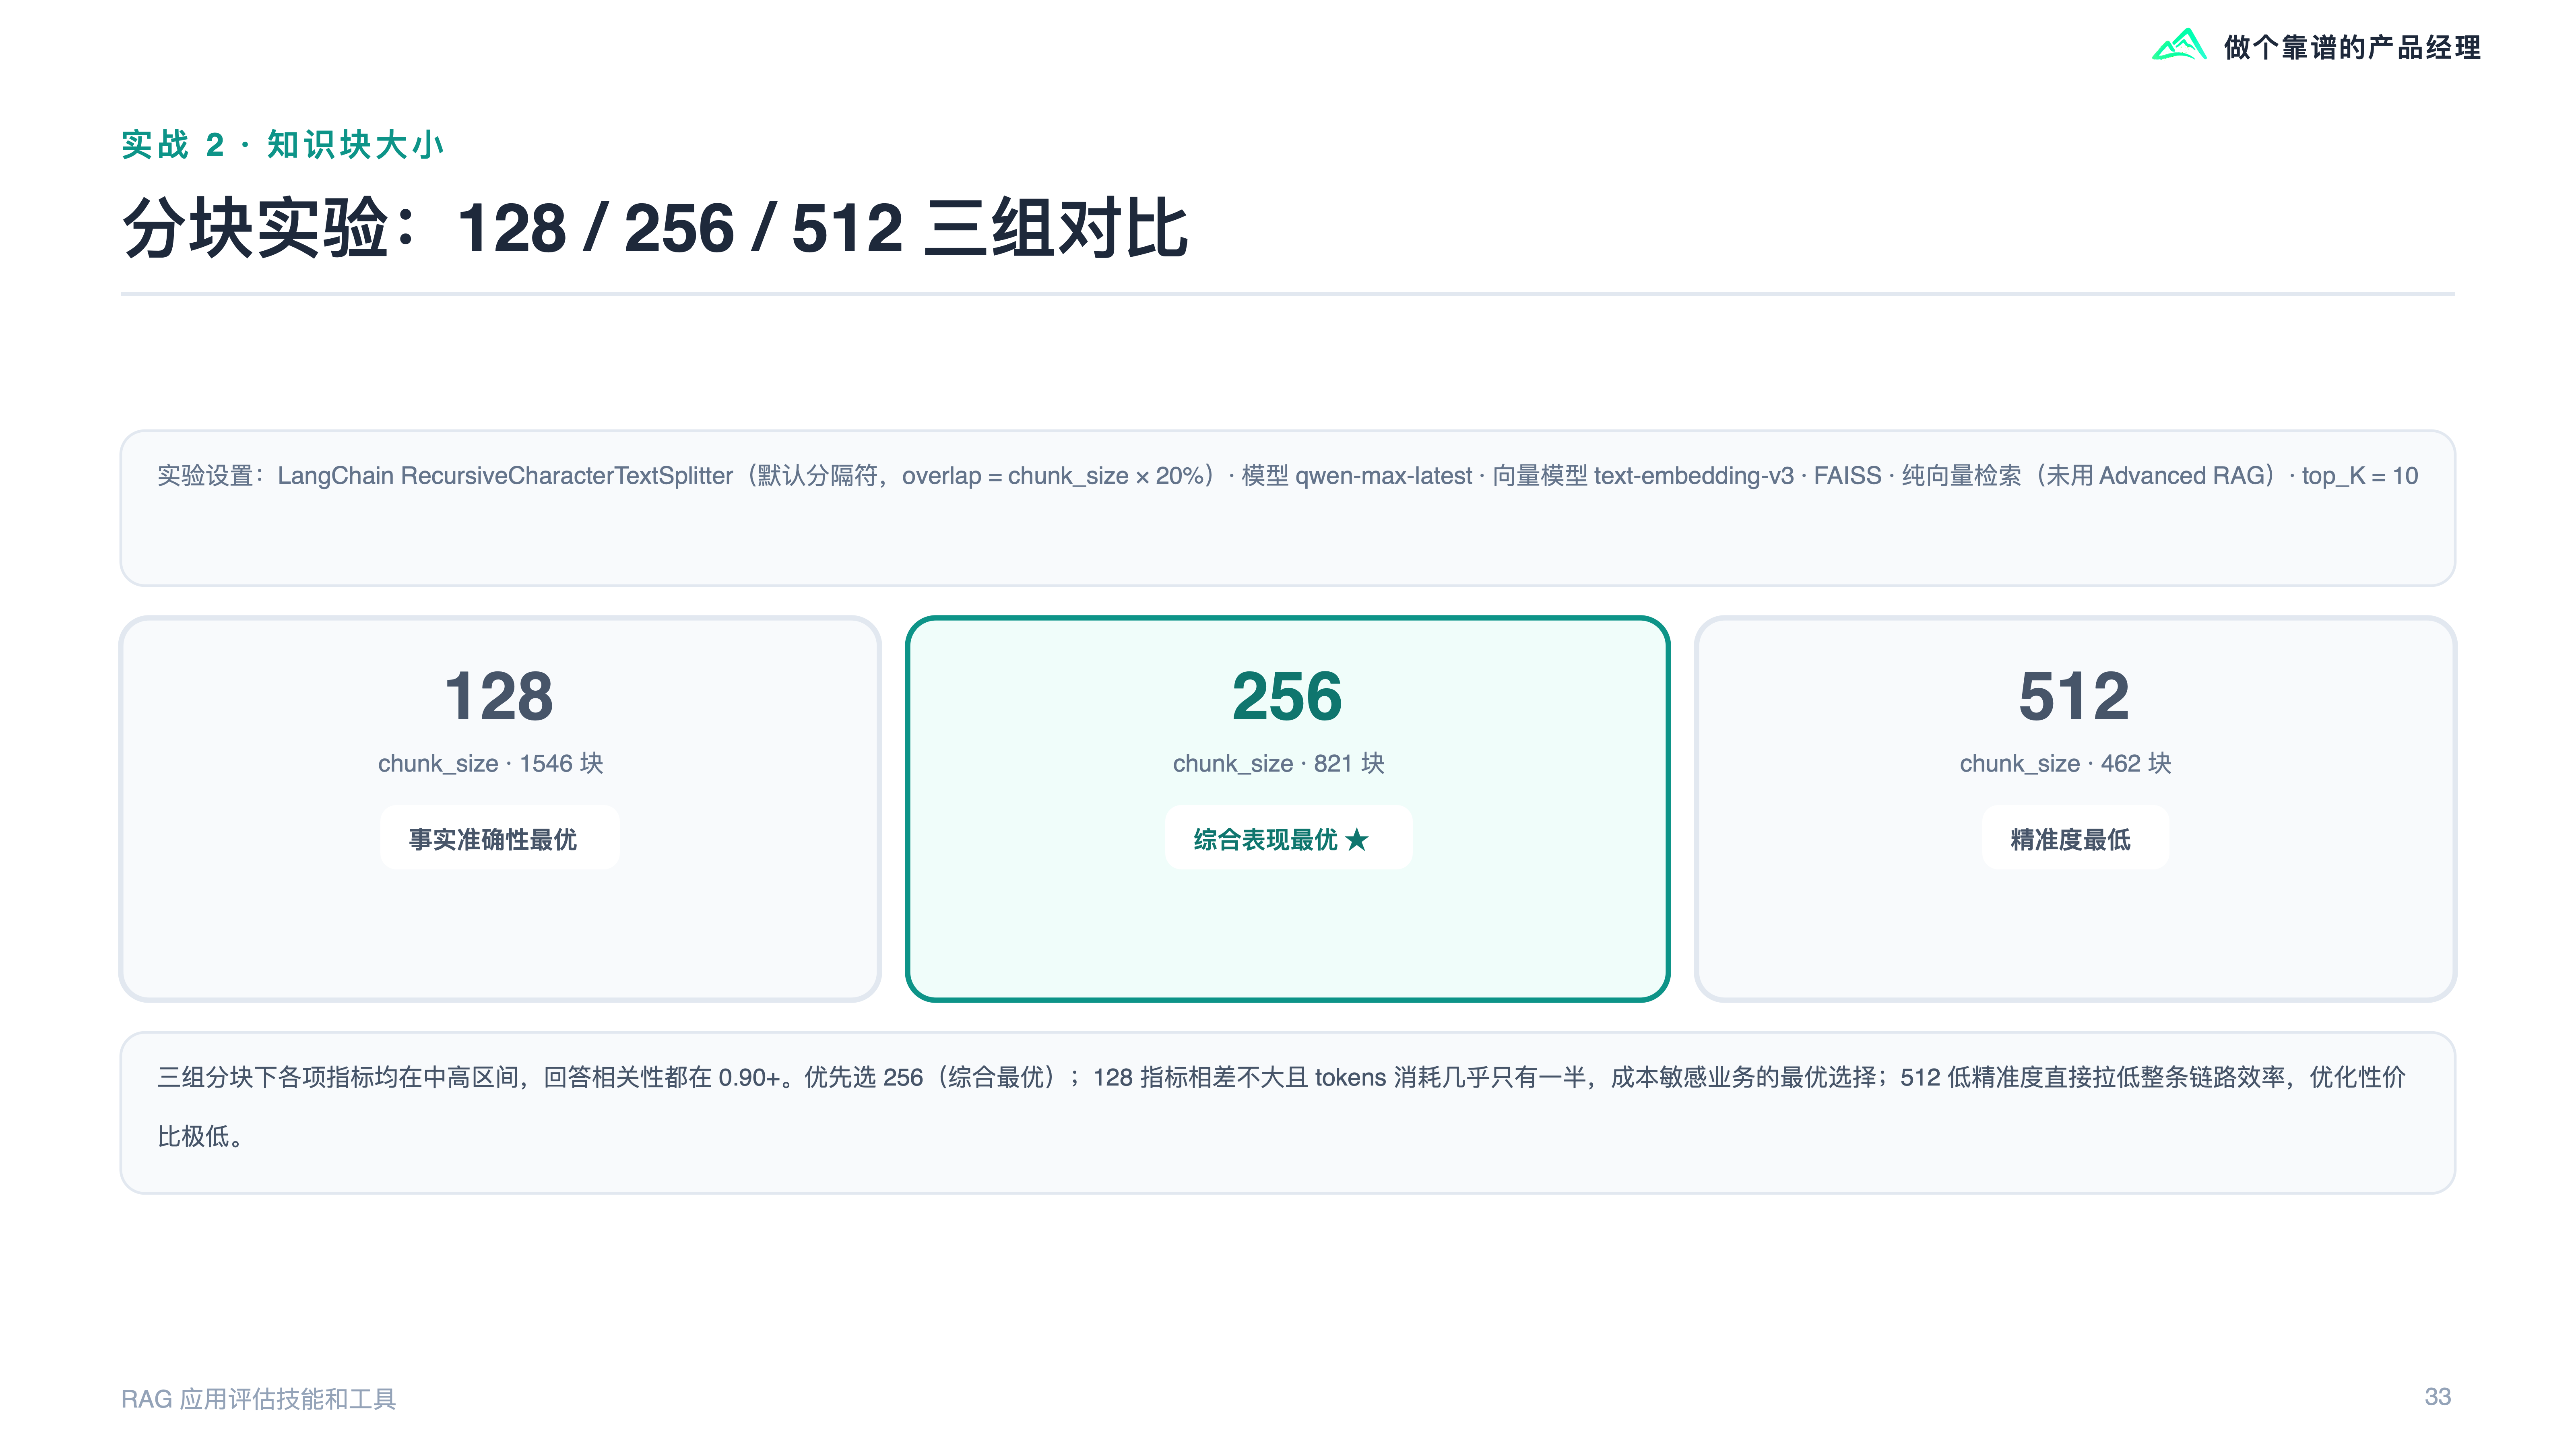
分块实验:128 / 256 / 512 三组对比
5
2023 全球智能汽车 AI 挑战赛
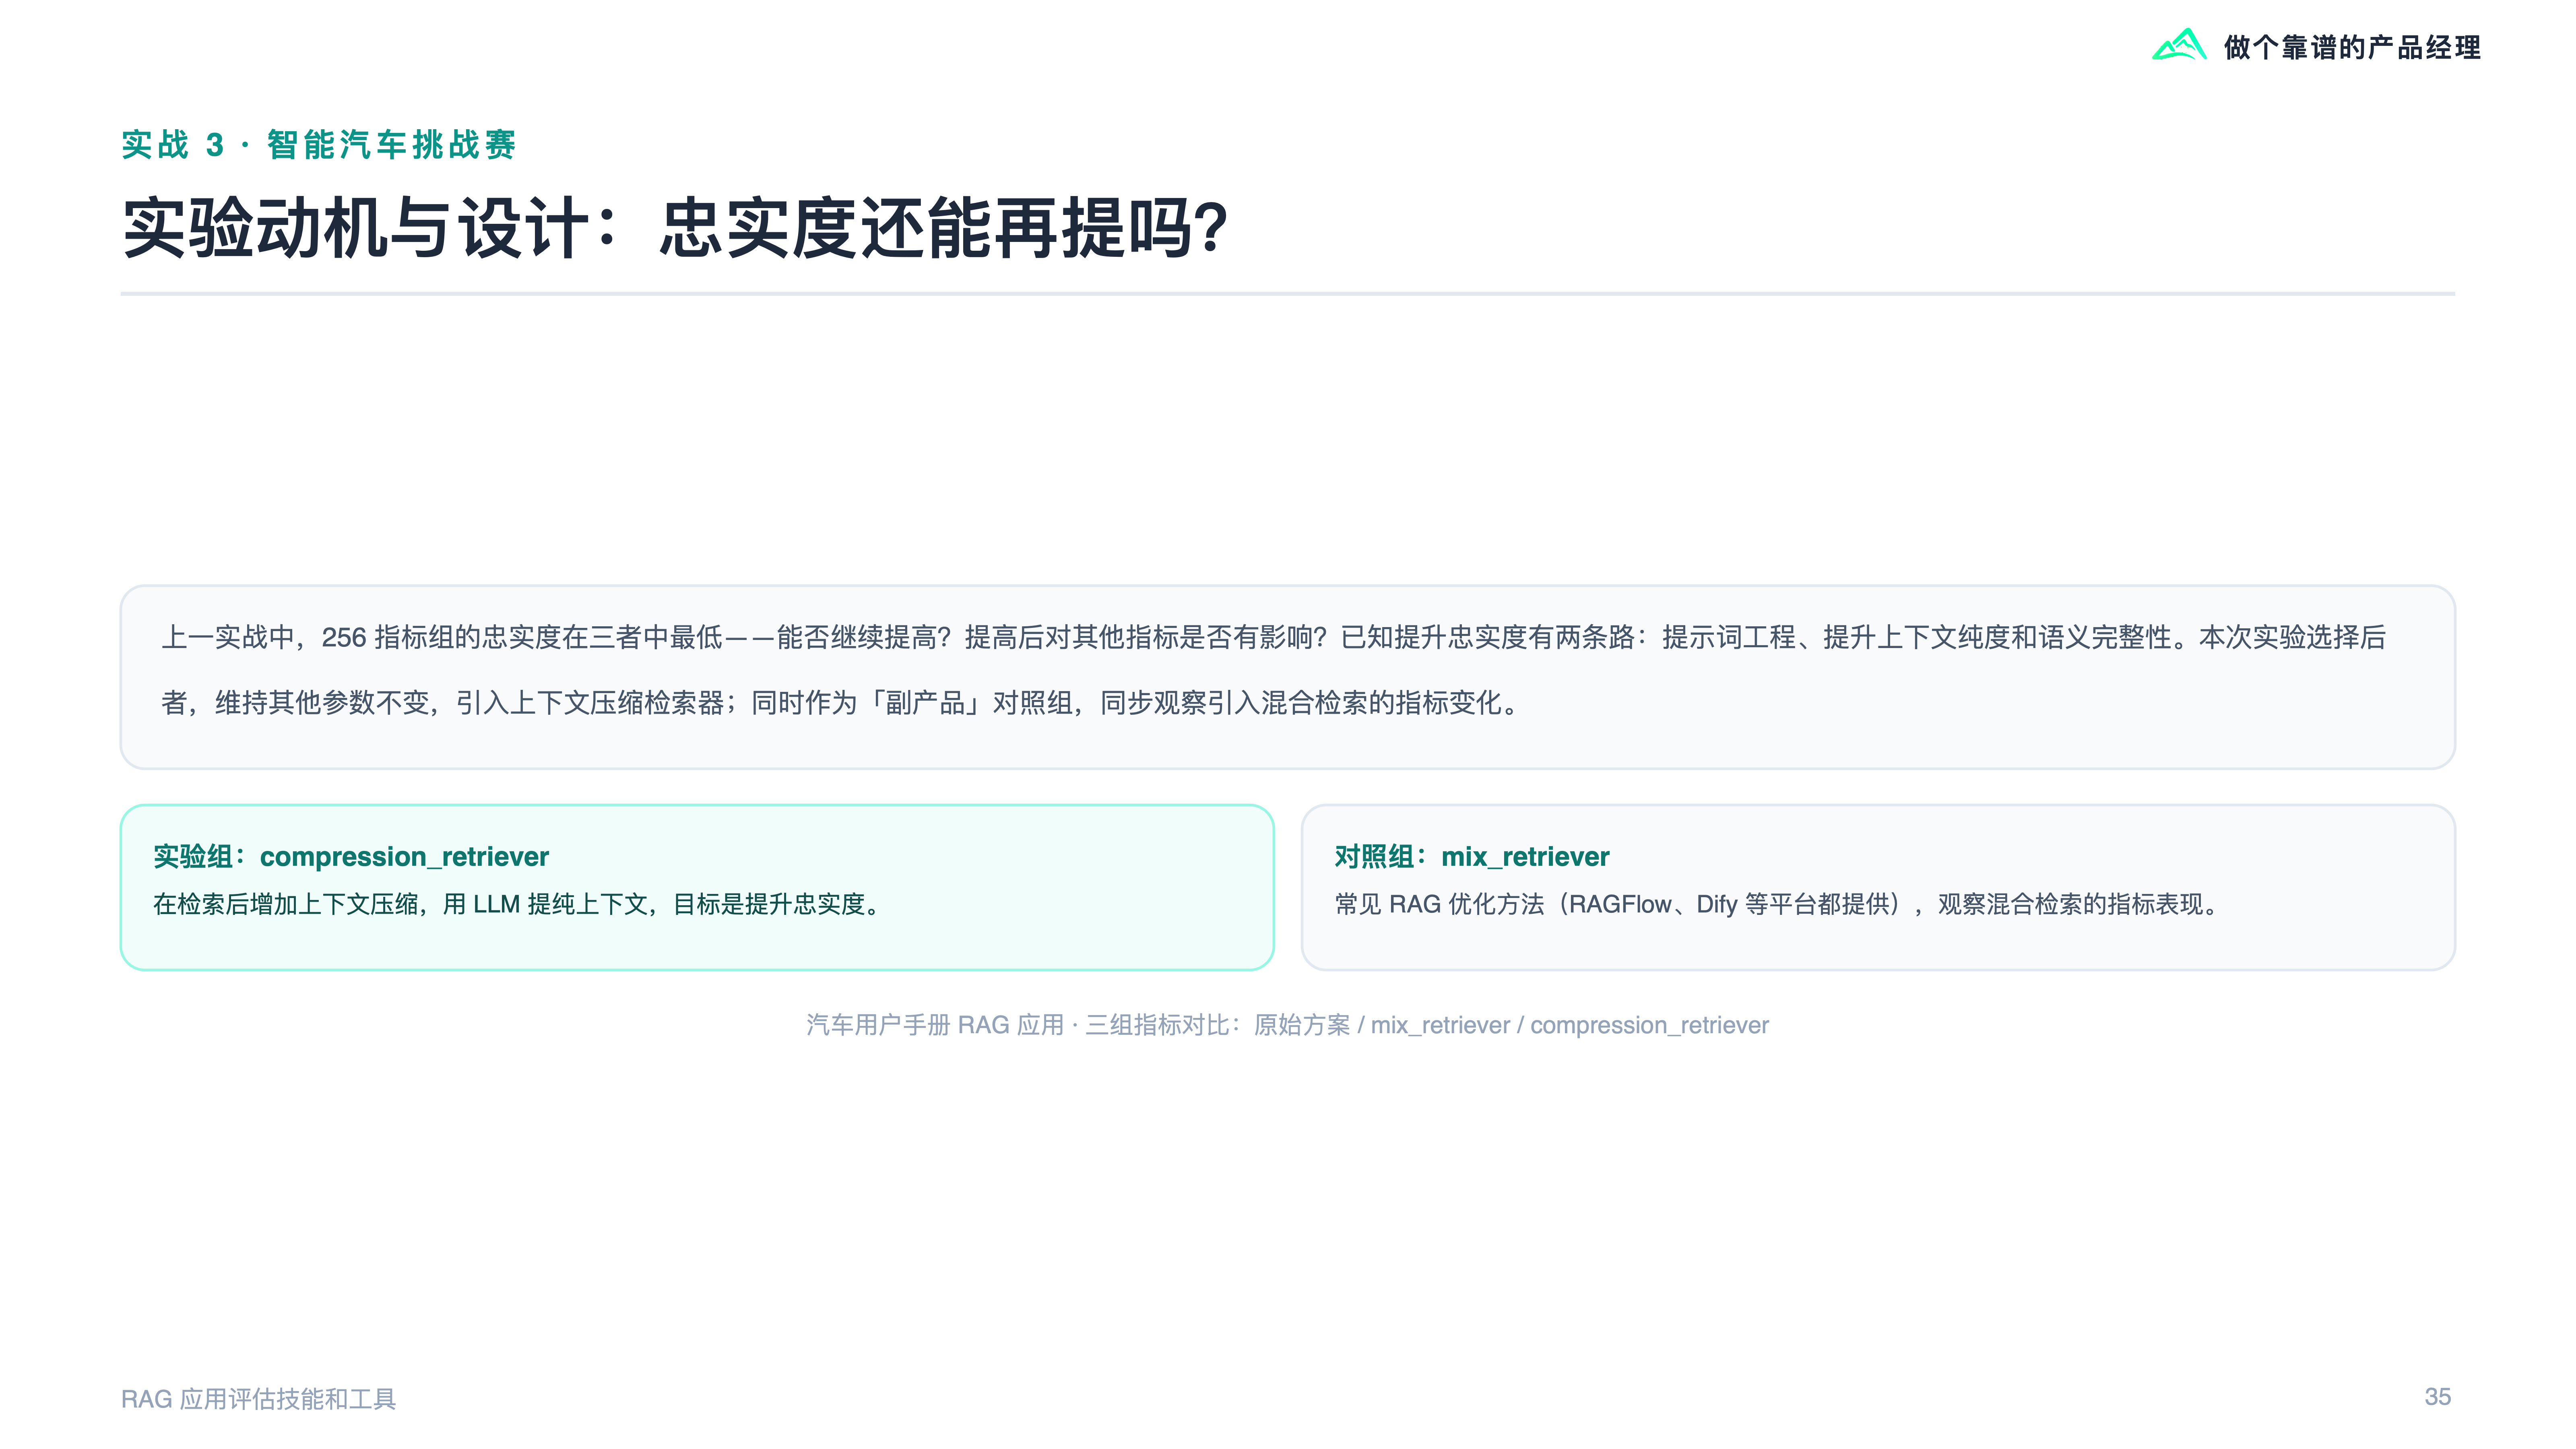
实验动机与设计:忠实度还能再提吗?
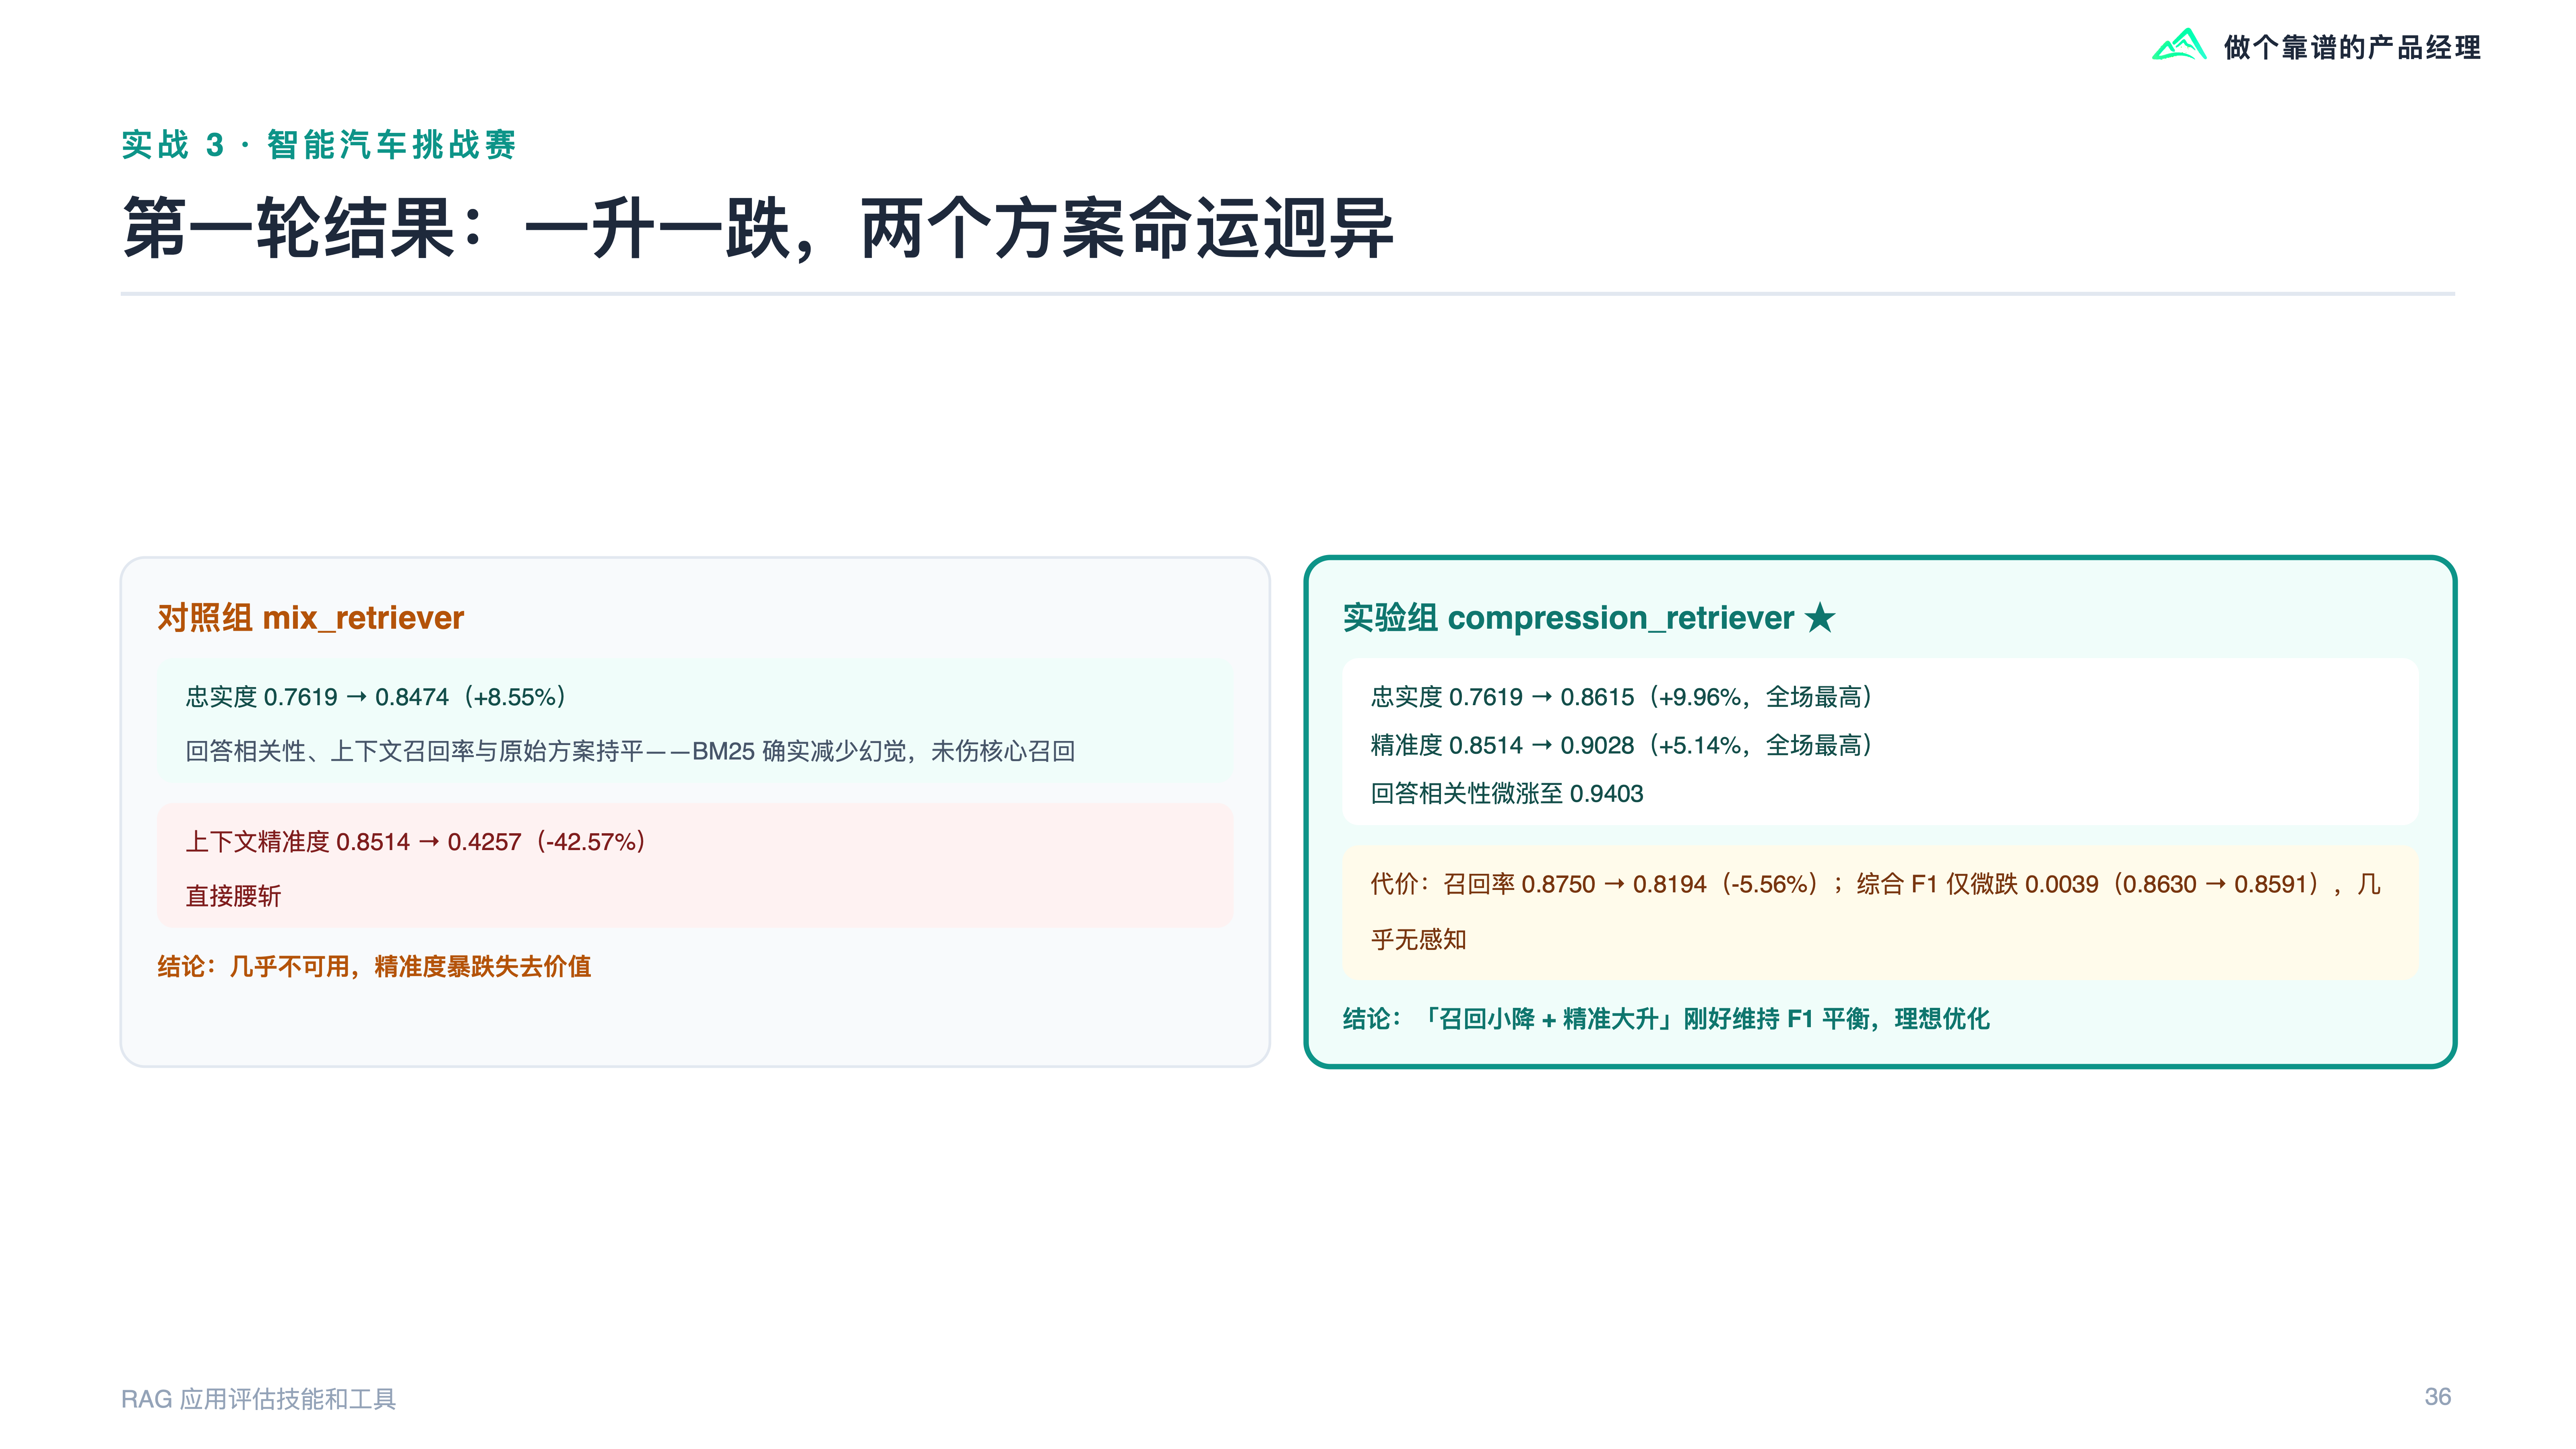
第一轮结果:一升一跌,两个方案命运迥异
第二轮:mix_retriever 翻盘记
课后作业:亲手试两个参数
相关文章